DNS o registro de servicios: la regla que evita caches rotos
En pocas palabras: Los nombres estables y la evidencia de propiedad de dominio van en registros DNS (Cloudflare DNS, Route 53, DNSimple), mientras que la ubicación de instancias que cambia con cada deploy va en un registro de servicios como Consul, AWS Cloud Map o el DNS interno de Kubernetes. Mezclar ambos usos en el mismo nombre convierte una caché de resolver en estado de despliegue accidental.
Ejemplo hipotético. Imaginá una plataforma ficticia de integraciones, llamémosla “Andes API”, que ofrece onboarding self-service a sus clientes. Para activar una cuenta, le pide al cliente que publique un registro TXT de verificación en su propia zona DNS; una vez confirmado ese registro, Andes API considera al cliente “verificado” y empieza a enrutar tráfico hacia su entorno. Ese entorno, mientras tanto, corre sobre una flota de instancias que entran y salen con cada deploy, varias veces por semana. Si alguien en Andes API decidiera reutilizar el mismo nombre DNS para las dos cosas —probar que el cliente es dueño del dominio y apuntar a la instancia activa del momento— cada rollout dejaría, durante un rato, resolvers repartidos por internet devolviendo la dirección de una instancia que ya no existe. Y si un ingeniero de guardia tuviera que tocar ese mismo registro para resolver un incidente de rollout, estaría editando sin querer la prueba de propiedad que el cliente publicó meses atrás. Ese es, en esencia, el problema que describe un análisis técnico publicado en dev.to: dos ciclos de vida distintos compitiendo por el mismo nombre.
En este artículo:
- En 30 segundos
- La diferencia real entre DNS y un registro de servicios
- ¿Por qué el caché de DNS no coordina bien con topología que cambia rápido?
- El flujo de verificación de dominio en tres pasos, sin cruzar límites
- Checklist antes de crear un registro nuevo
- Cloudflare DNS, Route 53 y DNSimple: nombres durables, no topología
- Consul, AWS Cloud Map y Kubernetes: tres formas de resolver topología dinámica
- Qué límites tiene esta separación
- Errores comunes al mezclar DNS y registro de servicios
- Preguntas frecuentes
- Conclusión
- Fuentes
En 30 segundos
- DNS es para nombres estables y evidencia de propiedad de dominio; el registro de servicios es para membresía de instancias que cambia con cada deploy.
- Ningún TTL, por bien calculado que esté, coordina a todos los resolvers, cachés locales y clientes al mismo tiempo: eso ya lo asumen los diseños de RFC 1034 y 1035.
- El flujo de verificación de dominio recomendado tiene tres pasos: la plataforma entrega un valor, el cliente lo publica en su zona, la plataforma lo verifica.
- Cloudflare DNS, Route 53 y DNSimple sirven para nombres durables, pero ninguno reemplaza a un registro para topología que cambia con el deploy.
- Consul, AWS Cloud Map y Kubernetes Services/EndpointSlices resuelven el mismo problema (membresía dinámica) con límites administrativos distintos.
La diferencia real entre DNS y un registro de servicios
La diferencia central no es técnica sino de frecuencia de cambio: DNS sirve para lo que se mantiene estable durante meses; el registro de servicios, para lo que cambia en cada despliegue. Es una regla simple de enunciar, pero se vuelve incómoda de sostener cuando el onboarding de un cliente y el rollout de infraestructura conviven en el mismo sistema de nombres, como en el ejemplo de Andes API.
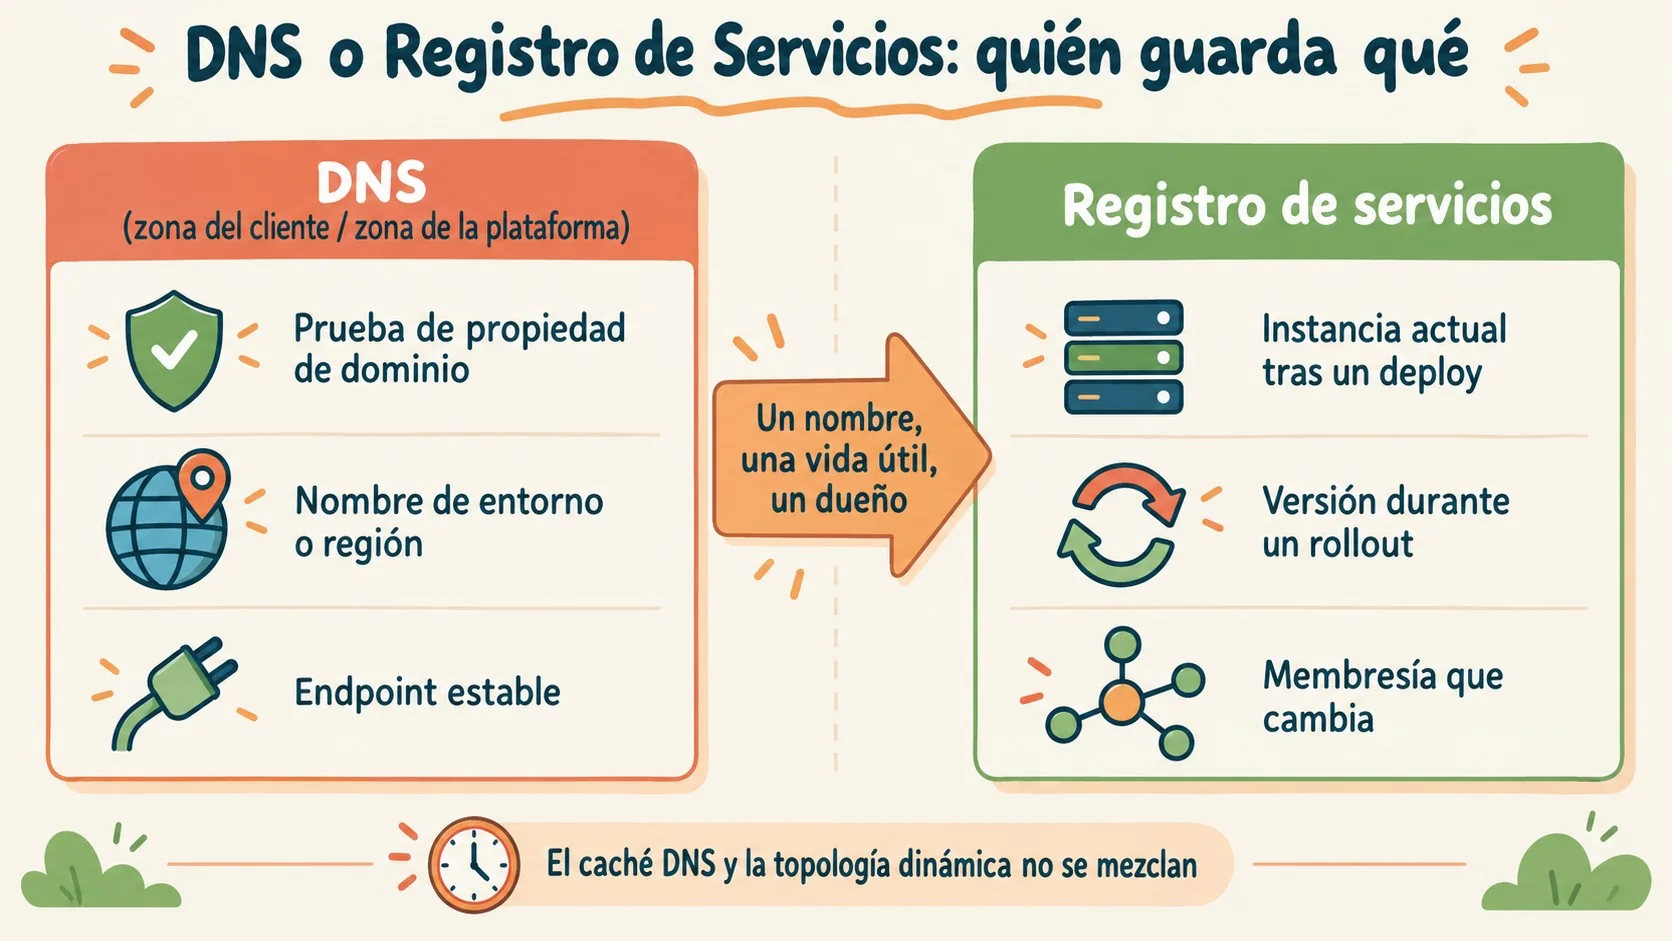
Cuatro necesidades típicas ayudan a trazar la línea. Probar propiedad de dominio va en DNS: el cliente publica un registro challenge en su zona propia y la plataforma lo verifica, sin que el registro de servicios tenga ningún rol acá. Nombrar un entorno o región también va en DNS, como alias estable de un endpoint. Encontrar la instancia actual después de un deploy va al registro, no a un nombre DNS que se actualiza cada vez que cambia la topología. Y enrutar una versión durante un rollout también va al registro, evitando la tentación de crear hostnames versionados.
El problema aparece cuando una sola entrada cumple dos funciones a la vez: evidencia de onboarding y ubicación de instancia. Ese nombre termina cambiando seguido y, al mismo tiempo, cargando el peso de una prueba de propiedad de dominio que debería quedar quieta. El resultado, en un incidente real, es una línea de tiempo difícil de leer: nadie puede decir con certeza si un registro cambió porque el cliente movió su dominio o porque hubo un deploy.
¿Por qué el caché de DNS no coordina bien con topología que cambia rápido?
El diseño mismo del DNS explica el problema. RFC 1034 describe el TTL como una negociación entre quien distribuye un dato y quien lo cachea: el distribuidor fija el tiempo de expiración, y el receptor es responsable de refrescarlo cuando ese tiempo vence. Es un mecanismo pensado, según el propio RFC, para datos que “cambian muy lentamente” y que, como mucho, admite subconjuntos que cambien “del orden de segundos o minutos” bajo condiciones especiales. No fue diseñado como plano de control para topología que rota en cada deploy, y ahí está la raíz del conflicto: no es que el TTL esté mal configurado, es que el modelo entero de refresco distribuido asume otra escala de cambio.
Llevado a un rollout: la instancia vieja se apaga, la nueva queda lista, y en algún punto de la red un resolver sigue devolviendo la respuesta que cacheó minutos antes. Un registro de servicios puede reflejar la baja y el alta casi de inmediato porque no depende de que terceros refresquen una caché por su cuenta; el DNS, en cambio, depende exactamente de eso. Si la misma entrada DNS carga también la evidencia de onboarding del cliente, un nombre que cambia seguido termina con dos responsabilidades de vidas útiles incompatibles.
La recomendación práctica es simple de enunciar y más difícil de sostener sin disciplina: la entrada de propiedad tiene que ser aburrida —se crea, se verifica, y su significado no se toca nunca más—. Región, entorno y endpoints durables también son buen material para DNS. La membresía de instancias, no. Escribí ese límite en una política de nombres, porque una convención no documentada termina, tarde o temprano, en un hostname con la versión metida adentro, tipo api-v17, que se ve prolijo el día del lanzamiento y seis meses después es un problema de certificados, borrado y documentación que nadie quiere tocar.
El flujo de verificación de dominio en tres pasos, sin cruzar límites
Volviendo al caso de Andes API: la forma de mantener separada la evidencia de propiedad del descubrimiento en tiempo de ejecución es un flujo corto. La plataforma entrega un valor de verificación, el cliente lo publica en su propia zona DNS, y la plataforma lo verifica antes de completar el onboarding. El descubrimiento de servicios en runtime sigue un camino totalmente independiente de esa prueba: puede seguir rotando instancias sin que eso afecte ni un bit del registro de verificación.
El cliente retiene el control del límite de propiedad de su zona. La plataforma retiene control de la suya y puede darle nombres estables a entornos o regiones sin necesidad de reflejar cada evento de deploy en el DNS del cliente. Si un rollout necesitara tocar ese registro de verificación, ahí es exactamente donde se cruzaron los límites que no debían cruzarse.
Checklist antes de crear un registro nuevo
Además del criterio de “qué evento dispara el cambio”, conviene hacerse tres preguntas concretas antes de decidir dónde va un nombre nuevo:
- ¿Qué evento dispara el cambio de este nombre? Si la respuesta es “un deploy”, casi seguro no es DNS. Si es “el cliente cambió de dominio” o “abrimos una región”, DNS está haciendo el trabajo para el que fue pensado.
- ¿Quién necesita reconocer este nombre? Un humano leyendo documentación o un proceso de verificación de dominio son candidatos naturales a DNS. Un balanceador interno resolviendo la instancia activa del momento, casi siempre pertenece al registro.
- ¿Qué pasa si un resolver devuelve una respuesta vieja por un minuto? Si la respuesta es “nada grave”, un TTL corto alcanza. Si la respuesta es “tráfico dirigido a una instancia que ya no existe”, el problema no se resuelve bajando el TTL: hace falta un registro con chequeos de salud diseñado para ese tipo de cambio.
Cloudflare DNS, Route 53 y DNSimple: nombres durables, no topología
La elección entre proveedores DNS suele depender de dónde ya viven la cuenta y los permisos, no de cuál tiene más funciones. Los tres sirven para nombres durables y evidencia de propiedad; ninguno resuelve por sí solo topología que cambia con el deploy.
| Opción DNS | Elegila cuando | Límite a aceptar |
|---|---|---|
| Cloudflare DNS | La zona y sus controles operativos ya viven ahí | Mantener la membresía de despliegue fuera de registros orientados al cliente |
| Amazon Route 53 | Cuentas, permisos y zonas hospedadas ya están centrados en AWS | No confundir registros DNS con un registro que cambia rápido |
| DNSimple | Las operaciones de dominio y DNS ya viven en esa cuenta | La salud de instancias en runtime sigue perteneciendo a otro sistema |
Si la necesidad real es gestionar registros y zonas dentro de un proveedor ya establecido, cualquiera de estas opciones cumple. El punto ciego aparece cuando se les pide que también resuelvan membresía dinámica: para eso hace falta otra pieza.
Consul, AWS Cloud Map y Kubernetes: tres formas de resolver topología dinámica
La elección de registro de servicios depende sobre todo de quién opera el límite de runtime, no de qué producto tiene mejor marketing.
- HashiCorp Consul: tiene sentido cuando el equipo quiere servicios registrados y descubrimiento consciente de la salud a través de todo su entorno gestionado. Según la documentación oficial de Consul, el catálogo registra la dirección de cada nodo de servicio y actualiza esa entrada con los resultados de cada chequeo de salud, replicando esa información entre agentes con el protocolo de consenso Raft para lograr alta disponibilidad. El costo: agrega un control plane adicional que hay que operar y gobernar.
- AWS Cloud Map: encaja cuando los recursos ya viven representados dentro de un modelo de cuenta y región de AWS. Acopla el descubrimiento a conceptos y permisos de AWS, así que si el workload ya está ahí, suma; si no, agrega una capa de acoplamiento innecesaria.
- Kubernetes Services y EndpointSlices: el ajuste natural para pods y servicios cuya membresía cambia con los rollouts del propio clúster. El límite a cuidar: el descubrimiento del clúster no debería convertirse en el mecanismo de propiedad de dominio del cliente.
La regla común importa más que la etiqueta del producto: si la membresía cambia con un deploy, se actualiza el registro, no un nombre DNS orientado a humanos. El DNS puede seguir siendo la puerta de entrada estable; el registro rastrea qué hay detrás en cada momento.
Qué límites tiene esta separación
Esta separación no elimina el caching: las respuestas DNS estables se siguen cacheando, y las aplicaciones también pueden cachear resultados del registro de servicios. Lo que cambia es qué modo de falla resulta aceptable en cada caso.
Nombres durables pueden converger vía DNS sin drama, porque el propio modelo de refresco distribuido de RFC 1034 y 1035 está pensado para eso. Membresía que cambia rápido necesita un mecanismo de descubrimiento diseñado alrededor de ese cambio, no un TTL cada vez más corto. Tampoco un registro de servicios prueba que un cliente es dueño de un dominio: esa verificación tiene que quedar en el límite de onboarding, mientras que las credenciales y la topología del registro quedan en el límite de runtime.
Un nombre, una vida útil, un dueño claro. Antes de escribir un valor en cualquier registro, vale la pena preguntarse de qué lado de esa línea está.
Errores comunes al mezclar DNS y registro de servicios
- Meter la versión en el hostname: nombres tipo
api-v17.midominio.comparecen prolijos al lanzar, pero se vuelven una decisión de borrado, un problema de certificados y un artefacto de documentación sin dueño seis meses después. - Editar el registro de verificación durante un rollout: si el proceso de deploy toca la misma entrada DNS que se usó para probar propiedad de dominio, ya se cruzó el límite que debía mantenerse separado.
- Confiar en el TTL como plano de control: ajustar el TTL no coordina resolvers, clientes y cachés locales durante un despliegue. Esa coordinación necesita un registro diseñado para membresía dinámica, no un parámetro DNS.
- Mezclar las alertas de onboarding y de deploy: si las alertas de verificación de dominio y las de salud de despliegue viven en el mismo panel sin distinción, un cliente esperando su verificación DNS puede parecer un despliegue no saludable, y viceversa.
Preguntas frecuentes
¿Cuándo conviene usar DNS y cuándo un registro de servicios?
DNS conviene para nombres que un humano necesita reconocer o para evidencia durable de propiedad de dominio; el registro de servicios conviene cuando los targets entran y salen con cada despliegue. La regla práctica: si el evento que dispara el cambio es “un deploy”, va al registro.
¿Por qué el caché de DNS es un problema en despliegues dinámicos?
Porque el TTL depende de que cada resolver refresque su copia por su cuenta, y no hay forma de coordinar a todos al mismo tiempo. Durante el minuto en que una instancia vieja se va y una nueva queda lista, algún resolver va a seguir devolviendo la respuesta cacheada de la instancia que ya no existe.
¿Qué diferencia hay entre Consul, AWS Cloud Map y Kubernetes DNS?
Consul es un control plane de red de servicios operado explícitamente, con catálogo y chequeos de salud replicados vía Raft según su documentación oficial. AWS Cloud Map acopla el descubrimiento a conceptos y permisos de AWS. Kubernetes Services y EndpointSlices resuelven descubrimiento para pods cuya membresía cambia con los rollouts del propio clúster.
¿Se puede usar DNS para verificar la propiedad de un dominio y también para service discovery?
Se puede técnicamente, pero no conviene: mezclar ambos usos en la misma entrada le da a un nombre que cambia seguido la responsabilidad de una prueba de propiedad que debería ser estable. La recomendación es mantener la verificación de dominio en una entrada aburrida y separada del registro de instancias.
¿Qué pasa con el DNS durante un rollout cuando una instancia se cae y otra aparece?
El registro de servicios puede reflejar la baja y el alta de instancias casi de inmediato, pero la respuesta DNS cacheada sigue un reloj de expiración distinto y puede quedar desactualizada. Por eso la membresía de instancias no debería depender de un nombre DNS, sino de un registro diseñado para ese cambio.
Conclusión
La decisión de dónde poner cada dato de red no es un detalle de implementación: es una política que conviene escribir antes de que un incidente obligue a reconstruirla a los ponchazos. DNS para lo estable y la evidencia de propiedad, registro de servicios para lo que cambia con el deploy. Esa línea, bien documentada, evita que el caché de un resolver se convierta en estado de despliegue accidental.
Si estás armando o revisando tu arquitectura de descubrimiento interno, el ejercicio concreto es simple: tomá cada nombre que usás hoy y preguntate qué evento dispara su cambio. Si la respuesta involucra un deploy, movelo al registro de servicios. Si involucra un cambio de dominio o la apertura de una región, dejalo en DNS.
Fuentes
- Internal Service Discovery: DNS Records or Registry by Change Frequency — dev.to
- RFC 1034: Domain Names – Concepts and Facilities — RFC Editor
- RFC 1035: Domain Names – Implementation and Specification — RFC Editor
- Discover services overview — HashiCorp Consul Documentation