Tu factura cloud es un documento de arquitectura
En pocas palabras: Sube porque cada línea de la factura cloud refleja una decisión técnica sin revisar: compute sobredimensionado, réplicas de base de datos, snapshots acumulados o ambientes de staging corriendo 24/7. Según dev.to (3 de octubre de 2026), comparar el gasto contra uso real —usuarios activos, transacciones, GB— revela si el costo sigue teniendo dueño y justificación de arquitectura.
¿Por qué tu factura de AWS o Azure vuelve a subir sin que nadie en el equipo tenga una explicación clara? Según un análisis publicado el 3 de octubre de 2026 en dev.to, cada línea de esa factura existe porque alguien tomó una decisión técnica concreta: cuánto compute provisionar, qué tier de base de datos mantener, cuántos días retener los logs.
La optimización de costos cloud es la práctica de revisar el gasto en infraestructura (compute, storage, transferencia de datos) para confirmar qué recursos siguen activos sin justificación técnica vigente. No se trata de bajar el número de la factura a cualquier precio, sino de verificar que cada dólar gastado corresponda a una decisión de arquitectura actual y con un dueño responsable.
En este artículo:
- En 30 segundos
- ¿Por qué la factura cloud revela decisiones de arquitectura?
- ¿Cómo comparar el gasto cloud con el uso real del negocio?
- Infraestructura idle: ¿por qué sigue existiendo lo que ya no se usa?
- Sobreprovisión de recursos: ¿cuándo el margen de seguridad se vuelve permanente?
- Almacenamiento, migraciones y entornos de no producción: ¿dónde se acumulan los costos olvidados?
- Checklist práctico para auditar la factura cloud como documento de diseño
- Errores comunes al auditar el gasto cloud
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La factura cloud no es solo un número financiero: es evidencia de decisiones de arquitectura, réplicas de base de datos, snapshots y ambientes duplicados incluidos.
- Comparar gasto contra uso real (usuarios activos, transacciones, GB) es más útil que mirar el total: eficiencia cloud = uso de negocio / costo de infraestructura.
- La mayoría del desperdicio empieza como una decisión válida (instancia de lanzamiento, cluster de testing) que queda sin dueño después de cumplir su propósito.
- Las migraciones dejan infraestructura fantasma: entornos viejos, backups duplicados y rollback que nadie decomisiona después del go-live.
- Programar horarios de apagado en entornos de staging y QA que corren 24/7 con tamaño de producción es, según el análisis citado, una de las formas menos riesgosas de reducir el gasto cloud.
¿Por qué la factura cloud revela decisiones de arquitectura?
La factura cloud revela decisiones de arquitectura porque cada cargo recurrente existe gracias a una elección técnica u operativa tomada en el pasado. Un diagrama muestra la estructura que se pensó. La factura muestra lo que esa estructura cuesta en producción real, con todos los ajustes y parches que se fueron acumulando por el camino.
Tomá el caso de una caja en el diagrama que dice simplemente “base de datos”. Suena simple. Pero la factura puede mostrar un tier administrado grande, múltiples réplicas, backups automáticos, storage de snapshots, transferencia de datos y monitoreo adicional. Eso no es solo costo: es evidencia de decisiones de diseño que en el papel nunca se vieron.
Lo mismo pasa con el compute. Si el bill sube, hay varias explicaciones posibles: el tráfico creció de verdad, las instancias están sobredimensionadas, el autoscaling está mal configurado, o quedaron ambientes viejos corriendo desde el lanzamiento. Ya lo cubrimos antes en los cambios de precios en Google Cloud.
¿Cómo comparar el gasto cloud con el uso real del negocio?
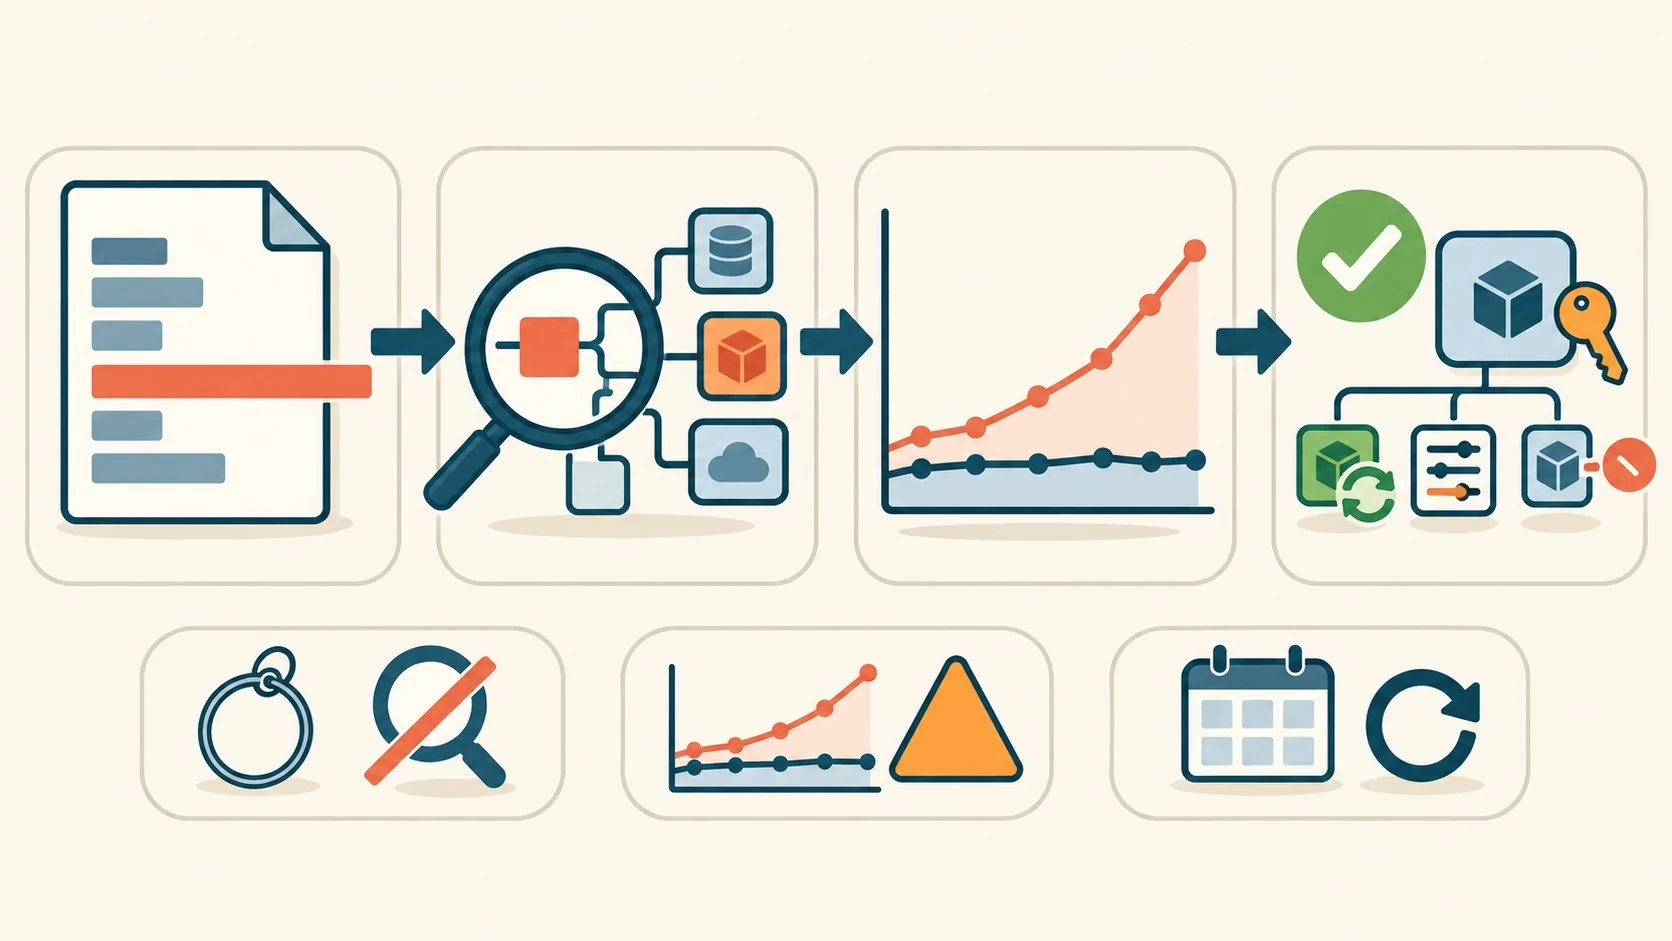
Comparás el gasto cloud con el uso real armando una proporción simple: eficiencia cloud = uso de negocio / costo de infraestructura. Si el costo sube 20% y el uso del producto subió 80%, probablemente estés en una posición saludable. Si el costo sube 20% y el uso está plano, ahí tenés una razón concreta para investigar.
El uso de negocio puede medirse como usuarios activos, requests, transacciones, jobs procesados o GB almacenados. El costo absoluto importa menos que el costo unitario: costo por usuario activo, costo por transacción, costo por workload. El objetivo no es siempre achicar la factura. Es asegurarte de que el costo escale junto con el valor que genera el negocio.
Ejemplo hipotético (a fines ilustrativos, no es un caso real): pensemos en una plataforma de gestión de turnos con 10.000 usuarios activos mensuales y una factura cloud de 8.000 dólares. Al mes siguiente, el gasto sube a 9.600 dólares (+20%), pero los usuarios activos pasan a 18.000 (+80%). El costo por usuario activo en realidad bajó, de 0,80 a 0,53 dólares: el gasto creció en términos absolutos, pero la eficiencia mejoró. Ahora imaginemos la otra variante: los usuarios activos se mantienen en 10.000 y la factura sube igual a 9.600 dólares. Ahí el costo por usuario sube de 0,80 a 0,96 dólares sin que haya más valor de negocio detrás. Ese segundo escenario es el que justifica abrir el desglose por servicio y buscar qué línea específica movió el número.
Infraestructura idle: ¿por qué sigue existiendo lo que ya no se usa?
La infraestructura idle sigue existiendo porque casi todo el desperdicio arranca como una decisión válida que después perdió su razón de ser. Tomás una instancia más grande para el lanzamiento, armás un entorno de staging para la migración, sumás una réplica de base de datos durante un troubleshooting puntual y cuando el proyecto termina, la razón original desaparece pero el recurso queda corriendo sin que nadie se haga cargo de apagarlo.
Por eso conviene hacerse dos preguntas frente a cualquier recurso no trivial: ¿por qué existe esto? ¿Quién es el dueño de eliminarlo? Si nadie responde ninguna de las dos, ese recurso merece atención. Para más detalles técnicos, mirá cómo calcular RTO y RPO en tu estrategia.
El recurso queda. El problema no es solo la capacidad ociosa, sino la falta de ownership sobre el ciclo de vida de cada pieza de infraestructura.
Sobreprovisión de recursos: ¿cuándo el margen de seguridad se vuelve permanente?
El margen de seguridad se vuelve permanente cuando nadie revisa los supuestos originales después de unos meses. Provisionar de más suele ser una decisión racional: es más seguro asignar demasiada capacidad que muy poca cuando la demanda es incierta. El problema aparece cuando ese colchón temporal se convierte en el default de siempre.
Las métricas a revisar después de ese período inicial son utilización de CPU, uso de memoria, request rate, carga de base de datos, IOPS de storage, concurrencia y picos de tráfico. Un sistema que usa el 20% de lo que tiene provisionado la mayor parte del tiempo merece una investigación, aunque eso no significa achicarlo de forma automática: todavía hay que contemplar picos de tráfico, capacidad de failover, batch jobs y requisitos de recuperación ante desastres.
Criterios para decidir si un costo merece acción inmediata
No todo gasto que crece necesita intervención urgente. Para priorizar sin perder tiempo en falsas alarmas, un criterio simple es cruzar la variación del costo contra la variación del uso (la misma lógica del ejemplo del apartado anterior):
- Actuá en este ciclo si el costo subió y el uso está plano o cayó: no hay justificación de negocio detrás del incremento, así que el recurso específico necesita revisión antes del próximo ciclo de facturación.
- Revisá sin urgencia si el costo subió en proporción similar al uso: probablemente sea crecimiento normal, pero vale confirmar que no se haya sumado sobreprovisión adicional “por las dudas”.
- Dejalo documentado si el costo subió menos que el uso: es la señal de que la arquitectura está escalando bien, y conviene registrar por qué para repetir el patrón en otros servicios.
Almacenamiento, migraciones y entornos de no producción: ¿dónde se acumulan los costos olvidados?
Los costos olvidados se acumulan en tres lugares típicos: storage sin política de retención, infraestructura de migración que nunca se decomisiona, y entornos de desarrollo o QA corriendo con tamaño de producción las 24 horas. Los tres comparten el mismo patrón: nadie definió una fecha de expiración. Te puede servir nuestra cobertura de manejar secretos y variables correctamente.
El storage es traicionero porque crece de forma gradual: logs, backups, snapshots, uploads, exports, datos viejos de clientes, artifacts de build. El default peligroso es “guardemos todo”. Según el análisis de dev.to, una mejor revisión de storage pregunta qué hay que conservar, por cuánto tiempo, en qué tier y quién aprueba el borrado. Esto no es solo un tema de costo: toca compliance, recuperación ante incidentes y seguridad.
Las migraciones dejan fantasmas caros. Durante una migración es normal tener el entorno viejo y el nuevo corriendo en paralelo, bases duplicadas, backups extra y rollback infrastructure. El problema llega después del go-live: se declara terminada la migración y los recursos temporales se quedan ahí (spoiler: casi nunca alguien vuelve a mirarlos), sin fecha de cierre definida en el plan original.
Los entornos de no producción (dev, QA, staging, demo, sandbox) también escapan al escrutinio habitual. Preguntale a tu equipo si esos entornos necesitan correr 24/7, si necesitan recursos de tamaño producción o el dataset completo. Para la mayoría de los equipos, programar horarios de apagado en entornos no productivos es de las formas menos riesgosas de bajar el gasto, bastante distinta de recortar capacidad en producción. Si además estás evaluando dónde alojar esos entornos, en donweb.com podés comparar planes de infraestructura cloud con escalado bajo demanda.
Checklist práctico para auditar la factura cloud como documento de diseño
El checklist arranca por los deltas, no por el total de la factura: qué servicios cambiaron más desde el mes anterior. A partir de ahí se cruzan ocho preguntas concretas que conectan cada gasto con una decisión real.
- ¿Qué workload generó ese costo? Cada línea importante del bill tiene que mapear a un propósito técnico o de negocio identificable.
- ¿El uso también subió? Compará el gasto contra la actividad real del producto, no contra el mes anterior nomás.
- ¿Los recursos están bien dimensionados? Revisá la utilización real, no la estimación que se hizo en el lanzamiento.
- ¿Lo temporal sigue siendo temporal? Buscá infraestructura de migración, testing o incidentes que debería haberse apagado hace meses.
- ¿El storage es intencional? Revisá retención, backups, snapshots y logs que se guardan “porque sí”.
- ¿Los datos viajan más de lo necesario? Mapeá origen, destino, frecuencia y volumen de cada transferencia relevante.
- ¿Los entornos de no producción están sobredimensionados? Chequeá horarios y tamaño de instancias en dev, QA y staging.
- ¿Cada costo mayor tiene un dueño? Sin ownership claro, no hay revisión periódica real.
Errores comunes al auditar el gasto cloud
El primer error es mirar el total de la factura antes que los deltas mes a mes. Si arrancás por el número grande, te perdés justo el servicio que creció 300% mientras todo lo demás se mantuvo estable.
El segundo error es asumir que menos gasto siempre es mejor. Reducir redundancia, retención o frecuencia de backups baja el número, pero también puede bajar la confiabilidad del sistema entero. La pregunta correcta no es qué podés borrar: es qué costo ya no representa capacidad útil.
El tercer error es tratar el storage como gratis porque crece de a poco. El storage es traicionero justamente porque crece de forma gradual: es fácil ignorarlo hasta que termina representando una porción significativa de la factura de almacenamiento.
El cuarto error es cerrar una migración sin criterio de decomisión. Si el plan no define cuándo se apaga el entorno viejo, cuándo se borra el rollback y quién aprueba el retiro final, esa infraestructura temporal queda sin fecha de vencimiento natural.
Este problema del pool de conexiones mal configurado suele derivar en decisiones de arquitectura que después cuesta revertir en producción.
Preguntas Frecuentes
¿Qué significa que la factura cloud es un documento de diseño?
Significa que cada línea de gasto en la nube refleja una decisión técnica u operativa tomada en algún momento: cuánto compute asignar, qué réplicas mantener, qué datos retener. La factura muestra, en términos financieros, cómo quedó armado el sistema en producción, más allá de lo que diga el diagrama de arquitectura original.
¿Por qué aumenta la factura de AWS o Azure si el uso no cambió?
Un aumento sin cambio de uso suele indicar instancias sobredimensionadas, autoscaling mal configurado, servicios duplicados o ambientes viejos que siguieron corriendo después de un lanzamiento o migración. El punto de partida para investigar es comparar los deltas de cada servicio mes a mes, no el total de la factura.
¿Cómo saber si tengo infraestructura cloud sin usar?
Revisá la utilización real de CPU, memoria, IOPS y concurrencia contra lo que tenés provisionado: un recurso que usa 20% de su capacidad asignada la mayor parte del tiempo es candidato a revisión. Después preguntate por qué existe ese recurso y quién es responsable de eliminarlo.
¿Qué es el costo por usuario o unit cost en cloud?
El costo por usuario (o unit cost) es el gasto de infraestructura dividido por una métrica de uso del negocio, como usuarios activos o transacciones. Sirve más que el gasto total porque muestra si el costo escala junto con el valor que genera el producto.
¿Cómo revisar los costos de una migración cloud después del go-live?
Después del go-live hay que confirmar cuándo se apaga el entorno viejo, cuándo se retira la infraestructura de rollback, qué backups deben quedar y quién aprueba el retiro final. Si esas decisiones no estaban en el plan de migración original, la infraestructura temporal queda corriendo sin fecha de vencimiento.
Conclusión
La factura cloud deja de ser un problema de finanzas en el momento en que la leés como lo que es: un registro de las decisiones técnicas que tomó tu equipo. El análisis de dev.to plantea una idea simple pero poco aplicada: cada costo anómalo merece el mismo tratamiento que un pico de latencia o un spike de errores, porque suele ser la señal de un problema operativo real, no solo contable.
Si gestionás infraestructura, el paso concreto es incorporar la revisión de costos a las reuniones de arquitectura, no dejarla en un dashboard de finanzas que nadie mira. Empezá por los deltas del mes, cruzalos contra el criterio de semáforo (costo vs. uso) descrito más arriba, preguntate quién es dueño de cada recurso no trivial y confirmá que cada ambiente temporal tenga fecha de cierre. Eso sí: ninguna fuente disponible mide el ahorro promedio de aplicar este enfoque, así que tomalo como criterio de auditoría, no como cifra garantizada.