Pipeline CI/CD seguro: commit a producción sin sustos
En pocas palabras: Un pipeline de CI/CD seguro en GitHub Actions corre linting y tests en cada push, construye una imagen Docker etiquetada con el hash del commit, y bloquea el deploy a producción hasta que un reviewer apruebe manualmente, usando autenticación OIDC sin credenciales permanentes.
Un pipeline de CI/CD seguro corre tests y linting en cada push, construye una imagen Docker con el hash del commit como tag, y exige aprobación manual antes de tocar producción usando autenticación OIDC en lugar de credenciales permanentes. Así lo describe un tutorial reciente sobre GitHub Actions publicado el 3 de octubre de 2026.
Un pipeline CI/CD seguro es un flujo automatizado que valida, construye y despliega código sin intervención manual repetitiva, pero con puntos de control humano antes de llegar a producción. Lo arma un equipo de desarrollo usando herramientas como GitHub Actions, y su objetivo es reducir errores humanos sin eliminar la supervisión en los pasos críticos del deploy.
En este artículo:
- En 30 segundos
- ¿Qué problema resuelve automatizar el camino de commit a producción?
- ¿Cuál es la diferencia entre Continuous Integration, Continuous Delivery y Continuous Deployment?
- ¿Cómo se construye un pipeline básico con GitHub Actions?
- ¿Cómo se integra Docker al pipeline para build y push de la imagen?
- ¿Cómo se protege el deploy a producción con aprobación manual y OIDC?
- ¿Qué deploya cada branch en una estrategia típica de feature/develop/main?
- ¿Cómo se gestionan secrets sin exponerlos en el pipeline?
- Errores comunes al armar un pipeline CI/CD
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- CI corre tests y build en cada push a main; si falla un step, el pipeline se detiene ahí mismo.
- Continuous Delivery deploya automático a staging; producción necesita aprobación manual de un reviewer.
- Continuous Deployment (sin “Delivery”) manda a producción sin aprobación humana, algo que la mayoría de los equipos evita.
- OIDC permite autenticar contra AWS sin guardar secretos permanentes en el repositorio.
- La estrategia de branches típica: feature/* solo corre CI, develop deploya a staging, main deploya a producción con approve.
¿Qué problema resuelve automatizar el camino de commit a producción?
Resuelve el desgaste de testear a mano, buildear a mano y deployar a mano, tareas que según el tutorial de mislam-dev se repiten todos los días y generan errores inesperados justo cuando el código llega a producción.
Ponele que tu equipo lanza una feature nueva. Alguien testea en su máquina, funciona, lo sube, y en producción explota algo que nadie vio venir porque el testing manual no cubrió ese caso. Pasa todo el tiempo. El tutorial menciona que ese ciclo repetitivo “aburre” a los miembros del equipo, y que antes de meter CI/CD, Docker y Kubernetes ya habían reducido parte de esa carga: antes había que hacer un montón de pasos sueltos, ahora con un build de imagen o un deploy de k8s alcanza.
El salto siguiente es automatizar lo que queda: testear, buildear y deployar con un script. Ahí nace la idea de un pipeline CI/CD seguro: no es solo correr comandos en secuencia, es hacerlo con control de errores y puntos de corte.
¿Cuál es la diferencia entre Continuous Integration, Continuous Delivery y Continuous Deployment?
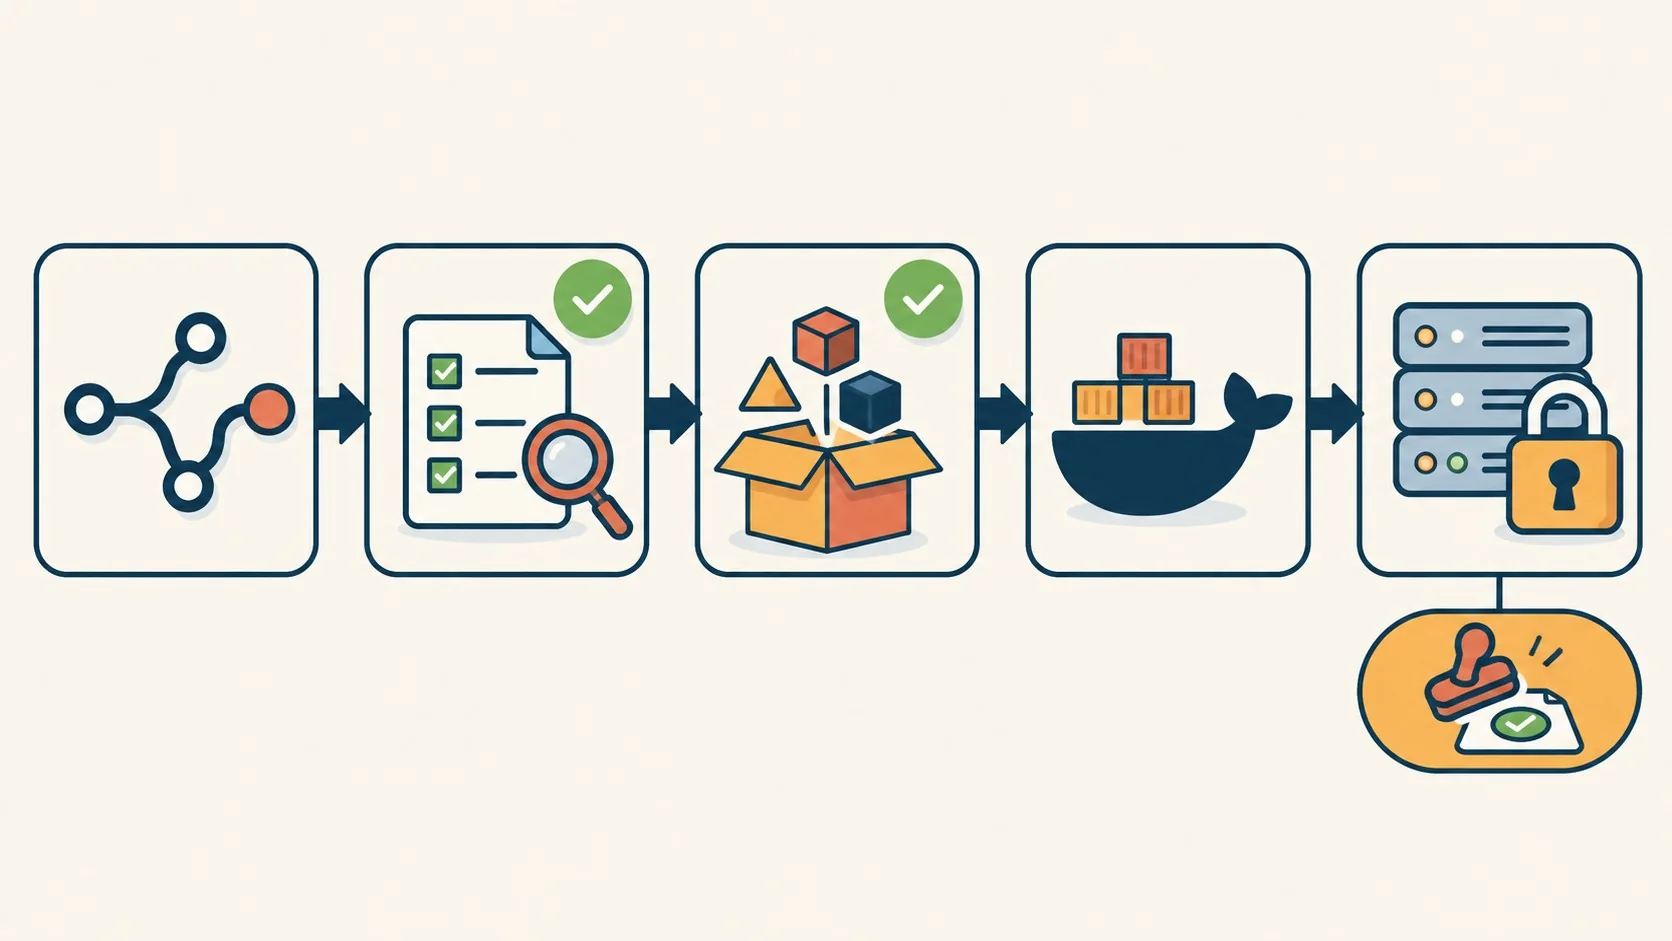
CI corre tests y build automáticamente en cada push; Continuous Delivery agrega deploy automático a staging; Continuous Deployment manda directo a producción sin que nadie apruebe nada. Son tres niveles de automatización, no sinónimos intercambiables. Relacionado: comparativa entre GitHub Actions, Jenkins y GitLab CI.
- Continuous Integration (CI): en cada push se corren tests y build automáticamente. Si algo falla, el pipeline avisa y no avanza. Es la etapa de chequeo pura.
- Continuous Delivery (CD): si CI pasa, el código se deploya solo a staging. Producción sigue necesitando un humano que diga “dale”.
- Continuous Deployment (CD): acá no hay aprobación humana ni para producción. Todo lo que pasa CI termina en vivo.
La mayoría de los equipos elige Continuous Delivery. ¿Por qué no van directo a Continuous Deployment si total “ya está todo testeado”? Porque un test suite nunca cubre el cien por ciento de los casos reales, y tener a alguien que mire el changelog antes del approve final es barato comparado con el costo de un incidente en producción.
¿Qué criterios usar para elegir entre Delivery y Deployment?
Ninguna de las dos fuentes da una regla fija para esto, pero de la lógica del propio pipeline se pueden sacar algunos criterios prácticos para decidir cuándo vale la pena sacar el approve manual de producción y cuándo no:
- Cobertura real de tests, no solo que “pasen”: si el test suite no cubre casos de integración ni escenarios de carga, un check verde no garantiza que el sistema aguante en producción. Sin esa cobertura, sacar el approve manual es prematuro.
- Costo de un rollback: si tenés blue-green deployment o feature flags que permiten apagar una feature en segundos, el riesgo de saltear la aprobación baja bastante. Si el rollback implica downtime o migración de datos difícil de revertir, conviene mantener el punto de control humano.
- Criticidad del sistema: un panel interno de métricas puede tolerar Continuous Deployment; un sistema que mueve pagos o datos sensibles, no, independientemente de qué tan bueno sea el pipeline.
- Tamaño y rotación del equipo: cuantas más personas puedan mergear a main, más vale un filtro humano antes de producción, aunque sea solo para que alguien note un cambio de infraestructura que el test suite no puede evaluar.
En la práctica, esto explica por qué el tutorial original y la mayoría de los equipos se quedan en Continuous Delivery: no es falta de confianza en la automatización, es reconocer que el approve manual es barato comparado con lo que cuesta un incidente que el test suite no vio venir.
¿Cómo se construye un pipeline básico con GitHub Actions?
Se construye con un archivo YAML en .github/workflows/ que define triggers, jobs y steps. El ejemplo del tutorial dispara el workflow en cada push o pull request a main, y corre cuatro pasos en secuencia: instalar dependencias, lint, test y build.
El job de test queda así:
- Checkout del código: con
actions/checkout@v4, el runner descarga el repo. - Setup de Node.js: el ejemplo del tutorial original usa
actions/setup-node@v4con versión 20 y cache de npm activado; si armás el pipeline hoy, chequeá cuál es la versión LTS vigente de Node.js antes de copiar ese número a tu propio workflow. - Install:
npm cien vez denpm install, porque respeta el lockfile al pie de la letra. - Lint y test:
npm run lintynpm run test:ci. - Build:
npm run buildal final, solo si todo lo anterior pasó.
GitHub Actions corre esto en la nube de GitHub, no en tu máquina. Si cualquier step falla, el workflow se detiene ahí mismo y no sigue al siguiente. Nada de “bueno, el lint falló pero deployemos igual”.
Algo que el tutorial no cubre y que vale la pena tener en el radar: según la documentación oficial de GitHub Actions, además de los runners hosteados por GitHub (como ubuntu-latest) existen los self-hosted runners, pensados para cuando necesitás un entorno más customizado o cuando el pipeline empieza a acercarse a los límites de uso de los runners de GitHub. Si tu equipo crece y el pipeline tarda cada vez más, esa es una de las primeras cosas para evaluar antes de complicar el YAML con workarounds.
¿Cómo se integra Docker al pipeline para build y push de la imagen?
Se integra agregando un job que corre después de que el de test pasa, construye la imagen con docker build usando el hash del commit como tag, y la sube a un registry como ghcr.io. Esto garantiza trazabilidad: cada imagen corresponde a un commit exacto. Tema relacionado: los checks de seguridad imprescindibles en AWS.
El job build-and-push del tutorial hace exactamente eso: docker build -t my-app:${'{'} github.sha {'}'} ., después taggea la imagen apuntando a ghcr.io/myorg/my-app y la pushea. Usar github.sha como tag, en vez de algo como “latest”, es lo que te permite saber exactamente qué código corre en cada ambiente sin adivinar. Si algo se rompe en producción, buscás el sha, ves el commit, y ya sabés qué cambió.
¿Cómo se protege el deploy a producción con aprobación manual y OIDC?
Se protege definiendo environment: production en el job de deploy, lo que obliga a que un reviewer apruebe antes de que corra, y autenticando contra el cloud provider con OIDC en vez de guardar credenciales permanentes como secrets.
El ejemplo del tutorial usa aws-actions/configure-aws-credentials@v4 con un role-to-assume apuntando a un rol de IAM, sin ningún access key hardcodeado. Eso es OIDC: GitHub le prueba al cloud provider que la request viene de un workflow autorizado, y el provider entrega un token temporal. Nada de secrets eternos dando vueltas que alguien se olvida de rotar.
Después de autenticarse, el pipeline actualiza el kubeconfig con aws eks update-kubeconfig y corre kubectl set image seguido de kubectl rollout status para confirmar que el deploy terminó bien.
¿Qué deploya cada branch en una estrategia típica de feature/develop/main?
Feature branches solo disparan CI (test y lint), develop dispara CI más deploy automático a staging, y main dispara CI más deploy a producción con aprobación manual. Es la estrategia que describe el tutorial y la que usa la mayoría de los equipos que eligen Continuous Delivery. Esto se conecta con lo que analizamos en guía para armar un pipeline ETL con Airflow.
Mapeado así:
- feature/*: solo CI. Test y lint, nada de deploy.
- develop: CI más deploy automático a staging.
- main: CI más deploy a producción, pero con approve manual antes.
Esta separación evita que un branch de experimento toque staging por accidente, y evita que algo llegue a producción sin pasar antes por un ambiente de prueba real.
Ejemplo hipotético: dónde el approve manual marca la diferencia
Nota: el siguiente escenario es ficticio, pensado solo para ilustrar un punto, no describe un caso real ni datos de ningún equipo o empresa.
Imaginemos un equipo pequeño que mantiene un panel administrativo interno y ya tiene este pipeline configurado: feature branches solo con CI, develop con deploy automático a staging, main con deploy a producción bajo approve manual. Un desarrollador abre un pull request que agrega una función nueva y, de paso, cambia el nombre de una variable de entorno que usa el servicio en producción (algo que en staging no se nota porque ese valor está hardcodeado en el ambiente de prueba). El lint pasa, los tests pasan, el build pasa: nada en el pipeline automático detecta el problema porque ningún test cubre esa variable específica. El código llega a main y el job de deploy queda esperando el approve de environment: production. Ahí, un reviewer que conoce la infraestructura ve en el diff que se tocó el nombre de una variable de entorno y frena el deploy hasta confirmar que el valor correspondiente existe también en producción. En este escenario hipotético, el punto de corte humano no reemplaza al testing automático: cubre justo el tipo de error que el testing automático, por diseño, no puede anticipar.
¿Cómo se gestionan secrets sin exponerlos en el pipeline?
Se gestionan guardando valores sensibles en GitHub Secrets y referenciándolos en el workflow con ${'{'} secrets.NOMBRE {'}'}, nunca escribiéndolos directamente en el archivo YAML. El tutorial lo marca como punto clave: meter configuración sensible dentro del workflow file abre la puerta a que se filtre.
El ejemplo pasa DATABASE_URL y API_KEY como variables de entorno tomadas de GitHub Secrets. GitHub las encripta y las inyecta solo en runtime, nunca quedan visibles en los logs ni en el historial del repo (salvo que alguien las imprima a propósito, lo cual sería un error aparte).
Errores comunes al armar un pipeline CI/CD
Subís el workflow, corre bien en tu rama de prueba, parece que anda todo perfecto, lo mergeás a main y ahí explota porque nadie revisó que el ambiente de producción necesitaba una variable que en staging ni se usaba.
- Hardcodear secrets en el YAML: aunque sea “solo para probar”, queda en el historial de git para siempre. Usá GitHub Secrets desde el día uno.
- Saltear el approve manual en producción: configurar
environment: productionmal o sin reviewers asignados anula el punto de control que justamente te protege. - Usar
npm installen vez denpm cien el pipeline: install puede actualizar versiones del lockfile sin avisar, lo que genera builds no reproducibles. - No testear el rollback: el pipeline deploya bien pero nadie probó qué pasa si
kubectl rollout statusfalla a mitad de camino.
Preguntas Frecuentes
¿Qué diferencia hay entre Continuous Integration y Continuous Delivery?
Continuous Integration solo corre tests y build en cada push, sin deployar nada. Continuous Delivery agrega un paso más: si CI pasa, el código se deploya automáticamente a staging, aunque producción sigue necesitando aprobación manual.
¿Cómo hago un pipeline de CI/CD con GitHub Actions?
Creás un archivo YAML en .github/workflows/ que defina triggers (push, pull_request), jobs de test con checkout, setup de lenguaje, install, lint y build, y después jobs separados para build de Docker y deploy. GitHub Actions ejecuta cada step en orden y corta el pipeline si alguno falla.
¿Cómo deployar a producción sin romper nada?
Definiendo environment: production en el job de deploy para exigir aprobación manual de un reviewer antes de que corra, y validando con comandos como kubectl rollout status que el deploy terminó correctamente antes de considerarlo exitoso. Ningún check automático reemplaza ese filtro humano para casos que los tests no cubren, como el del ejemplo hipotético de la variable de entorno mencionado más arriba.
¿Cómo manejar secretos y variables de entorno en GitHub Actions?
Guardándolos en GitHub Secrets desde la configuración del repositorio y referenciándolos en el workflow como ${'{'} secrets.NOMBRE {'}'}. Nunca se escriben valores sensibles directamente en el archivo YAML del workflow.
¿Qué es OIDC y para qué sirve en un deploy a AWS?
OIDC es un protocolo de autenticación que permite a GitHub Actions probarle a AWS que una request viene de un workflow autorizado, sin necesidad de guardar access keys permanentes como secret. AWS responde con credenciales temporales que se usan solo durante esa ejecución del pipeline.
Conclusión
Un pipeline CI/CD seguro no elimina el criterio humano, lo mueve al lugar correcto: antes del merge con tests automáticos, y antes del deploy a producción con un approve manual. Lo que cambia respecto a hacerlo todo a mano es la consistencia: el mismo proceso corre siempre igual, sin depender de que alguien se acuerde de todos los pasos. Y como muestra el ejemplo hipotético de la variable de entorno, ese punto de control humano no es un trámite burocrático: cubre justo los casos que el testing automático, por más completo que sea, no puede anticipar.
Si tu equipo todavía testea y deploya manual, el camino lógico es el que describe el tutorial: primero CI con lint, test y build; después Docker con tag basado en el commit; después un job de deploy protegido con environment y OIDC. Armalo en ese orden, no al revés, porque cada capa depende de que la anterior funcione bien. Y antes de sacar cualquier approve manual del medio, aplicá los criterios de cobertura de tests, costo de rollback y criticidad del sistema que vimos más arriba: no todos los proyectos están en el mismo punto para dar ese salto.