Dead letter queue vs reintento: 3 reglas en Node.js
En pocas palabras: Con un 429, reintentá dentro del worker respetando Retry-After; si no viene, esperá min(2**intento, 60) segundos, hasta 5 intentos. Si el job sigue fallando, mandalo a la DLQ y reinyectalo en lotes chicos cuando la API se recupere. Antes, hacé idempotente el envío.
Con un 429 reintentá dentro del worker, respetando Retry-After. Si el job sigue fallando, mandalo a la dead letter queue y reinyectalo en lotes chicos cuando la API se recupere. Antes de todo, hacé idempotente el envío, según un post de dev.to del 13/10/2026.
Una dead letter queue (DLQ) es una cola secundaria que recibe los mensajes que el consumidor no logró procesar, para que dejen de bloquear la cola principal y alguien pueda inspeccionarlos. El redrive es la operación inversa: devolver esos mensajes a la cola de origen cuando se resolvió la causa. Amazon SQS la tiene como función nativa y RabbitMQ usa dead letter exchanges con el mismo fin.
En este artículo:
- En 30 segundos
- ¿Cómo manejar un error 429 en un worker de Node.js: Retry-After o backoff exponencial?
- ¿Cuándo mover un mensaje a la dead letter queue y cómo hacer el redrive?
- ¿Cómo hacer idempotente un recordatorio para que no se envíe dos veces?
- ¿Qué métricas monitorear en una cola además de la cantidad de mensajes pendientes?
- ¿SQS, RabbitMQ, BullMQ o Infrai: qué cola conviene para recordatorios de renovación?
- ¿Qué está confirmado y qué falta verificar?
- ¿Cómo verificar esta estrategia antes de llevarla a producción?
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un 429 se reintenta en el worker: respetá Retry-After y, si no viene, esperá min(2**attempt, 60) segundos, hasta 5 intentos en el ejemplo del post.
- Tras agotar los reintentos, el job va a la DLQ: el redrive se hace en lotes acotados y con la API ya recuperada.
- La idempotencia va primero: una clave estable por recordatorio y un registro fuera de la cola, porque las colas estándar entregan al menos una vez.
- Medí la edad del mensaje más antiguo: la cantidad de pendientes sola puede mostrar una cola “sana” que ya llegó tarde a un deadline.
¿Cómo manejar un error 429 en un worker de Node.js: Retry-After o backoff exponencial?
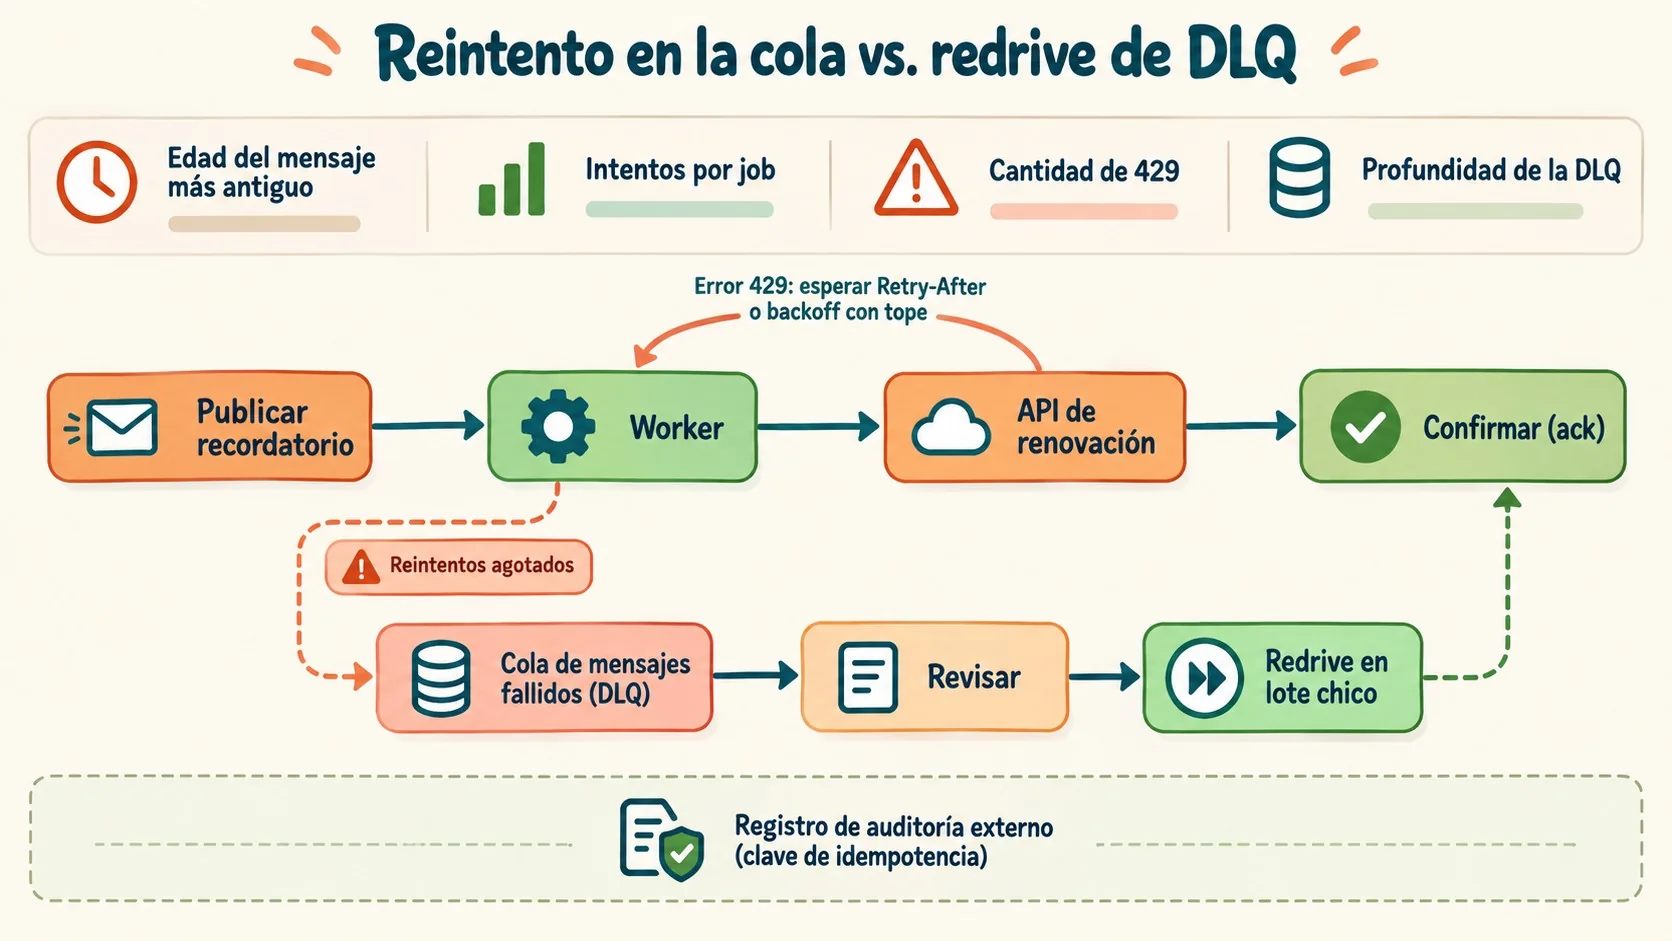
Si la API manda el header Retry-After, esperá ese tiempo; si no lo manda, usá backoff exponencial con tope. El ejemplo del post hace hasta 5 intentos y espera min(2**attempt, 60) segundos, o sea que ninguna espera pasa del minuto. Los timeouts de red siguen el mismo camino.
Los registros mal formados y los fallos de autorización permanentes quedan afuera de esa bolsa. Un 401 que se repite no es presión transitoria sino configuración rota, y reintentarlo cinco veces solo demora el aviso.
function esperaEnSegundos(response, attempt) {
 const retryAfter = Number(response.headers.get("retry-after"));
 return Number.isFinite(retryAfter) && retryAfter > 0
 ? retryAfter
 : Math.min(2 ** attempt, 60);
}
Es la misma lógica del ejemplo del post, resumida en una función. Ojo con ese código: solo consulta la ruta de stats de la cola e imprime el resultado, no ejecuta ningún redrive. Es el esqueleto del bucle de control, no un worker terminado.
Si usás BullMQ, su documentación aclara que sin función de backoff los jobs se reintentan sin demora apenas fallan, y contra una API que ya te limita eso es echar nafta al fuego. Con backoff exponencial la espera es 2^(attempts – 1) * delay milisegundos, y la opción jitter (entre 0 y 1) agrega aleatoriedad para que los workers no golpeen todos juntos.
¿Cuándo mover un mensaje a la dead letter queue y cómo hacer el redrive?
Cuando el job agotó su límite de reintentos: el worker hace nack y el mensaje sale a la dead letter queue, así un job envenenado no frena al resto de los recordatorios. El redrive viene después y es deliberado: esperás que la dependencia externa se recupere, inspeccionás la DLQ y reinyectás un lote acotado, para que la API recién recuperada no te limite de nuevo enseguida. Más contexto en publicar un proyecto React con Vite.
- Reintento en la cola: sirve para fallas transitorias como un 429 o un timeout, con espera acotada y el job cerca del worker.
- Dead letter queue: recibe el job que agotó los reintentos y lo saca de la línea principal para que lo revises.
- Redrive: devuelve un lote chico a la cola principal cuando el upstream ya responde bien.
El post lo resume así: «los reintentos infinitos en el lugar ocultan la salud real de la cola» (traducción nuestra del original en inglés).
En Amazon SQS, la documentación oficial define una redrive policy con un maxReceiveCount, que es la cantidad de veces que un consumidor puede recibir un mensaje antes de que pase a la DLQ. Con valor 1, una sola falla lo manda ahí, así que conviene dejarlo alto para tener reintentos de verdad. La DLQ tiene que estar en la misma cuenta y región que la cola de origen, y la redrive allow policy admite hasta 10 colas de origen con byQueue.
Hay una trampa de retención. En colas estándar el timestamp original no cambia al moverse a la DLQ: si un mensaje pasó 1 día en la cola de origen y la DLQ retiene 4 días, se borra a los 3. Por eso AWS recomienda que la retención de la DLQ sea mayor que la de la cola original.
En RabbitMQ, según su documentación de dead letter exchanges, un mensaje se manda a dead letter cuando lo rechazan con nack sin requeue, vence su TTL, la cola supera su límite de largo o una quorum queue lo devuelve más veces que el delivery-limit. Dos avisos del manual: si el exchange de destino no existe, los mensajes se descartan sin avisar, y el dead-lettering at-least-once solo lo tienen las quorum queues.
¿Cómo hacer idempotente un recordatorio para que no se envíe dos veces?
Con una clave de idempotencia estable por recordatorio, como renewal:${accountId}:${deadline}, y con el registro del efecto guardado fuera de la cola antes del ack. Las colas estándar son at-least-once: un ack perdido después de una llamada exitosa puede reentregar el mismo job. Cubrimos ese tema en detalle en poner tu web online gratis en Vercel.
Un caso hipotético (es mío, no sale de la fuente): el worker manda el recordatorio de la cuenta 4821, la API responde 200, el proceso se cae antes del ack, la cola reentrega el mensaje, otro worker lo toma, vuelve a llamar a la API y el cliente recibe dos avisos de renovación con el mismo vencimiento. Con la clave renewal:4821:2026-11-30 el segundo intento se reconoce como repetido.
- Armá la clave y buscala en tu base; si ya figura como enviada, hacé ack y salí.
- Llamá al proveedor mandando esa clave, si su API la acepta.
- Guardá el resultado en tu base.
- Recién ahí hacé ack.
Ese orden es una inferencia nuestra a partir de la regla del post (registrar antes del ack); el post no lo detalla paso a paso. Si el proveedor no acepta claves de idempotencia, tu registro achica la ventana de duplicados pero no la cierra.
El ack borra el mensaje y la retención es limitada, así que la cola no es una base de auditoría. El post pide una fila externa con cuenta, deadline, clave, cantidad de intentos, última clase de error y request ID final del proveedor. Con eso, soporte contesta “¿se mandó este recordatorio?” sin rebobinar mensajes borrados. Complementá con comparativa entre Vercel y AWS Amplify.
¿Qué métricas monitorear en una cola además de la cantidad de mensajes pendientes?
Empezá por la edad del mensaje más antiguo y sumá intentos por job, cantidad de 429, profundidad de la DLQ, cantidad de redrives y el tiempo entre el deadline y el recordatorio exitoso. La profundidad del backlog sola puede mentir: según el post, una cola con diez mensajes viejos puede parecer más “sana” que una que recibe cien recordatorios frescos por minuto si las llegadas caen a cero.
- Suben los 429: el post dice que el tope es demasiado bajo o la dependencia está ocupada (no aclara de qué tope habla).
- Backlog estable sin 429: el pool de workers probablemente sea chico.
- La DLQ crece: compará su ritmo con las clases de respuesta de la API externa.
El autor cuenta que arrancó con un solo contador de “jobs fallidos” y no podía saber si un deadline estaba en riesgo. Sumar la edad del mensaje más antiguo cambió el runbook a “pausar el redrive, bajar la concurrencia y avisar al responsable” cuando la edad cruza la ventana de negocio.
Un matiz de SQS: según su documentación, en colas estándar con maxReceiveCount mayor a 3, un mensaje recibido 3 o más veces sin borrarse pasa al final de la cola, y ApproximateAgeOfOldestMessage refleja al siguiente que no superó ese umbral. Mi lectura: la métrica puede subestimar el atraso real de los mensajes que vienen fallando. Ya lo cubrimos antes en otras plataformas de hosting alternativas a Vercel.
¿SQS, RabbitMQ, BullMQ o Infrai: qué cola conviene para recordatorios de renovación?
No hay ganador universal. Depende de dónde querés que vivan la política de reintentos, la retención y la operación. Si ya operás un broker o un Redis, quedate ahí; si no querés operar nada, SQS tiene la DLQ y el redrive documentados de forma nativa.
| Opción | Fortaleza según el post | Trade-off a verificar | Dato de documentación oficial |
|---|---|---|---|
| AWS SQS con DLQ | Retención y controles de redrive gestionados | IAM, métricas y convenciones de AWS pasan a ser parte del servicio | Redrive policy con maxReceiveCount; DLQ en la misma cuenta y región |
| RabbitMQ | Acks finos y ruteo para equipos que ya operan un broker | Capacidad, upgrades y recuperación son tuyos | DLX por política; delivery-limit en quorum queues |
| BullMQ sobre Redis | APIs conocidas de Node.js y control local del worker | Durabilidad, retención y operación multiproceso de Redis exigen diseño explícito | Opción attempts, backoff fixed o exponential y jitter |
| Infrai queue | Superficie REST autodescriptiva, con esquemas y ejemplos | No es motor de DAG, no tiene fan-out/join y la entrega estándar exige idempotencia | Sin documentación oficial contrastada en este análisis |
Si montás Redis en un servidor propio, por ejemplo un VPS en donweb.com, la durabilidad es tarea tuya. Sobre Infrai: el post tiene un ángulo promocional claro. Su “ventaja” de una sola clave y una sola factura puede ahorrar credenciales y facturas sueltas, pero el propio post admite que no te saca la responsabilidad del ledger, las alertas ni la revisión de la DLQ.
¿Qué está confirmado y qué falta verificar?
- Confirmado en documentación oficial: el funcionamiento de maxReceiveCount, la retención en la DLQ de SQS, los eventos de dead-lettering de RabbitMQ y los backoff de BullMQ.
- Solo está en el post: los límites de Infrai (retención máxima de 30 días, mensajes de hasta 256 KB, ventana de deduplicación FIFO de 5 minutos, delays de hasta 7 días). Contrastalos con documentación oficial antes de decidir.
- No hay mediciones: el post no trae benchmarks ni resultados de producción, solo reglas y un ejemplo.
- Vercel: aparece solo como referencia a su documentación de cron jobs; el post no anuncia nada de Vercel y no usamos esa página para este análisis.
¿Cómo verificar esta estrategia antes de llevarla a producción?
Es una propuesta editorial nuestra, no figura en el post y no la probamos:
- Simulá un 429: levantá una API de prueba que devuelva Retry-After y confirmá que el worker espera ese valor.
- Duplicá una entrega a mano: comprobá que sale un solo recordatorio.
- Hacé un redrive de lote chico: usá una DLQ de prueba y mirá la edad del mensaje más antiguo mientras drena.
- Probá la alerta: que salte cuando la edad cruce la ventana del negocio.
Errores comunes
- Reintentar todo con el mismo presupuesto: un 401 permanente o un registro mal formado gastan intentos que un 429 sí merece. Separá las clases de error.
- Hacer redrive de toda la DLQ de una: la API recuperada vuelve a limitarte. Reinyectá un lote acotado.
- Tratar la cola como registro: el ack borra el mensaje y la retención vence. Guardá el ledger afuera.
- Apuntar a un exchange inexistente en RabbitMQ: los mensajes se descartan sin avisar. Declarálo antes y preferí políticas a x-arguments fijos.
Preguntas Frecuentes
¿Qué hacer con un job que falla por error 429 en una cola?
Reintentalo en el worker respetando Retry-After; si el header no viene, usá backoff exponencial con tope. Si agota el límite de reintentos, mandalo a la DLQ en vez de seguir golpeando la API.
¿Cuál es la diferencia entre reintentar en la cola y mover el mensaje a una dead letter queue?
El reintento en la cola es para fallas transitorias y mantiene el job en la línea principal con espera acotada. La dead letter queue aísla el job que ya agotó los reintentos para que no frene al resto y puedas inspeccionarlo.
¿Cuándo conviene hacer redrive de una DLQ?
Después de que la dependencia externa se recuperó y de inspeccionar qué hay en la DLQ. Reinyectá un lote acotado y mirá la edad del mensaje más antiguo mientras drena.
¿Cómo evito enviar dos veces el mismo recordatorio si la cola entrega mensajes duplicados?
Usá una clave de idempotencia estable, como renewal:${accountId}:${deadline}, y guardá el registro del envío fuera de la cola antes de hacer ack. Así una reentrega se reconoce como repetida.
¿Qué métricas conviene monitorear en una cola además de la cantidad de mensajes?
La edad del mensaje más antiguo, los intentos por job, los 429, la profundidad de la DLQ y la cantidad de redrives. Sumá el tiempo entre el deadline y el recordatorio exitoso, que es la unidad que le importa al negocio.
Conclusión
El post del 13/10/2026 no inventa nada nuevo, pero ordena una decisión que mucha gente mezcla: reintentá lo transitorio en el worker, aislá lo que sigue fallando en la dead letter queue y hacé el redrive de forma deliberada. Lo que podés hacer hoy es separar las clases de error, escribir el ledger antes del ack y agregar la edad del mensaje más antiguo a tu tablero. Los límites de Infrai y cualquier promesa de ahorro quedan pendientes de contrastar con documentación oficial.