Por qué tu servidor se cae con CPU libre (y cómo evitarlo)
En pocas palabras: Se ajustan los parámetros de red del kernel Linux, como net.core.somaxconn y net.ipv4.tcp_max_syn_backlog, elevándolos de sus valores por defecto (128 o 512) a 4096, además de activar tcp_syncookies y ampliar el rango de puertos efímeros, para que el servidor acepte diez veces más conexiones TCP sin descartarlas. Pero copiar esos números sin revisar el tráfico propio puede ser tan mal criterio como no tocar nada.
Un servidor cloud de 2 vCPU y 4GB de RAM empezó a tirar errores 502 y resets de conexión cuando el tráfico pasó de 8 a más de 180 requests por segundo en tres minutos, con la CPU apenas al 32% y casi 2GB de memoria libre. El cuello de botella no estaba en la app ni en la base de datos: estaba en las colas TCP del kernel Linux, según detalla el análisis técnico publicado en dev.to.
Optimizar el kernel Linux para tráfico alto consiste en ajustar parámetros de red como net.core.somaxconn y net.ipv4.tcp_max_syn_backlog, que determinan cuántas conexiones TCP puede aceptar un servidor antes de empezar a descartarlas. Esos valores vienen por defecto en 128 o 512 conexiones en la mayoría de las distros, pensados para hardware de hace veinte años, y son la causa más común de errores 502 durante un pico inesperado de tráfico.
En este artículo:
- En 30 segundos
- ¿Por qué un servidor con CPU libre puede caerse ante un pico de tráfico?
- ¿Qué son la cola SYN y la cola Accept en TCP?
- ¿Cómo comprobar si el kernel está descartando conexiones TCP?
- ¿Cómo estimar qué backlog necesitás, en vez de copiar 4096 a ciegas?
- ¿Qué parámetros hay que ajustar para optimizar el kernel Linux ante un pico de tráfico?
- ¿Alcanza con tocar el kernel o también hay que ajustar la aplicación?
- ¿Cómo aplicar los cambios de sysctl sin reiniciar el servidor?
- Errores comunes al ajustar el kernel para tráfico alto
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un servidor con CPU al 32% devolvió 502 al pasar de 8 a 180 req/s porque el kernel descartaba conexiones, no la app.
net.core.somaxconnpor defecto suele ser 128, y la cola Accept se llena en segundos con un pico de tráfico.- El comando
ss -lntmuestra en la columna Recv-Q si la cola de conexiones establecidas está saturada. - La receta de sysctl propuesta sube somaxconn y tcp_max_syn_backlog a 4096, activa syncookies y amplía el rango de puertos efímeros a 10240-65535.
- 4096 no es un número mágico: conviene estimarlo según el pico de tráfico esperado y la memoria disponible, no copiarlo tal cual.
¿Por qué un servidor con CPU libre puede caerse ante un pico de tráfico?
Porque el cuello de botella no siempre está en el cómputo: el kernel de Linux descarta conexiones TCP antes de que la aplicación se entere de que existieron. Es el caso documentado en el artículo: una instancia de 2 vCPU y 4GB recibió un salto de tráfico de 8 a más de 180 req/s en tres minutos (una newsletter tech la había mencionado) y empezó a devolver 502 Bad Gateway y timeouts tipo Connection reset by peer.
Lo raro es que, mirando los paneles de monitoreo, todo parecía tranquilo. CPU al 32%, casi 2GB de RAM libres, disco sin movimiento. ¿Entonces dónde estaba el problema? En la capa de red del kernel, varios escalones antes de que Nginx o Node.js llegaran a ver la conexión. Una forma simple de entenderlo: pensá en el kernel como un guardia de seguridad que deja pasar a los primeros 128 visitantes a una sala de espera (la cola Accept) antes de que el recepcionista (la aplicación) los atienda. Por más que el recepcionista esté con las manos libres, al visitante 129 no lo dejan ni entrar al edificio. El 502 no lo generó la app; lo generó el guardia en la puerta.
¿Qué son la cola SYN y la cola Accept en TCP?
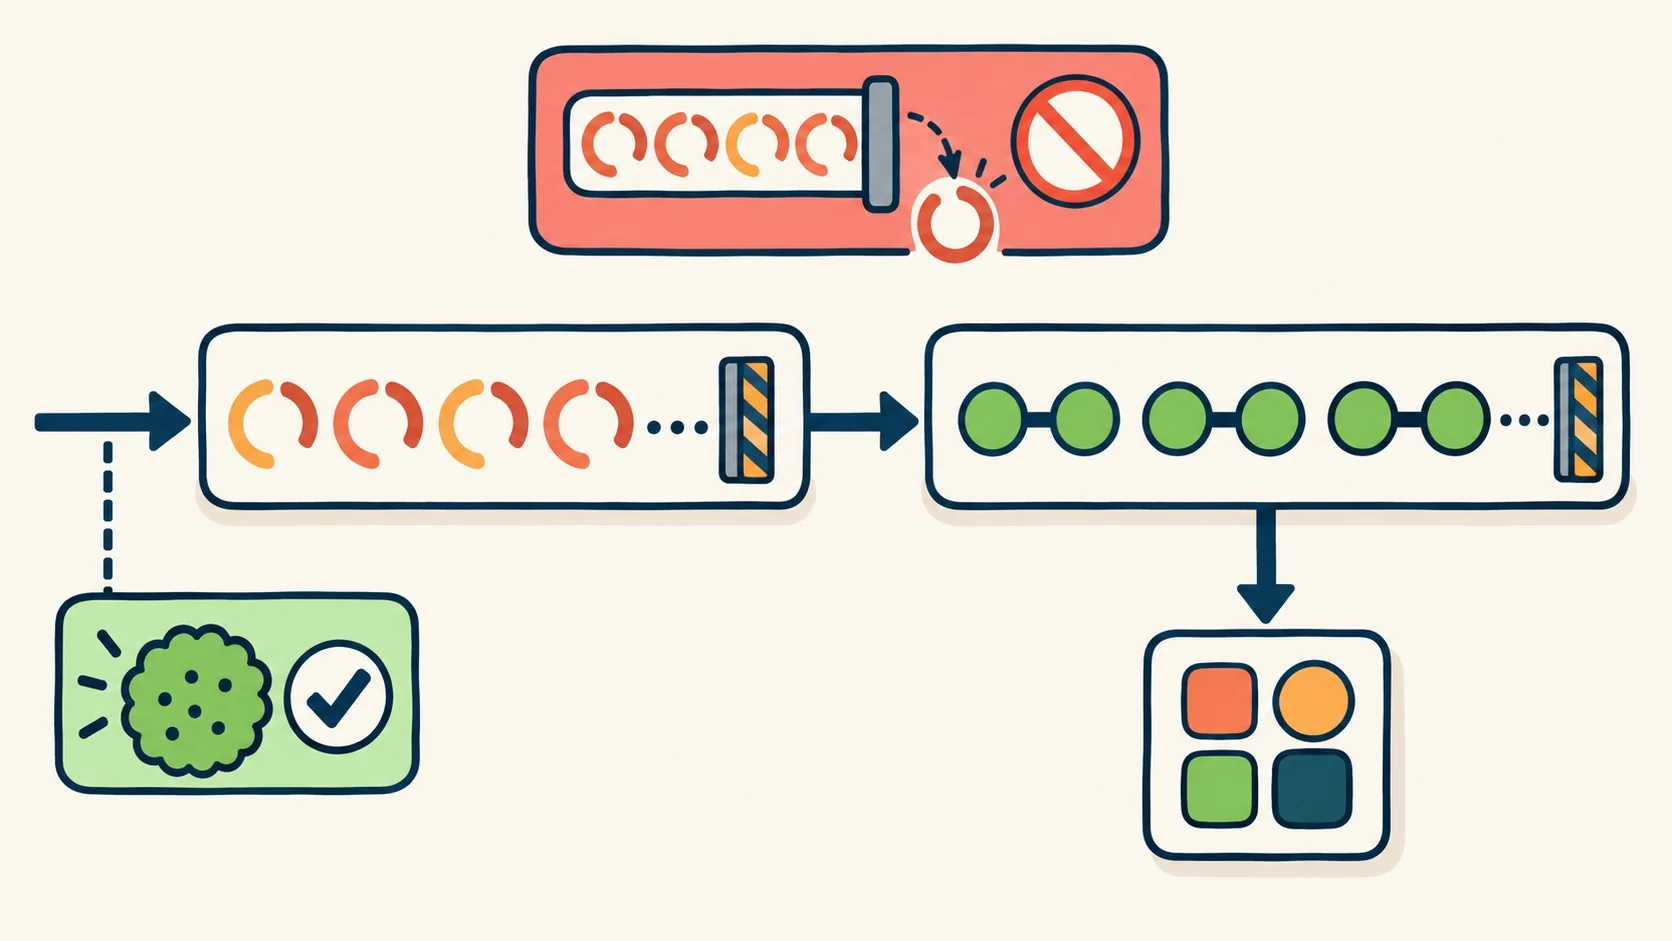
Son las dos estructuras de memoria donde el kernel guarda las conexiones mientras se completa el handshake TCP de tres pasos (SYN, SYN-ACK, ACK) antes de entregarle el socket a la aplicación. La SYN queue guarda conexiones a medio abrir y está limitada por tcp_max_syn_backlog; la Accept queue guarda conexiones ya establecidas que esperan a que la app llame a accept(), y está limitada por net.core.somaxconn.
Acá viene lo interesante: la cola efectiva no la define un solo parámetro, sino el mínimo entre dos. La fórmula que usa el artículo es simple: Cola Accept efectiva = min(net.core.somaxconn, backlog de la aplicación). Si tu kernel permite 4096 pero tu Nginx pide 128, tenés 128. Si tu app pide 4096 pero el kernel tiene 512, tenés 512.
Cuando la cola Accept se llena, el kernel no avisa con un error prolijo. Directamente descarta los paquetes ACK entrantes. El cliente cree que se perdió el paquete, reintenta, y ahí aparece esa latencia fantasma de uno a tres segundos que nadie logra explicar mirando los logs de la aplicación, porque la aplicación nunca vio la conexión.
¿Cómo comprobar si el kernel está descartando conexiones TCP?
Con tres comandos de diagnóstico que miran directamente los contadores del kernel, sin depender de logs de aplicación. El primero es ss -lnt '( sport = :80 or sport = :443 )', que en un socket LISTEN muestra Send-Q como la capacidad máxima de la cola y Recv-Q como las conexiones actuales esperando. Si ves Recv-Q 128 Send-Q 128, la cola está al tope y todo lo que llega en ese microsegundo se descarta.
- nstat -az TcpExtListenOverflows TcpExtListenDrops: si el primer contador es mayor a cero, hubo conexiones reales descartadas por saturación de la cola Accept.
- netstat -s | grep -i “listen”: devuelve un conteo acumulado de overflows de cola, útil para confirmar el problema histórico del servidor.
- dmesg -T | grep -i -E “syn|drop|backlog”: si aparece un mensaje tipo “Possible SYN flooding on port 443. Sending cookies”, la cola SYN se desbordó y el kernel ya activó su defensa.
¿Cómo estimar qué backlog necesitás, en vez de copiar 4096 a ciegas?
El artículo original usa 4096 porque fue el valor que les funcionó a ellos con su pico puntual de tráfico. Antes de replicarlo, conviene tener un criterio propio para decidir si esa cifra tiene sentido para tu servidor o es demasiado (o muy poco).
Un criterio simple: la cola Accept necesita poder alojar, en el peor momento, aproximadamente la cantidad de conexiones nuevas por segundo multiplicada por el tiempo que tarda la aplicación en vaciar esa cola llamando a accept(). Si la app es rápida para aceptar conexiones (milisegundos), la cola se vacía casi tan rápido como se llena y necesita menos margen. Si hay lentitud en la app (por ejemplo, un proceso saturado haciendo otra tarea), la cola crece más y necesita más margen.
Ejemplo hipotético (no corresponde al caso real del artículo, es solo para ilustrar el cálculo): supongamos un servicio que espera picos de 500 conexiones nuevas por segundo, y que en el peor escenario la aplicación demora 100 milisegundos en vaciar cada tanda de la cola. Eso implica que, en el instante más cargado, podría haber hasta 500 × 0,1 = 50 conexiones esperando simultáneamente. Un somaxconn de 128 ya cubriría ese escenario con margen; subirlo a 4096 sería sobredimensionar sin necesidad, salvo que se esperen picos mucho mayores o ráfagas más desparejas que el promedio.
Con ese cálculo como punto de partida, antes de aplicar la receta genérica conviene revisar tres cosas: cuál es el pico de tráfico realista (no el promedio), cuánta RAM libre tiene la instancia para sostener buffers más grandes (los valores de rmem_max/wmem_max de 16MB pueden ser excesivos en instancias de 1GB), y si ya existe un CDN o WAF delante del servidor que absorbe gran parte de los picos de conexiones nuevas, en cuyo caso el ajuste de kernel pierde urgencia.
¿Qué parámetros hay que ajustar para optimizar el kernel Linux ante un pico de tráfico?
La receta que aplican en el artículo original sube los límites de cola, activa syncookies y acelera el ciclo de vida de los sockets, todo en un archivo nuevo: /etc/sysctl.d/99-network-tuning.conf. No es una lista al azar: cada grupo de parámetros ataca un punto distinto del problema que describimos arriba.
| Parámetro | Valor sugerido | Qué resuelve |
|---|---|---|
| net.core.somaxconn | 4096 | Amplía la cola Accept (conexiones establecidas esperando accept()) |
| net.ipv4.tcp_max_syn_backlog | 4096 | Amplía la cola SYN (handshakes a medio completar) |
| net.ipv4.tcp_syncookies | 1 | Evita descartar conexiones cuando la cola SYN se llena |
| net.ipv4.tcp_synack_retries | 2 | Libera sockets huérfanos en 7 segundos en vez de 30+ |
| net.ipv4.tcp_fin_timeout | 15 | Reduce el tiempo en FIN-WAIT-2 de 60 a 15 segundos |
| net.ipv4.ip_local_port_range | 10240-65535 | Pasa de ~28.000 a ~55.000 puertos efímeros disponibles |
Los parámetros de buffer (net.core.rmem_max y net.core.wmem_max en 16MB) completan la receta para instancias de 2GB a 8GB de RAM. Nada de esto exige reinstalar nada: es texto plano en un archivo de configuración. Si querés profundizar en administración de Linux para infraestructura en general, tenemos una guía más amplia sobre fundamentos de Linux para DevOps.
¿Alcanza con tocar el kernel o también hay que ajustar la aplicación?
No alcanza. Si solo subís somaxconn en el kernel pero tu Nginx, tu Node.js o tu Gunicorn siguen pidiendo un backlog chico, el límite efectivo sigue siendo el chico. Es el “doble gatekeeper” que menciona la fuente: el kernel pone un techo, pero la aplicación tiene que pedir una cola del mismo tamaño o el ajuste del kernel queda en letra muerta.
En Nginx hay que declarar listen 443 ssl backlog=4096; en el bloque server. En Node.js con Express, el backlog por defecto es 511 y se sube pasando {port, host, backlog: 4096} a server.listen(). En Gunicorn se pasa como flag: gunicorn --backlog 4096 -b 0.0.0.0:8000 app:wsgi_app. Subís el kernel, tocás el archivo de sysctl, reiniciás el servicio, probás con curl y la conexión sigue cayendo porque te olvidaste del backlog de la app: ese es, literalmente, el error más común de todo este proceso.
¿Cómo aplicar los cambios de sysctl sin reiniciar el servidor?
Con sudo sysctl --system el kernel carga el archivo nuevo sin necesidad de reboot, siempre que lo hayas guardado en /etc/sysctl.d/99-network-tuning.conf. Después se verifica con sysctl net.core.somaxconn net.ipv4.tcp_max_syn_backlog net.ipv4.tcp_tw_reuse, que debería devolver los valores nuevos (4096, 4096 y 1) en pantalla.
Dicho esto: estos valores funcionaron para una instancia puntual con una carga puntual. Habría que correr pruebas de carga escalonadas con una herramienta tipo Autocannon antes de confiar en que la misma receta aguanta en otro servidor con otro perfil de tráfico. Lo que sirve como diagnóstico (ver si TcpExtListenOverflows sube) es más confiable que copiar y pegar un sysctl ajeno sin medir antes y después.
Errores comunes al ajustar el kernel para tráfico alto
- Subir solo somaxconn y creer que ya está: el backlog de la aplicación (Nginx, Node, Gunicorn) sigue limitando la cola si no se ajusta en paralelo.
- No verificar con ss antes y después: aplicar sysctl sin mirar Recv-Q/Send-Q antes es cambiar a ciegas; sin la comparación no sabés si realmente resolviste algo.
- Copiar la receta de 4096 sin medir la carga real: una instancia con 1GB de RAM puede no tener margen para buffers de 16MB en
rmem_max/wmem_max; hay que mirar la memoria disponible y el pico de tráfico esperado primero. - Ignorar los contadores de dmesg: un mensaje de “Possible SYN flooding” en el ring buffer es una alerta temprana que casi nadie revisa hasta que ya es tarde.
Preguntas Frecuentes
¿Por qué un servidor con CPU libre devuelve error 502?
Porque el 502 no siempre lo genera la aplicación: el kernel Linux puede estar descartando conexiones TCP en la cola Accept o SYN antes de que el proceso de la app las vea. La CPU puede estar al 32% y la memoria casi libre, pero si net.core.somaxconn está en 128, un pico de tráfico llena esa cola en segundos.
¿Qué es net.core.somaxconn y para qué sirve?
net.core.somaxconn es el parámetro del kernel que define el tamaño máximo de la cola Accept, donde esperan las conexiones TCP ya establecidas hasta que la aplicación llame a accept(). El valor por defecto en muchas distros cloud es 128, pensado para cargas mucho más bajas que las actuales.
¿Cómo saber si el kernel está descartando conexiones TCP?
Corriendo ss -lnt y mirando si Recv-Q llegó al valor máximo de Send-Q en un socket LISTEN, o ejecutando nstat -az TcpExtListenOverflows TcpExtListenDrops. Si ese contador es mayor a cero, el servidor descartó conexiones reales por saturación de cola.
¿Qué diferencia hay entre la cola SYN y la cola Accept?
La cola SYN guarda conexiones a medio completar, esperando el ACK final del cliente, y la limita tcp_max_syn_backlog. La cola Accept guarda conexiones ya establecidas que esperan a que la aplicación las recoja con accept(), y la limita net.core.somaxconn junto con el backlog que pide la propia app.
¿Cómo configurar sysctl para soportar picos de tráfico?
Creando un archivo en /etc/sysctl.d/99-network-tuning.conf con valores como net.core.somaxconn=4096 y net.ipv4.tcp_max_syn_backlog=4096, aplicándolo con sudo sysctl --system sin necesidad de reiniciar el servidor. Después hay que verificar con sysctl que los valores quedaron cargados, ajustar también el backlog de la aplicación y, si es posible, estimar el valor según el pico de tráfico real en lugar de copiarlo literal.
Conclusión
El caso de este servidor de 2 vCPU muestra algo que conviene chequear antes de culpar al código: los límites de red del kernel Linux suelen quedar en su configuración de fábrica, pensada para un tráfico de hace veinte años. Subir CPU o RAM no resuelve nada si la cola Accept sigue en 128 conexiones.
Lo accionable es concreto: correr ss -lnt y los contadores de nstat para confirmar si hay overflows, estimar el pico de tráfico real antes de elegir un valor de backlog, y aplicar el ajuste de sysctl en paralelo con el backlog de Nginx, Node.js o Gunicorn. Lo que las fuentes no permiten concluir es que estos mismos valores (4096, syncookies, rango de puertos ampliado) sean óptimos para cualquier servidor: cada instancia tiene su propio perfil de memoria y tráfico, y conviene medir antes y después del cambio. Si estás evaluando dónde alojar una infraestructura que pueda escalar sin sorpresas, en donweb.com se puede armar un VPS en Argentina con margen para este tipo de ajustes.