pg_knowledge_base: SPARQL dentro de PostgreSQL 19
En pocas palabras: pg_knowledge_base, extensión de Igor Suhorukov publicada el 23 de octubre de 2026, embebe el motor SPARQL de Oxigraph (Rust) dentro de PostgreSQL 19. Guarda triples RDF en tablas comunes (kb.quads, kb.terms), mapea tablas SQL vía R2RML y ejecuta consultas combinadas sin un triple store separado ni ETL.
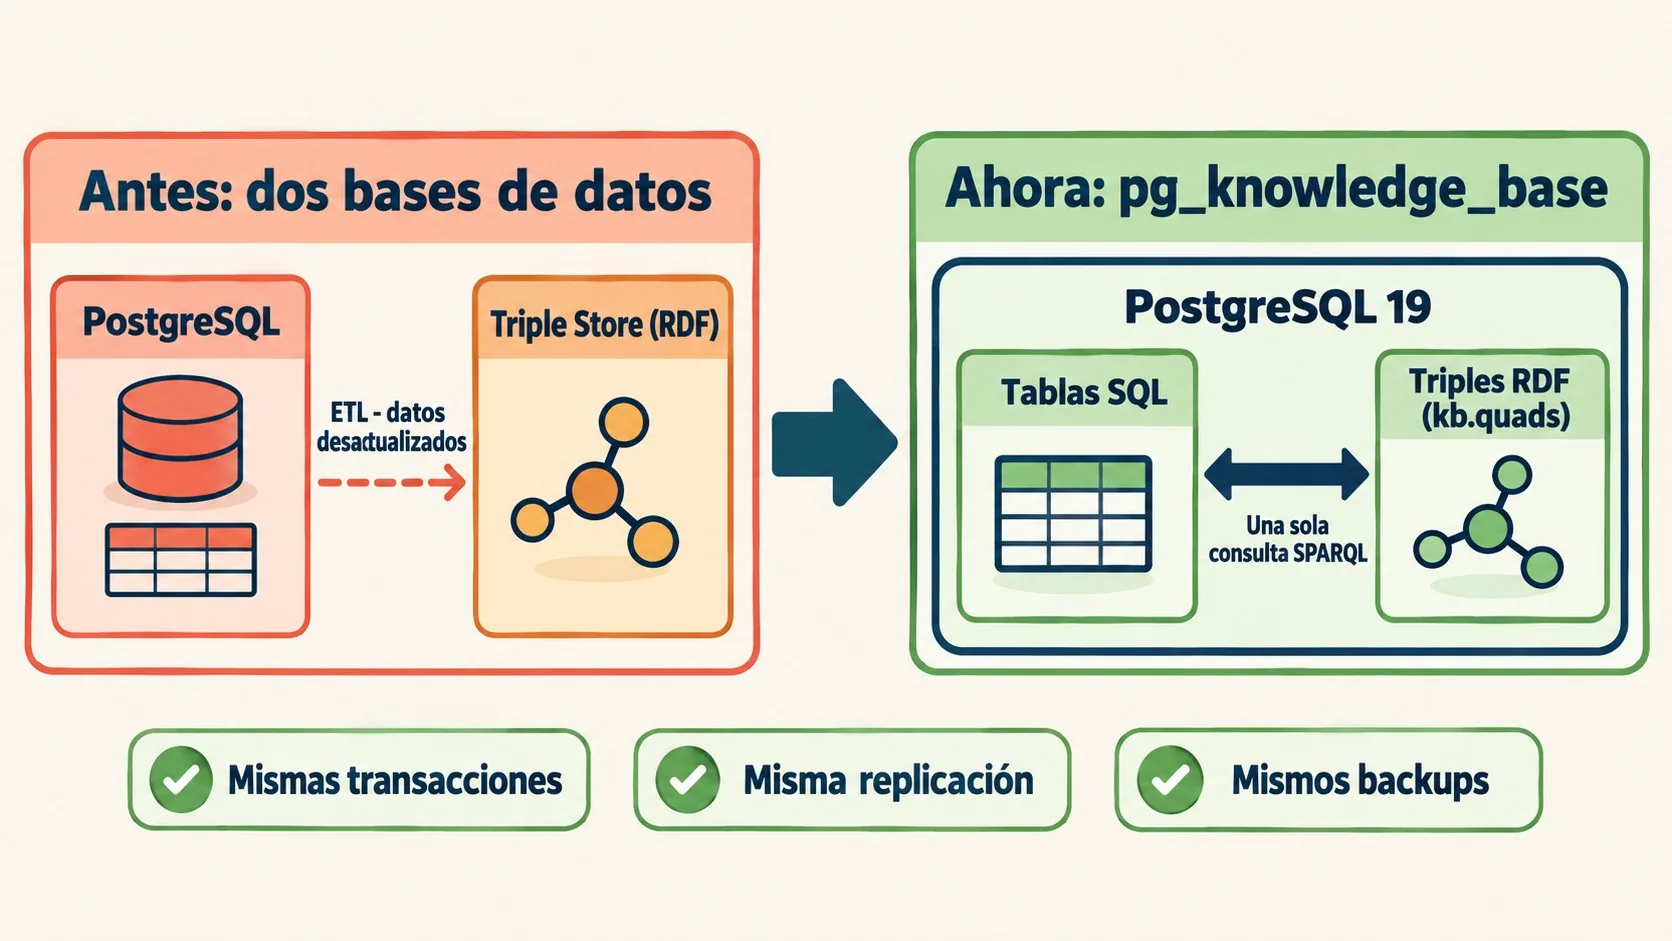
Igor Suhorukov publicó el 23 de octubre de 2026 pg_knowledge_base, una extensión para PostgreSQL 19 que corre el motor SPARQL de Oxigraph dentro del propio servidor de base de datos. El resultado es concreto: una sola consulta SPARQL en PostgreSQL puede leer triples RDF y filas de tablas SQL comunes en la misma transacción, sin copiar nada a un triple store aparte.
SPARQL en PostgreSQL es, en este caso puntual, la posibilidad de ejecutar consultas del lenguaje de grafos RDF directamente sobre una base PostgreSQL 19, sin exportar datos a un motor externo. pg_knowledge_base es la extensión de Igor Suhorukov que lo logra: incrusta el motor Oxigraph (escrito en Rust) dentro del backend de PostgreSQL, guarda los triples en tablas comunes y permite mapear tablas SQL existentes como RDF usando R2RML.
En este artículo:
- En 30 segundos
- ¿Qué es pg_knowledge_base y qué problema resuelve?
- ¿Cómo funciona la extensión por dentro?
- ¿Cómo se combinan triples y tablas SQL en una sola consulta?
- ¿Qué tan rápido es comparado con un triple store dedicado?
- ¿Cuándo tiene sentido evaluar esto y cuándo conviene no molestarse?
- ¿Qué pasa con replicación, backups y alta disponibilidad?
- ¿Qué tan maduro y confiable es el proyecto hoy?
- ¿Qué está confirmado y qué queda pendiente de pg_knowledge_base?
- Errores comunes al evaluar algo como pg_knowledge_base
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- pg_knowledge_base es una extensión para PostgreSQL 19 que corre el motor SPARQL de Oxigraph dentro del servidor, sin parches al núcleo.
- Los triples viven en tablas kb.quads y kb.terms, con claves de 16 bytes y SipHash de 120 bits para IRIs largos.
- Pasa 990 de los tests W3C de SPARQL 1.1 (query/update), con 11 diferencias conocidas y 6 saltados, igual que el test runner propio de Oxigraph.
- En consultas de agregación pesada sobre un dataset de 3.577.116 triples, el endpoint de la extensión midió 1.174 ms contra 9.764 ms de Oxigraph standalone con RocksDB, según el propio benchmark de Suhorukov.
- Replica, se respalda y se recupera con las herramientas estándar de PostgreSQL: streaming replication, logical replication, pg_dump y pg_basebackup.
¿Qué es pg_knowledge_base y qué problema resuelve?
pg_knowledge_base resuelve el problema de mantener una base de conocimiento RDF separada de la base relacional. En vez de copiar datos a un triple store con un job ETL, la extensión deja que una sola consulta SPARQL en PostgreSQL lea triples y filas de tablas SQL al mismo tiempo, dentro de la misma transacción.
En su publicación anterior, según cuenta Suhorukov en el anuncio técnico de pg_knowledge_base, un amigo suyo mantenía cuatro bases de datos distintas en producción. Pedile a un equipo así un knowledge graph y ya sabés cuál es la quinta: un triple store aparte.
Ese servidor extra tiene un costo real. Los hechos que necesita ya están en las tablas de PostgreSQL, así que alguien arma un ETL que los copia como triples, y la copia queda vieja apenas termina el job (spoiler: siempre queda vieja). Dos bases significan dos modelos de seguridad, dos calendarios de backup, dos procedimientos de failover y ninguna transacción que abarque una fila y un triple a la vez.
¿Cómo funciona la extensión por dentro?
El motor de pg_knowledge_base es libkb_engine.so, una librería en Rust compilada a partir de los crates de Oxigraph (spargebra, sparopt, spareval, sparesults y oxrdfio) y expuesta con un ABI en C. La extensión que la envuelve está escrita en C puro, y eso le permite correr adentro de un backend de PostgreSQL sin que el núcleo necesite ningún parche.
La pieza clave es el trait QueryableDataset de spareval, que le permite a Suhorukov reutilizar el parser, el optimizador y el evaluador de Oxigraph tal cual, cambiando únicamente el almacenamiento: tablas de PostgreSQL en vez de RocksDB. ¿Y cómo evitan que un error de PostgreSQL rompa el código en Rust, o al revés? Cada callback (escanear el store, buscar términos, escribir quads, correr el SQL de R2RML) corre bajo PG_TRY, y cada punto de entrada atrapa panics de Rust antes de que esa falla cruce la frontera con C. Es el mismo tipo de frontera cuidadosa que suele faltar cuando un proyecto mezcla lenguajes sin pensar en los límites de cada runtime.
El almacenamiento en sí son tablas comunes. kb.quads guarda cada quad como cuatro claves de 16 bytes en seis órdenes btree (la versión de PostgreSQL de las nueve ordenaciones que Oxigraph mantiene en RocksDB). Números, fechas y strings cortos se guardan en línea; los IRIs y valores largos se convierten en un hash SipHash de 120 bits, con el texto completo en el diccionario kb.terms. Eso significa que las constantes de una consulta ya son claves sin necesidad de lookup, y el motor hace los joins directamente sobre esas claves, dentro del snapshot del llamador. La memoria queda limitada por kb.engine_memory_limit, y un statement_timeout corta la ejecución como a cualquier otra consulta.
¿Cómo se combinan triples y tablas SQL en una sola consulta?
Se combinan sin copiar nada: un mapeo R2RML describe una tabla SQL existente como RDF, y desde ese momento cualquier consulta SPARQL puede leer esa tabla como si fuera parte del grafo. Suhorukov lo muestra con un caso bien concreto en su post.
Ponele que tenés una tabla employees con Alice, Bob y Carol, cada uno con su departamento, y por otro lado cargás con kb.load() una taxonomía SKOS de habilidades: PostgreSQL y SPARQL son “más específicos” que Relacional y Grafos respectivamente, y ambos caen bajo la categoría Databases. kb.load() acepta Turtle, N-Triples, N-Quads, TriG, RDF/XML, JSON-LD y N3, y kb.load_file() con bulk=true reconstruye los índices alrededor de una carga grande.
Con kb.add_mapping() se define el R2RML que traduce cada fila de employees a un recurso foaf:Person con su nombre y departamento. Nada se copia: la tabla sigue siendo la tabla. Una sola consulta pregunta entonces quién sabe algo de bases de datos, usando skos:broader* para recorrer la taxonomía en el store y foaf:name más ex:dept leídos directo de la tabla SQL. El resultado real que reporta el post: Alice, Platform, PostgreSQL; Bob, Analytics, SPARQL.
La función kb.sparql() devuelve filas, así que se puede meter en un JOIN, agrupar con GROUP BY o usar en una vista. Y kb.sparql_update() corre dentro de la transacción del que llama: en el ejemplo del post, Carol cambia de departamento en la tabla SQL y aprende SPARQL en el grafo, todo en el mismo BEGIN/COMMIT. Un ROLLBACK ahí deshace las dos cosas juntas, porque para PostgreSQL es una sola transacción, no dos sistemas sincronizados a medias.
¿Qué tan rápido es comparado con un triple store dedicado?
Depende de la consulta, y ahí está lo interesante. Como pg_knowledge_base y el servidor de Oxigraph usan el mismo evaluador (spareval), lo que se termina midiendo es el almacenamiento, no el motor de consultas. Suhorukov armó un dataset con la forma del Berlin SPARQL Benchmark de e-commerce, 3.577.116 triples, y corrió 14 consultas contra tres caminos distintos: Oxigraph standalone con RocksDB, el endpoint HTTP de la extensión, y SQL directo sobre las tablas mapeadas. Las medianas son de 5 corridas en una máquina idle de 32 núcleos, sobre un build beta de PostgreSQL 19 de octubre de 2026 (el mismo mes de este anuncio), con assertions activadas.
| Consulta | Oxigraph (RocksDB) | Endpoint pg_knowledge_base | SQL directo |
|---|---|---|---|
| Triples de un producto | 0,54 ms | 0,65 ms | 0,14 ms |
| Productos con una feature, filtrados y ordenados, top 10 | 14,9 ms | 2,81 ms | 2,58 ms |
| Todas las ofertas agrupadas por país del vendedor | 9.764 ms | 1.174 ms | 1.203 ms |
En la consulta más simple, Oxigraph standalone le gana apenas al endpoint (0,54 ms contra 0,65 ms), pero ninguno de los dos le gana a SQL puro, que resuelve lo mismo en 0,14 ms porque es un lookup por clave primaria y no necesita pasar por SPARQL para nada. Donde la diferencia se vuelve brutal es en la agregación pesada: el endpoint corrió 1.174 ms contra los 9.764 ms de Oxigraph con RocksDB, casi 8 veces más rápido, porque shared_buffers de PostgreSQL mantenía todo el store en caché mientras Oxigraph corría con su caché RocksDB por defecto de solo 32 MB (con un caché más grande probablemente rendiría mejor, pero su CLI no tiene una opción para configurarlo). Eso sí: son números de un solo desarrollador, en su propia máquina, sobre un build beta de PostgreSQL 19 de octubre de 2026 con assertions prendidas, no sobre el release estable. Todavía no hay ninguna medición independiente que confirme estos resultados en otro hardware.
¿Cuándo tiene sentido evaluar esto y cuándo conviene no molestarse?
Los tres números de la tabla anterior ya sugieren un criterio de decisión, aunque la fuente no lo plantea explícitamente como tal: la ventaja de pg_knowledge_base no está en reemplazar lookups simples (ahí gana SQL puro, por lejos), sino en patrones de consulta que combinan jerarquía o grafo con filtros relacionales en la misma operación.
Ejemplo hipotético (no reportado por la fuente, solo para ilustrar el criterio): imaginemos un sistema de soporte técnico donde los tickets viven en una tabla PostgreSQL normal, y el catálogo de productos —con relaciones de “es parte de” o “incluye a” entre familias y sub-familias— está modelado como una taxonomía SKOS. Si el equipo necesita saber qué tickets abiertos tocan productos de una familia completa (no un producto puntual, sino cualquiera de sus variantes y sub-variantes), hoy esa pregunta requeriría sincronizar el catálogo a un triple store aparte o escribir SQL recursivo cada vez que la taxonomía cambia de forma. Bajo el enfoque que describe Suhorukov, la misma consulta SPARQL recorrería la jerarquía de productos en el store y filtraría por estado del ticket directo en la tabla SQL, sin paso intermedio.
De ahí se pueden sacar algunos criterios concretos antes de evaluar la extensión en serio:
- Si el acceso es por clave conocida (buscar un producto, un empleado, un ticket puntual): SQL directo ya es más rápido que cualquier camino SPARQL, según el propio benchmark. No hay razón para sumar esta capa ahí.
- Si el patrón es jerárquico y variable (recorrer niveles de una taxonomía que cambia de profundidad): es el caso donde la combinación triples+tablas tiene sentido, porque evita reescribir SQL recursivo cada vez que la jerarquía crece.
- Si el volumen de datos jerárquicos es chico y estable: probablemente una tabla de adyacencia con CTE recursiva en SQL puro resuelva lo mismo sin sumar una extensión nueva al stack.
- Si el equipo ya depende de un triple store separado solo para evitar ETL contra PostgreSQL: este es el escenario que la fuente describe como motivador original, y donde el ahorro de infraestructura es más claro.
¿Qué pasa con replicación, backups y alta disponibilidad?
Funciona igual que cualquier tabla de PostgreSQL, porque técnicamente es cualquier tabla de PostgreSQL. El store son tablas heap con índices btree, así que cada escritura SPARQL pasa por el WAL como cualquier INSERT o UPDATE normal.
Suhorukov probó los ejemplos del post en tres escenarios: un primario, una réplica de streaming replication y un suscriptor de logical replication. Un hot standby responde kb.sparql() igual que el primario, triples de R2RML incluidos, porque las tablas mapeadas también replican. kb.sparql_update() ahí falla, como falla cualquier escritura en un standby. El endpoint HTTP se queda en silencio en la réplica y arranca solo después de un pg_ctl promote, con los mismos paths, roles y contraseñas que tenía antes.
Con logical replication hay que publicar kb.quads, kb.terms, kb.graphs, kb.mappings y las tablas mapeadas. La identidad de réplica de kb.quads es su índice único, incluso después de que una carga masiva lo reconstruya, así que un DELETE/INSERT por SPARQL en el publicador llega sin problema al suscriptor. pg_dump y pg_restore se llevan el store y los mapeos sin configuración especial, y pg_basebackup junto con point-in-time recovery los tratan como a cualquier otra tabla.
¿Qué tan maduro y confiable es el proyecto hoy?
Los números del propio W3C son sólidos, pero hay que leerlos con el contexto correcto. De los tests de SPARQL 1.1 query y update, 990 pasan y ninguno falla. Otros 11 difieren del resultado esperado exactamente igual que el store propio de Oxigraph, sobre todo porque mantiene los literales tipados como valores (un “01”^^xsd:integer vuelve como 1), y 6 se saltean, tal como en el test runner del propio Oxigraph. Los tests W3C de R2RML y Direct Mapping pasan 95 de 95.
Ahora bien, esto es un proyecto de un solo desarrollador corriendo sobre un build beta de PostgreSQL 19 de octubre de 2026 con assertions activadas, no sobre un release estable listo para producción. Suhorukov cuenta que Claude Code escribió el código, mientras él se encargó de las decisiones de arquitectura y de revisar los resultados (que no es poco, pero tampoco es lo mismo que una auditoría externa). No es una extensión oficial del proyecto PostgreSQL ni forma parte del core: es un desarrollo independiente que se apoya en las piezas de Oxigraph.
¿Qué está confirmado y qué queda pendiente de pg_knowledge_base?
Confirmado, según el propio anuncio: la extensión corre sobre PostgreSQL 19, se carga vía shared_preload_libraries sin parches al núcleo, pasa los benchmarks W3C citados arriba, replica con las herramientas estándar de PostgreSQL y expone el protocolo SPARQL 1.1 más el Graph Store Protocol por HTTP, con logins validados contra pg_hba.conf igual que un backend común.
- No hay versión estable publicada: todas las pruebas corrieron sobre un build beta de PostgreSQL 19 de octubre de 2026 con assertions, no sobre un release de producción.
- No hay benchmarks independientes: los números de velocidad son los que midió el propio Suhorukov en su hardware; nadie los replicó todavía de forma externa.
- No está claro el plan de mantenimiento: el post no menciona versionado, soporte continuo ni intención de sumar el proyecto a un repositorio oficial de extensiones.
- No hay casos de uso en producción real reportados: más allá del ejemplo demostrativo y el benchmark sintético, no hay datos públicos de adopción.
Errores comunes al evaluar algo como pg_knowledge_base
- Creer que reemplaza a un triple store para cualquier volumen: el propio benchmark muestra que un lookup simple por clave primaria en SQL (0,14 ms) le gana por lejos a cualquier camino SPARQL, incluso al endpoint embebido.
- Asumir que “corre adentro de PostgreSQL” significa “listo para producción”: todas las mediciones son sobre un build beta de PostgreSQL 19 de octubre de 2026 con assertions, no sobre un release estable.
- Diseñar mapeos R2RML sin pensar en los patrones de acceso: un patrón con términos no acotados puede traducirse en un escaneo completo de la tabla mapeada en vez de un lookup por clave, y ahí se pierde toda la ventaja de velocidad.
- Confundir “sin ETL” con “sin diseño”: igual hay que pensar bien el esquema de kb.quads y kb.terms, porque un mapeo mal pensado degrada el rendimiento tanto como en cualquier otra base.
Preguntas Frecuentes
¿Qué es pg_knowledge_base y qué problema resuelve?
pg_knowledge_base es una extensión de PostgreSQL 19 creada por Igor Suhorukov que corre el motor SPARQL de Oxigraph dentro del servidor de base de datos. Resuelve el problema de mantener un triple store separado con ETL que copia datos y se queda desactualizado, permitiendo que SQL y SPARQL compartan la misma transacción.
¿Se puede usar SPARQL sin instalar un triple store separado?
Sí, con pg_knowledge_base las consultas SPARQL corren directamente dentro de PostgreSQL 19, sin necesidad de levantar un servidor de triples aparte. Los triples se guardan en tablas comunes (kb.quads y kb.terms) y las tablas SQL existentes se pueden mapear como RDF con R2RML, sin copiar datos.
¿Qué es Oxigraph y por qué lo usaron dentro de PostgreSQL?
Oxigraph es un motor de base de datos de grafos y herramientas RDF escrito en Rust, con el objetivo declarado de ser compatible con los estándares, seguro y rápido. Suhorukov lo eligió porque su stack de consultas está dividido en crates pequeños (spargebra, sparopt, spareval) que se pueden reutilizar completos, cambiando solo el almacenamiento por tablas de PostgreSQL en vez de RocksDB.
¿Cómo se combinan tablas SQL normales con triples RDF en una sola consulta?
Se combinan mediante un mapeo R2RML que describe una tabla SQL existente como recursos RDF, sin copiar ningún dato. Una sola consulta SPARQL puede entonces recorrer una taxonomía almacenada como triples (por ejemplo con skos:broader*) y al mismo tiempo leer columnas como nombre o departamento directo de la tabla SQL original.
¿pg_knowledge_base funciona con replicación y backups estándar de PostgreSQL?
Sí, porque el store son tablas heap comunes con índices btree, cada escritura pasa por el WAL igual que cualquier otra tabla. Suhorukov confirma que funciona con streaming replication, logical replication, pg_dump, pg_restore y pg_basebackup, aunque las escrituras SPARQL fallan en un standby igual que cualquier escritura SQL.
Conclusión
Lo que cambia con pg_knowledge_base no es que SPARQL ahora “funcione” (eso ya lo hacía Oxigraph solo), sino que deja de necesitar un segundo servidor, un segundo modelo de seguridad y un ETL que siempre queda atrasado. Para un equipo que ya tiene sus datos en PostgreSQL y necesita una capa de conocimiento tipo taxonomía, ontología de productos o grafo de habilidades, la propuesta es bastante directa: una transacción, un backup, un failover.
Dicho esto, antes de meter esto en producción conviene un criterio simple: correr el propio benchmark de Suhorukov (o uno equivalente con tu volumen real de datos) contra tu hardware, comparando los tres caminos (SPARQL puro, endpoint, SQL directo) con las mismas consultas que vas a usar en serio, y recién después decidir si el ahorro de infraestructura compensa el riesgo de depender de una extensión que todavía corre sobre un build beta de octubre de 2026. No es una conclusión que la fuente proponga; es, simplemente, el paso lógico antes de confiarle datos de producción a cualquier extensión nueva.