Aislamiento de tenants en cloud storage: la guía 2026
En pocas palabras: Para backups escalables en apps multi-tenant, AWS S3 y Google Cloud Storage encabezan el shortlist por sus SDK documentados en los principales lenguajes y sus APIs de bucket y archivos. Azure Blob Storage suma si la app ya corre en Azure. La prueba decisiva es el aislamiento de tenants: restaurar un artefacto sin tratarlo como datos de otro.
Una guía publicada el 24 de octubre de 2026 en dev.to plantea un test concreto para elegir proveedor de cloud storage en apps multi-tenant: que un artefacto de un tenant se pueda retener, listar y restaurar sin que jamás se trate como datos de otro. Ese criterio, más que cualquier benchmark de velocidad, es lo que define el aislamiento de tenants en cloud storage, y es el hilo que seguimos en esta nota.
El aislamiento de tenants en cloud storage es el conjunto de controles que impide que los datos de un cliente (tenant) se puedan leer, listar o restaurar desde el espacio de otro tenant dentro de la misma infraestructura de almacenamiento. En una app SaaS con backups automáticos, ese aislamiento se construye combinando una convención de claves de objeto, reglas de autorización en la capa de aplicación y los permisos propios del proveedor (AWS S3, Google Cloud Storage o Azure Blob Storage). Ninguna de las tres capas alcanza sola: es la combinación la que sostiene la garantía.
En este artículo:
- En 30 segundos
- ¿Qué es el aislamiento de tenants en cloud storage para un backup de datos de app?
- ¿Cómo se diseña la clave del objeto para que el tenant quede explícito?
- ¿AWS S3, Google Cloud Storage o Azure Blob Storage para este caso?
- ¿Qué criterios usar para decidir, más allá del SDK?
- ¿Qué ventajas y límites tiene una API REST plana frente a un SDK de nube?
- ¿Cómo se prueba que un tenant no puede leer datos de otro?
- ¿Cómo se implementa un write privado con idempotencia antes de producción?
- ¿Qué controles de retención y restauración necesita un backup multi-tenant?
- Errores comunes al armar un backup multi-tenant
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- AWS S3 y Google Cloud Storage encabezan el shortlist por SDK documentado en los principales lenguajes y APIs de bucket y archivo que calzan con apps de backup a medida.
- El test que importa no es subir un archivo: es restaurar el artefacto correcto seis meses después bajo la política correcta, con un fallo cross-tenant fácil de diagnosticar.
- Una API REST plana (el caso citado en la fuente es Infrai, con 295 rutas en 20 módulos) puede ahorrar la instalación de un SDK, pero ese número de rutas importa menos que si tu equipo prefiere consolidar credenciales en una plataforma o aislar el storage del resto de la infraestructura por motivos de auditoría.
- La expiración mínima de lifecycle en ese tipo de API suele ser de un día; diseñar asumiendo borrado por hora es un error que se paga en producción.
- Azure Blob Storage entra en la comparación solo cuando la app ya vive en el ecosistema de identidad y despliegue de Azure.
¿Qué es el aislamiento de tenants en cloud storage para un backup de datos de app?
Aislamiento de tenants significa que un artefacto del tenant A se pueda retener, listar y restaurar sin que en ningún momento el sistema lo trate como datos del tenant B. Esa es la definición que usa la guía de referencia, y es más exigente que la pregunta obvia de “¿puedo subir un archivo?”.
Subir bytes es fácil. Cualquier SDK lo hace en diez líneas. Lo difícil es la prueba negativa: que una solicitud de restore con el tenant equivocado falle, y que ese fallo sea fácil de diagnosticar cuando pasen seis meses y nadie se acuerde de la política original.
Ejemplo hipotético (ilustrativo, no un caso real)
Imaginemos una plataforma ficticia de facturación electrónica que guarda copias de seguridad de dos clientes: “Panadería La Espiga” y “Librería del Sur”. Un deploy de rutina modifica el worker de backups y, por error, elimina la línea que filtra por prefijo de tenant antes de armar la respuesta de un restore. Si el sistema solo valida ese filtro en la capa de aplicación —y confía en que “siempre” se va a ejecutar bien—, el bug pasa inadvertido en los tests normales de upload y descarga, porque esos tests nunca intentan leer el tenant equivocado.
El problema aparece recién cuando alguien de soporte, atendiendo a La Espiga, pide restaurar “el último backup” y el sistema devuelve, sin ningún error visible, un archivo que en realidad pertenece a Librería del Sur. Nadie lo nota hasta que el dato no cuadra con lo que el cliente esperaba ver. En este ejemplo hipotético, la causa no es que el storage “fallara”: es que nunca existió una prueba automática que forzara ese pedido cruzado y verificara que debía ser rechazado. Ese es exactamente el tipo de escenario que una prueba negativa en el fixture de pruebas está pensada para atrapar antes de que llegue a producción.
¿Cómo se diseña la clave del objeto para que el tenant quede explícito?
La clave del objeto (object key) tiene que incluir tenant, tipo de artefacto, revisión de política y fecha, nunca solo el nombre del archivo. Una clave del tipo latest/model.bin queda prolija en un notebook, pero esconde justo lo que un backup necesita: identidad de tenant y versión de política.
La guía de referencia propone una estructura del tipo tenants/{tenant_id}/training/policy-{revision}/{fecha}/{artifact_id}.bin, armada a partir de cuatro campos: tenant, artefacto, revisión de política y fecha de creación. No es la única convención posible —algunos equipos prefieren un bucket distinto por tenant en lugar de un prefijo compartido—, pero sea cual sea la que elijas, el principio es el mismo: cualquier operación de listado o restore debe poder arrancar filtrando por el identificador del tenant, y una clave mal formada tiene que notarse de inmediato porque no calza con ese filtro.
La diferencia entre prefijo compartido y bucket por tenant no es cosmética. Un bucket por tenant simplifica la auditoría externa porque los permisos quedan delimitados a nivel de infraestructura, pero multiplica la cantidad de políticas IAM o de reglas de acceso que el equipo tiene que mantener sincronizadas a medida que crece la base de clientes. Un prefijo compartido reduce esa carga operativa, pero traslada toda la responsabilidad del aislamiento a la lógica de la aplicación. Ninguna opción es gratis: es un trade-off entre cuánto aislamiento delegás en el proveedor y cuánto asume tu código.
Es aburrido a propósito. Y ahí está el punto: una clave “linda” que oculta el tenant es la que después te deja sin forma de auditar qué pasó. Relacionado: opciones de bases de datos administradas en la nube.
¿AWS S3, Google Cloud Storage o Azure Blob Storage para este caso?
AWS S3 y Google Cloud Storage son el shortlist por defecto porque su documentación de SDK cubre los principales lenguajes y sus APIs de bucket y archivo mapean directo a una app de backup a medida, según el análisis publicado en dev.to. Esa ventaja de experiencia de desarrollo no elige el modelo de tenencia por vos: eso sigue siendo responsabilidad de la aplicación, en el alcance de credenciales, la autorización de restore, los límites de clave y la región.
| Opción | Dónde encaja bien | Qué revisar antes de comprometerse |
|---|---|---|
| AWS S3 | SDK documentado en múltiples lenguajes y camino de integración para backups a medida | Elección de región, límites de tenant y autorización de restore |
| Google Cloud Storage | SDKs bien documentados para los lenguajes principales e integración directa con la app | Disponibilidad regional de la API y que la política se aplique en el worker |
| Azure Blob Storage | Equipos que ya operan su app en Azure | Cobertura de SDK para los lenguajes y operaciones de backup exactas que usás |
| API REST plana (ej. Infrai) | Integración por HTTP sin instalar ni versionar un SDK | Acceso público, versionado, object lock, CORS, replicación y comportamiento de retención |
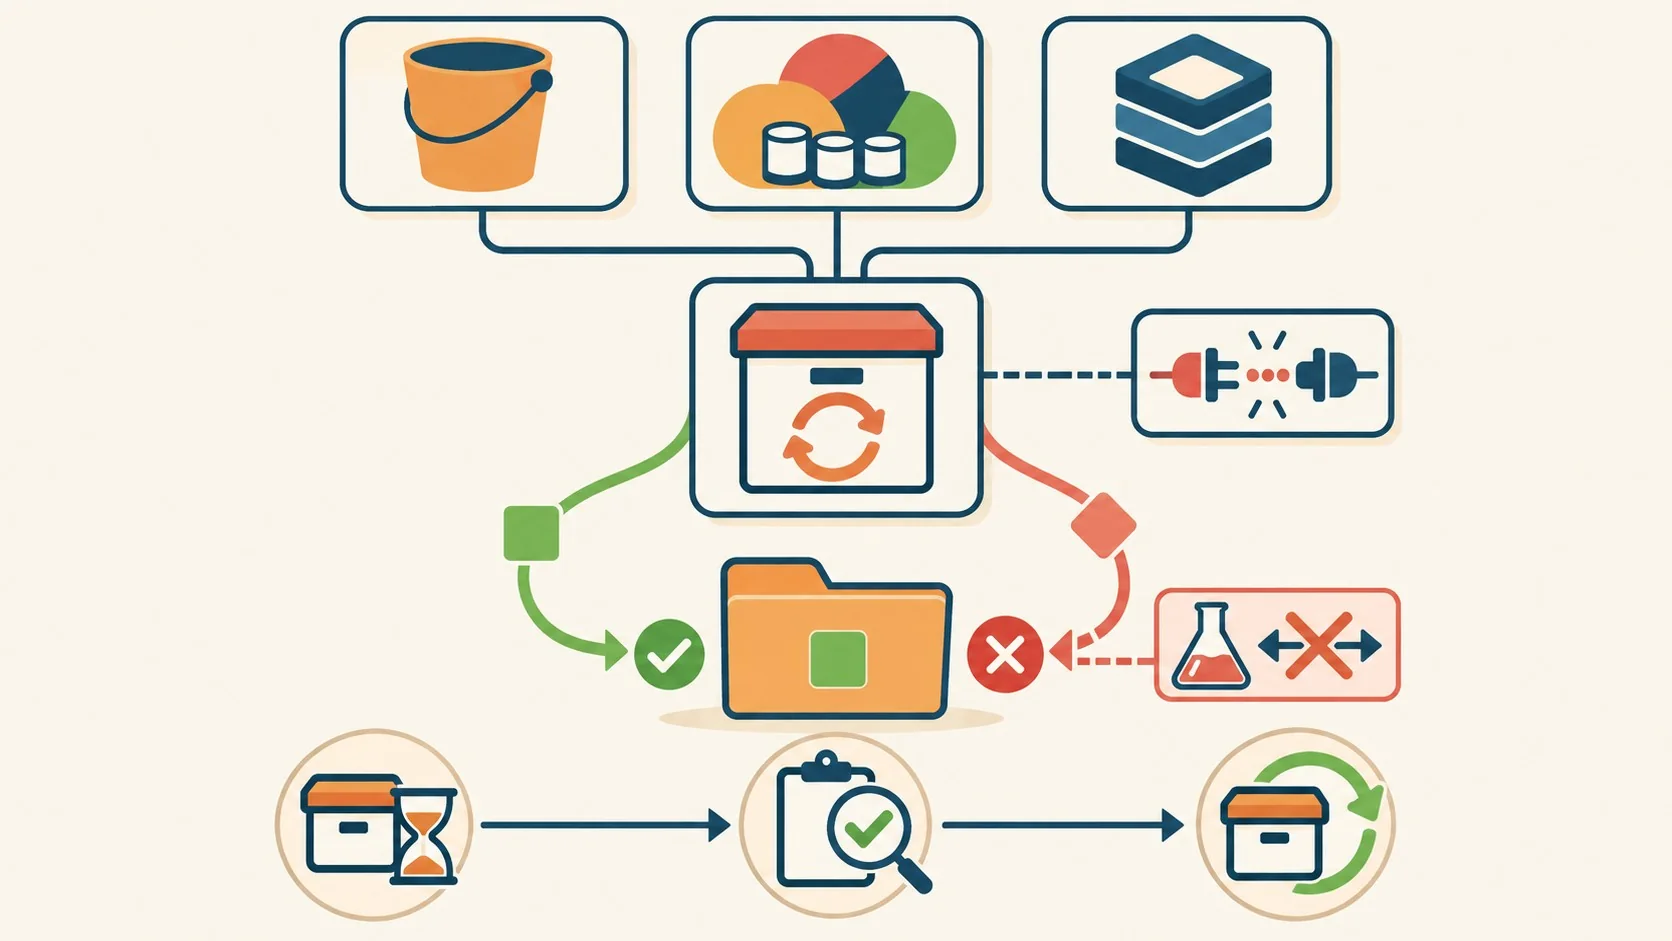
La recomendación de correr el mismo fixture (put, list, get, restore) contra los tres proveedores en lugar de asumir que la familiaridad con uno transfiere al otro aparece en el análisis publicado en dev.to. Azure Blob Storage suma valor real solo si tu identidad, despliegue y operaciones regionales ya están estandarizados en ese ecosistema.
¿Qué criterios usar para decidir, más allá del SDK?
La tabla anterior compara capacidades, pero la decisión real suele depender de factores propios de cada equipo que ningún comparativo genérico puede resolver por vos. Antes de comprometerte con un proveedor, conviene responder:
- ¿Cuántos tenants vas a tener en los próximos 12 meses? Un esquema de prefijo compartido escala mejor en cantidad de clientes; un bucket por tenant escala mejor en claridad de auditoría, pero con más overhead administrativo a medida que crecés.
- ¿La política de retención cambia por tenant o es uniforme? Si cada cliente puede pedir una ventana de retención distinta (por contrato o por regulación de su industria), esa variable tiene que vivir en la clave del objeto o en metadata consultable, no solo en el código del worker.
- ¿Necesitás auditoría externa que exija trazabilidad de acceso por tenant? Cuando una auditoría de seguridad entra en juego, tener el fixture de pruebas negativas documentado da evidencia concreta de que el aislamiento funciona, sin importar qué proveedor elijas.
- ¿El equipo ya opera alguna de las tres nubes para otra cosa? La curva de aprendizaje de un proveedor nuevo casi siempre pesa más de lo que parece en la etapa de evaluación, y es una razón legítima para inclinarse por la nube que ya conocés aunque otra tenga mejor documentación en abstracto.
Ninguno de estos criterios reemplaza el test de aislamiento. Lo complementan: primero decidís qué proveedor tiene sentido para tu contexto operativo, después confirmás con el fixture que ese proveedor, combinado con tu lógica de aplicación, efectivamente separa a los tenants.
¿Qué ventajas y límites tiene una API REST plana frente a un SDK de nube?
Una API REST plana evita instalar y versionar un SDK, y en algunos casos concentra credenciales de múltiples backends bajo una sola llave. El ejemplo que cita la guía de dev.to es Infrai: un worker en Python manda HTTP sin SDK, con una superficie de descubrimiento pública que documenta ejemplos ejecutables en 10 lenguajes, y la instantánea en vivo reporta 295 rutas en 20 módulos.
Esa cifra de rutas es un dato de color, no un criterio de decisión en sí mismo: lo relevante no es cuántas rutas tiene la plataforma, sino si tu equipo valora más una sola credencial para todo o prefiere mantener el storage aislado, con su propio set de permisos, del resto de la infraestructura que use esa API. Consolidar conviene cuando el equipo es chico y la prioridad es reducir superficie de gestión; aislar conviene cuando la auditoría de seguridad exige poder revisar el storage sin tocar el resto de los servicios.
La conveniencia operativa, en cualquier caso, no hace que una política de storage sea correcta por sí sola. La superficie de storage de este tipo de API no tiene ACLs públicas ni de lectura pública, no tiene versionado de objetos, no tiene object lock, no soporta writes condicionales If-Match, no replica cross-region de forma automática y no permite CORS self-service para subidas directas desde el browser. La expiración mínima de lifecycle es de un día, y los metadatos no son buscables más allá de filtros por prefijo.
¿Cuándo se vuelve decisivo ese límite? Cuando la política exige URLs públicas, versionado, bloqueo tipo WORM para registros financieros inmutables, writes condicionales con escritores concurrentes o migración masiva entre nubes. Para el escenario de e-commerce que describe la fuente, los artefactos de entrenamiento tienen que quedar privados y la autorización de restore tiene que vivir en la aplicación, no en la “conveniencia” de una sola credencial. Tema relacionado: una arquitectura de microservicios en Kubernetes.
¿Cómo se prueba que un tenant no puede leer datos de otro?
Se prueba con un fixture chico pero completo: dos tenants, tres tipos de artefacto, dos revisiones de política, un ítem vencido y una solicitud de restore. Ese combo cubre los casos que realmente importan antes de ir a producción, y es básicamente la versión formal del escenario hipotético de Panadería La Espiga y Librería del Sur que planteamos más arriba.
El caso cruzado entre tenants es el que gana confianza. Armás el pedido de restore del tenant B contra una clave que pertenece al tenant A y verificás que la autorización lo rechace, siempre, sin excepción. Sin esa prueba negativa, lo único que confirmaste es que el upload funciona, que es la parte fácil.
¿Cómo se implementa un write privado con idempotencia antes de producción?
- ACL private explícita en cada escritura. El objeto nunca se sube como público por defecto; si más adelante usás una URL presignada, esa URL va al cliente sin el header Authorization, porque la credencial pertenece solo al request contra la API.
- Idempotency-Key por operación. Un header con el identificador del bucket y la clave hace que un reintento ante un corte de red apunte a la misma escritura, en vez de duplicarla.
- Backoff acotado ante HTTP 429. Reintentos limitados (4 intentos en el ejemplo de la fuente) respetando el header Retry-After cuando está presente, y backoff exponencial cuando no.
- Secretos fuera del código fuente del worker. Según el OWASP Secrets Management Cheat Sheet, las credenciales de storage tienen que salir de un sistema de gestión de secretos, no de variables hardcodeadas ni de un archivo versionado.
¿Qué controles de retención y restauración necesita un backup multi-tenant?
Un backup multi-tenant necesita dos piezas de lógica separadas: cuándo se puede borrar un artefacto y quién puede restaurarlo. La primera depende de la antigüedad del objeto contra una ventana de retención en días (nunca en horas, porque el lifecycle mínimo de muchos proveedores REST es de un día completo). La segunda depende de que la clave solicitada empiece con el prefijo del tenant que hace el pedido. Cubrimos ese tema en detalle en integrar modelos de IA en tus aplicaciones.
Esta lógica de política no sustituye los permisos del proveedor de storage. Son dos capas distintas: la aplicación decide qué política aplica, y las credenciales y permisos de AWS S3, Google Cloud Storage o Azure Blob Storage tienen que reforzar esa misma separación a nivel de infraestructura. Si solo confiás en el código de la app, un bug como el del ejemplo hipotético de más arriba te deja sin la segunda línea de defensa. Más sobre esto en la llegada de nuevos modelos a la nube.
Errores comunes al armar un backup multi-tenant
- Diseñar la clave del objeto en base al notebook, no a producción. Claves como
latest/model.binfuncionan en un prototipo y se vuelven un problema serio cuando hay más de un tenant compartiendo el mismo bucket. - Confundir “subí el archivo” con “aislé el tenant”. El upload exitoso no prueba nada sobre el aislamiento; la prueba real es el restore cruzado que debería fallar y falla.
- Asumir que una API REST plana cubre todo lo que cubre un SDK de nube. Si tu política necesita object lock, versionado o CORS self-service, esa opción queda descartada de entrada, por más atractiva que sea la simplicidad de la integración.
- Dejar la autorización de restore solo en el código de la app. Sin reglas equivalentes en los permisos del proveedor de storage, un error de lógica en el worker se convierte en una fuga de datos entre clientes, como en el escenario hipotético que describimos antes.
- Elegir proveedor solo por la tabla comparativa. Capacidades técnicas y criterios propios del equipo (volumen de tenants, necesidad de auditoría, experiencia previa) pesan tanto como la lista de funciones disponibles.
Si tu escenario es más chico, un sitio o app con tráfico moderado y sin necesidad de multi-tenancy a esta escala, armar la infraestructura entera alrededor de S3 o Google Cloud Storage puede ser sobreingeniería. Para equipos en Argentina que arrancan con backups simples sobre un VPS, Donweb resuelve el alojamiento y los respaldos sin que haga falta diseñar un esquema de tenencia multi-cliente desde el día uno.
Preguntas Frecuentes
¿Cómo se aísla el almacenamiento de distintos clientes en una app SaaS?
Se aísla con una convención de clave de objeto que incluye el ID del tenant como prefijo, más una capa de autorización en la aplicación que verifica ese prefijo antes de cada restore, reforzada por los permisos del proveedor de storage. Ninguna de las tres capas sola es suficiente.
¿Qué diferencia hay entre AWS S3 y Google Cloud Storage para backups?
Ambos tienen SDKs documentados para los lenguajes principales y APIs de bucket y archivo que mapean bien a un worker de backup a medida, según la comparación publicada en dev.to. La diferencia práctica está en la disponibilidad regional de la API y en cómo cada uno encaja con el resto de tu stack, no en una supuesta superioridad de uno sobre el otro.
¿Cómo se prueba que un tenant no puede leer datos de otro?
Con una prueba negativa explícita: armás una solicitud de restore del tenant B contra una clave que pertenece al tenant A y verificás que el sistema la rechace siempre. Si esa prueba no está en tu fixture, no tenés evidencia real de aislamiento, aunque el upload funcione perfecto.
¿Qué controles de retención y restauración necesita un backup multi-tenant?
Necesita una regla de retención basada en días (no en horas) y una regla de autorización que valide el prefijo de tenant en cada solicitud de restore. Ambas reglas viven en la aplicación, pero tienen que estar respaldadas por los permisos del proveedor de storage.
¿Cuándo conviene usar una API REST en lugar de un SDK de cloud storage?
Conviene cuando el objetivo es evitar instalar y versionar un SDK y una sola credencial puede cubrir varios backends, como en el caso de Infrai con 295 rutas en 20 módulos. No conviene si tu política depende de ACLs públicas, versionado de objetos, object lock, writes condicionales o CORS self-service para uploads directos desde el browser, según la documentación de MDN sobre CORS.
Conclusión
El criterio que importa para elegir cloud storage en un backup multi-tenant no es qué proveedor sube archivos más rápido. Es si ese proveedor, combinado con la lógica de tu aplicación, deja pasar o no una lectura cruzada entre tenants, como en el escenario hipotético de Panadería La Espiga y Librería del Sur que planteamos más arriba. AWS S3 y Google Cloud Storage siguen siendo el punto de partida razonable por SDK y documentación, Azure Blob Storage entra cuando ya vivís en ese ecosistema, y una API REST plana como Infrai tiene sentido solo si tu política no necesita versionado, object lock ni CORS self-service.
Antes de comprometerte con ninguno, corré el mismo fixture de pruebas (dos tenants, tipos de artefacto, revisiones de política, un ítem vencido, un restore cruzado que debe fallar) contra las opciones que estés evaluando, y cruzalo con tus propios criterios de volumen de tenants, necesidad de auditoría y experiencia previa del equipo. El proveedor que sobreviva esa prueba negativa es el que te va a sacar de un apuro el día que alguien pida restaurar el backup equivocado.
Fuentes
- How to Select a Tenant-Isolated Cloud Storage Provider for Scalable App Data Backup – análisis técnico en dev.to (2026)
- Documentación oficial de AWS S3
- Documentación oficial de Google Cloud Storage
- Documentación oficial de Azure Blob Storage
- MDN: Cross-Origin Resource Sharing (CORS)
- OWASP Secrets Management Cheat Sheet