Cron, SQL y zonas horarias: errores comunes en producción
En pocas palabras: Tres conversiones rompen en producción sin avisar: un cron como 0 2 * * * puede no ejecutarse el día del cambio de horario porque las 02:00 no existen esa fecha, las comillas dobles cambian de significado entre MySQL, PostgreSQL y SQLite, y guardar un offset fijo en vez de la zona IANA desincroniza timestamps meses después.
Según un análisis publicado en Dev.to, tres problemas —cron, dialectos SQL y zonas horarias— generan errores comunes en producción de software que nadie detecta hasta que ya rompieron algo.
Lo que tienen en común los tres casos no es el dominio técnico, sino el mecanismo del error: en ningún caso hay una excepción, un log rojo o un test que falle. El sistema devuelve algo sintácticamente válido y semánticamente equivocado, y eso es precisamente lo que lo vuelve difícil de atrapar en una revisión de código apurada.
En este artículo:
- En 30 segundos
- ¿Por qué una expresión cron correcta puede no ejecutarse?
- ¿Cuántas veces se ejecuta realmente tu cron job?
- ¿Qué diferencia hay entre un dialecto SQL y otro cuando la consulta no da error?
- Comillas dobles, LIMIT, booleanos y upsert: la tabla que define si tu migración rompe algo
- ¿Por qué guardar un offset en vez de una zona horaria es un error?
- ¿Qué pasa si un usuario ingresa una hora que no existe por el horario de verano?
- ¿Por qué estas herramientas de conversión corren en el navegador y no en un servidor?
- Errores comunes en producción de software: lo que falla en cron, SQL y zonas horarias
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un cron con
0 2 * * *no corre el día de spring forward porque las 02:00-03:00 no existen esa fecha. */15en el campo de minutos son 96 ejecuciones por día;0 0 1 * *son 12 al año, no “todos los meses más o menos”.- Las comillas dobles son texto literal en MySQL (salvo ANSI_QUOTES) pero identificador en PostgreSQL y SQLite: la misma query cambia de significado al migrar.
- Guardar un offset fijo como
2026-03-29T01:30+01:00en vez de una zona IANA comoEurope/Londonproduce timestamps mal calculados meses después. - Las herramientas que analiza la fuente corren el 100% del procesamiento en el navegador: el input nunca sale de la página.
¿Por qué una expresión cron correcta puede no ejecutarse?
Porque cron no define un instante universal, define una regla de calendario local, y los calendarios locales tienen huecos y duplicados el día del cambio de horario. La expresión 0 2 * * * significa “las 2am todos los días”, pero en una zona con horario de verano, el día que los relojes avanzan, las 02:00 directamente no existen.
Ahí está el error de fondo: tratar una expresión cron como si fuera un horario fijo en lugar de una regla que se resuelve distinto según el día. En el salto de primavera (spring forward), el bloque entre las 02:00 y las 03:00 nunca pasa, así que un job anclado a las 02:30 no tiene ningún instante válido ese día. En el retorno de otoño (fall back), el bloque entre 01:00 y 02:00 ocurre dos veces, y un job anclado a las 01:30 tiene dos instantes válidos.
¿Y qué hacen los schedulers con eso? Depende. Muchos saltean la ejecución entera ese día; algunos la corren dos veces en el regreso. Ninguno de los dos comportamientos aparece documentado en ningún lado que alguien lea antes de que explote.
El análisis de Dev.to propone resolver la expresión cron contra una zona horaria real, no contra aritmética UTC, y mostrar explícitamente cuándo la próxima ejecución cae en un hueco de spring forward, en vez de saltar silenciosamente al día siguiente. Esa diferencia es la que separa un reporte de bug claro de un misterio que te come la tarde. Más contexto en cuando el despliegue a producción falla silenciosamente.
Ejemplo hipotético (ilustrativo, no corresponde a un caso real): un equipo programa un job de cierre contable a las 02:30 hora local en un país con horario de verano. El resto del año el job corre sin problema, hasta que un domingo de marzo el bloque 02:00-03:00 directamente no existe en el calendario local. Si nadie definió una política explícita, lo más probable es que el scheduler saltee esa ejecución sin avisar, y el equipo recién lo note días después cuando falte un cierre en el reporte mensual. El punto no es ese job en particular, sino que cualquier tarea anclada a un horario dentro de esa franja comparte el mismo riesgo, sin que el cron expresado “en texto” lo deje ver.
¿Cuántas veces se ejecuta realmente tu cron job?
Buena parte de los tickets de “se nos inundó la cola” nacen de leer mal la frecuencia de una expresión cron. */15 en el campo de minutos no es “cada rato”: son 96 ejecuciones por día. Y 0 0 1 * * no es “todos los meses más o menos”: son 12 ejecuciones al año, una por mes, puntual.
El patrón se repite siempre igual. Alguien copia una expresión de Stack Overflow, la pega en el crontab, ve que “corre” en el log de prueba y da por sentado que la cadencia es razonable, cuando en realidad nadie calculó cuántas veces por día o por mes se va a disparar ese job contra una API externa o una base de datos que no está pensada para ese volumen.
Si administrás tu propia infraestructura, este tipo de cálculo mal hecho genera problemas recurrentes de soporte, porque el síntoma (cola llena, rate limit, CPU al tope) aparece lejos de la causa (una expresión cron que nadie tradujo a “ejecuciones por día” antes de subirla).
¿Qué diferencia hay entre un dialecto SQL y otro cuando la consulta no da error?
La diferencia peligrosa no es el error de sintaxis: ese lo agarra CI en minutos. El problema real son las construcciones que son válidas en MySQL, PostgreSQL y SQLite al mismo tiempo, pero significan cosas distintas en cada motor, así que la consulta corre sin quejarse y devuelve un resultado “plausible” que está mal.
Plausible es, justamente, el resultado más peligroso que existe en una migración de base de datos. Un query que explota en CI lo arregla cualquiera en cinco minutos. Un query que corre bien, devuelve datos con sentido y está mal interpretando una condición, puede estar produciendo reportes incorrectos durante semanas antes de que alguien note el desvío. Te puede servir nuestra cobertura de armar un pipeline CI/CD seguro de verdad.
Según el análisis de Dev.to, la regla que vale acá es traducir solo lo que es demostrablemente equivalente entre dialectos, listar cada cambio hecho, y marcar lo que no se puede traducir con seguridad en lugar de aproximarlo. Un conversor que te dice “se reescribieron 3 construcciones, 1 no se pudo traducir” sirve para revisar una migración. Uno que te devuelve SQL que corre sin avisarte nada es una trampa con forma de herramienta.
Comillas dobles, LIMIT, booleanos y upsert: la tabla que define si tu migración rompe algo
Cinco construcciones concentran casi todos los problemas silenciosos al migrar entre MySQL, PostgreSQL y SQLite, según el detalle del análisis de Dev.to. Ninguna de las cinco tira error de sintaxis en los tres motores: cada uno la acepta, pero la interpreta distinto.
| Construcción | MySQL | PostgreSQL | SQLite |
|---|---|---|---|
| “comillas dobles” | literal de texto (salvo ANSI_QUOTES) | identificador | identificador |
| LIMIT 10, 20 | offset 10, cantidad 20 | error de sintaxis | soporta offset con coma |
| TRUE / FALSE | tinyint 1/0 | booleano real | se guarda como entero 1/0 |
| INSERT … ON DUPLICATE KEY | upsert nativo | necesita ON CONFLICT | ON CONFLICT o INSERT OR REPLACE |
| cast implícito texto→número | permisivo | estricto, tira error | permisivo |
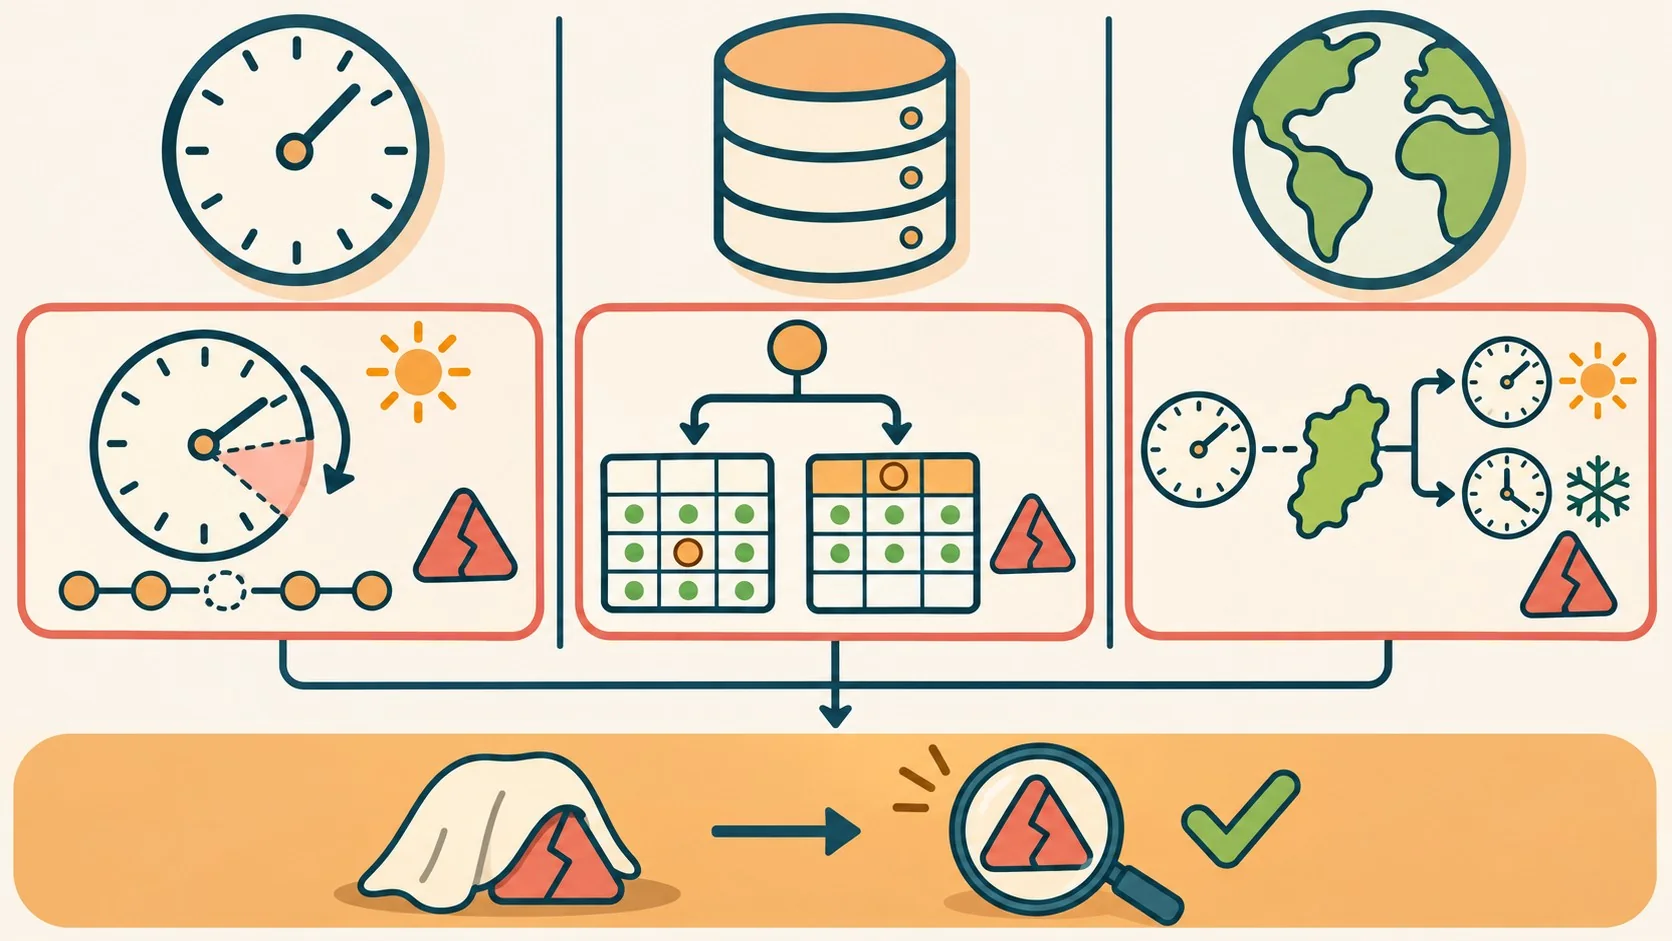
La fila de las comillas dobles es la que más gente agarra desprevenida. Una query escrita para MySQL que usa comillas dobles para un string se convierte, después de migrar, en una referencia a un identificador, y según cómo maneje las comillas el driver, eso falla ruidosamente o devuelve algo que parece correcto y no lo es.
Criterios propios para decidir si una migración de dialecto es segura antes de ejecutarla en producción, más allá de lo que marque cualquier conversor automático:
- ¿Hay comillas dobles en algún lado del código? Si la respuesta es sí, hay que auditar cada una manualmente antes de migrar desde o hacia MySQL: no alcanza con correr el conversor y confiar en que todo lo que no marcó error está bien.
- ¿El código depende de LIMIT con coma? Esa sintaxis no existe en PostgreSQL. Si aparece, conviene reescribirla con
LIMIT ... OFFSET ...explícito antes de migrar, no después de que falle. - ¿Hay comparaciones implícitas de texto contra número? Lo que en MySQL o SQLite pasa silenciosamente, en PostgreSQL tira error. Conviene tratarlo como algo bueno: mejor que falle en staging que en producción.
- ¿El upsert está escrito con sintaxis nativa de un solo motor? Si migrás sin reescribir el upsert, probablemente la consulta directamente no corra, lo cual, dentro de todo, es el escenario menos peligroso de esta lista porque al menos avisa.
¿Por qué guardar un offset en vez de una zona horaria es un error?
Porque un offset es la foto de un instante puntual, mientras que una zona horaria es un conjunto de reglas que se aplican distinto según la fecha. 2026-03-29T01:30+01:00 te dice un solo momento exacto. Europe/London te dice cómo interpretar cualquier hora local en esa zona, con reglas que cambian antes y después de cada transición de horario de verano.
Ponele que guardás el timestamp de un usuario con un offset fijo, calculado una vez, en el momento del registro. Seis meses después, cuando ese offset ya no corresponde porque hubo un cambio de horario de por medio, la hora que mostrás está mal por una hora, y nadie va a entender por qué, porque en la base de datos no quedó registro de que el offset era una propiedad de ese instante y no una verdad permanente. Complementá con diseñar una arquitectura AWS de producción real.
La recomendación del análisis es simple de escribir y difícil de aplicar con disciplina: guardar instantes UTC más el nombre de zona IANA (no un offset derivado), y convertir a hora local solo en el momento de mostrar el dato, nunca antes. Formatear fechas adentro de la base es, literalmente, donde las reglas de zona horaria van a morir.
¿Qué pasa si un usuario ingresa una hora que no existe por el horario de verano?
Pasa lo mismo que con cron: un parser ingenuo asume que esa hora existe y produce un instante equivocado sin avisar. Si un usuario en Londres escribe 2026-03-29 01:30, esa hora no existe ese día, y un parser que no valida ese caso va a devolver un instante una hora corrido, con el mail de confirmación diciendo algo que no corresponde.
¿Alguien revisa esto en la mayoría de los formularios de fecha? Casi nunca. El análisis plantea tratar “esta hora no existe” y “esta hora es ambigua” como errores de validación que alguien tiene que decidir, no como casos raros que el parser resuelve por su cuenta. Hay tres políticas posibles: adelantar la hora, elegir la primera ocurrencia si es ambigua, o directamente rechazar el input y pedirle al usuario que aclare.
La forma más simple de decidir cuál de las tres conviene es pensar quién sufre el error si el sistema se equivoca. Si lo que se agenda es un recordatorio de bajo riesgo, adelantar la hora o tomar la primera ocurrencia puede ser aceptable. Si lo que se agenda es un corte de servicio, un vencimiento legal o un cobro, rechazar el input y forzar a la persona a elegir explícitamente evita que el sistema tome una decisión silenciosa sobre algo que importa. Esa política, cualquiera que sea, tiene que quedar escrita en el código donde un revisor la pueda ver, no escondida en el comportamiento por default de una librería.
¿Por qué estas herramientas de conversión corren en el navegador y no en un servidor?
Porque las tres son funciones puras: entra texto, sale texto, y no hay ninguna razón para que un servidor intervenga en el medio. Según explica el análisis, lo que se pega en un conversor rápido suele ser un fragmento real de producción, una lista de clientes o una connection string, así que la regla de diseño fue que el input nunca salga de la página: sin subida de archivos, sin cuenta, sin analytics sobre el contenido pegado.
El trade-off es honesto y lo dice la propia fuente: sin servidor, todo el parseo corre en JavaScript en la máquina del usuario, así que inputs pesados quedan limitados por el navegador, y no hay API para scripting. Para una expresión cron pegada o un archivo SQL de 200 líneas, ese límite no molesta. Lo explicamos a fondo en consultar errores reales de GitHub Actions.
Errores comunes en producción de software: lo que falla en cron, SQL y zonas horarias
- Asumir que cron corre en UTC. Un scheduler configurado con la zona del sistema operativo aplica reglas de horario de verano locales, no aritmética UTC fija. Corregilo resolviendo cada ejecución contra la zona real del servidor o del usuario, no contra un offset calculado a mano.
- Migrar SQL de un motor a otro sin revisar las comillas dobles. Pasar de MySQL a PostgreSQL sin auditar cada string entre comillas dobles convierte literales en referencias a columnas inexistentes. Corregilo revisando cada ocurrencia antes de correr la migración en producción, no después.
- Guardar un offset fijo como fuente de verdad. Un timestamp con offset calculado una sola vez queda mal apenas pasa un cambio de horario. Corregilo guardando UTC más el nombre de zona IANA, y convirtiendo a hora local solo al mostrar el dato.
- Dejar que el parser de fechas adivine qué hacer con una hora inexistente o ambigua. Sin una política explícita, cada librería resuelve el caso distinto y nadie lo decidió a propósito. Corregilo definiendo en el código qué pasa en cada caso: adelantar, elegir la primera ocurrencia, o rechazar el input, según quién sufra el error si el sistema se equivoca.
Preguntas Frecuentes
¿Por qué mi tarea cron no corre el día del cambio de horario?
No corre porque la hora que especificaste cae en el hueco que se produce cuando los relojes avanzan (spring forward), un bloque de 60 minutos que ese día no existe en el calendario local. El scheduler, al no encontrar un instante válido, directamente saltea la ejecución sin avisar.
¿Qué diferencia hay entre guardar un offset y guardar una zona horaria?
Un offset describe un único instante puntual, como +01:00 en una fecha específica, y deja de ser válido en cuanto cambia el horario de verano. Una zona horaria IANA, como Europe/London, es un conjunto de reglas que calcula el offset correcto para cualquier fecha, pasada o futura.
¿Por qué una consulta SQL con comillas dobles funciona distinto en MySQL y PostgreSQL?
Porque MySQL interpreta las comillas dobles como un literal de texto (salvo que esté activado ANSI_QUOTES), mientras que PostgreSQL y SQLite las interpretan como un identificador de columna o tabla. La misma query corre en los dos motores, pero significa cosas distintas.
¿Cómo sé cuántas veces por día se ejecuta una expresión cron?
Depende del campo de minutos y de la combinación con los demás campos: */15 equivale a 96 ejecuciones por día, y 0 0 1 * * equivale a 12 ejecuciones al año. Lo más seguro es resolver la expresión contra una zona horaria real y contar las próximas ejecuciones antes de asumir la frecuencia de memoria.
¿Qué pasa si un usuario ingresa una hora que no existe por el horario de verano?
Un parser que no valida ese caso produce un instante equivocado, generalmente corrido una hora, sin ningún mensaje de error visible. La práctica recomendada es tratar esa hora inexistente como un error de validación y aplicar una política explícita (adelantar, elegir la primera ocurrencia o rechazar el input) definida en el código, según qué tan grave sea el error para quien use el sistema.
Conclusión
Los tres problemas que describe el análisis de Dev.to tienen algo en común: ninguno tira un error de sintaxis, así que ninguno aparece en una revisión de código apurada. Cron, SQL y zonas horarias siguen reglas de calendario local, no aritmética simple, y esa diferencia es exactamente donde se esconden los errores comunes en producción de software que más tiempo tardan en detectarse.
Si tu equipo tiene jobs programados, hace migraciones entre motores de base de datos o maneja timestamps de usuarios de distintos países, lo accionable es concreto: resolvé cada expresión cron contra una zona horaria real antes de confiar en ella, auditá las construcciones “válidas en ambos dialectos” antes de migrar SQL usando los criterios de arriba, y dejá de guardar offsets fijos como si fueran la verdad. Ninguna de las tres cosas requiere herramientas nuevas, solo revisar lo que ya da por sentado el que escribió el código original.