Cómo armar un revisor de Terraform con IA en CI
En pocas palabras: Se construye integrando un LLM liviano al pipeline de CI que lee el JSON de terraform show -json, lo compara contra reglas en policy/review-policy.yaml y publica hallazgos por severidad (HIGH, MEDIUM, LOW) como comentario en el pull request, sin credenciales cloud ni permiso para ejecutar terraform apply, según el blueprint publicado en dev.to el 7 de noviembre de 2026.
Un revisor de Terraform con IA corre dentro del pipeline de CI, lee cada terraform plan exportado en JSON, lo compara contra un archivo de política versionado en el repo y publica los hallazgos como comentario en el pull request, según describe el blueprint publicado en dev.to el 7 de noviembre de 2026. El agente nunca ejecuta terraform apply: el merge queda siempre en manos de un humano.
Un revisor de Terraform con IA es un modelo de lenguaje liviano integrado al pipeline de CI/CD que analiza el JSON generado por terraform show -json contra reglas de política escritas en lenguaje simple, clasifica cada hallazgo por severidad (HIGH, MEDIUM, LOW) y publica el resultado como comentario de pull request, sin credenciales de nube ni capacidad de aplicar cambios reales sobre la infraestructura.
En este artículo:
- En 30 segundos
- ¿Por qué las revisiones manuales de Terraform fallan cuando el equipo crece?
- ¿Cómo es la arquitectura de un revisor de Terraform con IA basado en LLM?
- ¿Cómo se integra este revisor en un pipeline de GitHub Actions?
- ¿Qué reglas debe incluir el archivo de política y cómo se clasifican por severidad?
- ¿En qué se diferencia un LLM de un linter determinístico como OPA o Conftest?
- ¿Cuándo conviene implementar este revisor y cuándo no?
- ¿Qué guardrails de seguridad son obligatorios antes de llevar esto a producción?
- ¿Reemplaza este sistema la revisión humana final?
- Errores comunes al implementar un revisor de Terraform con IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El revisor solo recibe el JSON del plan (
terraform show -json), nunca credenciales cloud ni acceso a shell. - La política vive en
policy/review-policy.yaml, versionada junto al código HCL que audita. - Los hallazgos se clasifican en HIGH (bloquea el PR), MEDIUM (advierte sin frenar el build) y LOW (silencioso salvo auditoría pedida).
- El workflow de GitHub Actions dispara en cada
pull_requestque toque archivos.tfo.tfvars. - El merge sigue siendo decisión exclusiva de un humano: el agente nunca corre
terraform apply.
¿Por qué las revisiones manuales de Terraform fallan cuando el equipo crece?
Las revisiones manuales de Terraform fallan porque dependen de quién esté libre en ese momento, no de quién tenga más criterio técnico para evaluar el cambio. Pinnear versiones de módulos y aislar los archivos de remote state ayuda a contener el radio de impacto si algo sale mal, pero no resuelve el cuello de botella real.
Ponele la escena típica: alguien abre un pull request con una docena de recursos cloud afectados, es viernes, son las cinco de la tarde, y la persona que tiene que revisar el plan ya está pensando en el fin de semana. Esa inspección fina de “che, ¿esto realmente tiene que borrar esa subnet?” no se sostiene bajo presión.
El tema es que cuando el equipo de ingeniería se duplica, la cantidad de pull requests con cambios de infraestructura también se duplica. El ojo humano no escala así de simple: la cantidad de atención disponible por revisor es fija, y la cantidad de diffs a revisar crece con cada persona que se suma al equipo.
Fijate que la propia fuente lo describe sin vueltas: la revisión termina siendo quien esté de guardia mirando logs de terminal, buscando checkmarks verdes en vez de leer el diff completo (spoiler: nadie lee con la misma atención a las 5:15 PM que a las 10 de la mañana). Esto se conecta con nuestro análisis de qué cambió en los precios de Google Cloud.
¿Cómo es la arquitectura de un revisor de Terraform con IA basado en LLM?
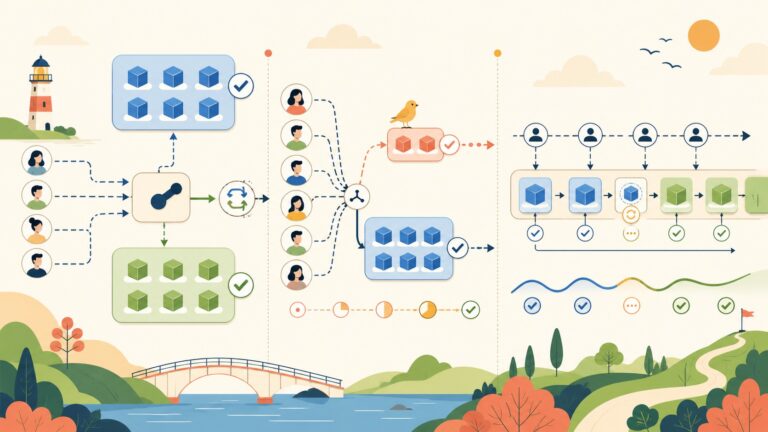
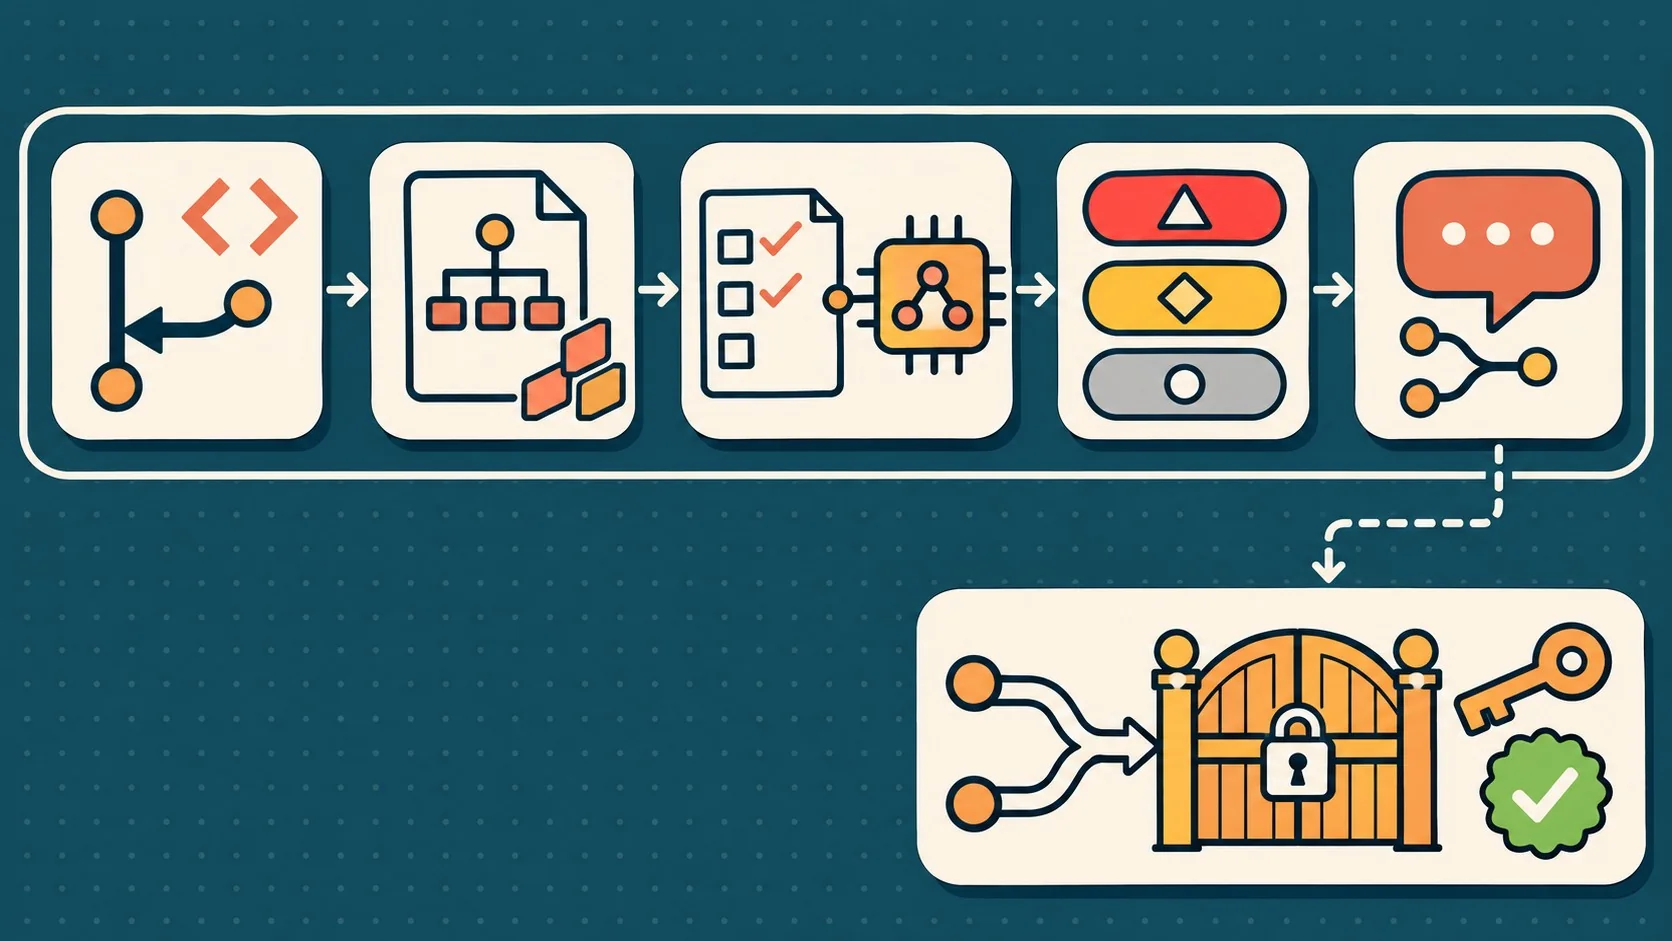
La arquitectura tiene cinco pasos: se abre un pull request, el pipeline corre terraform plan y lo exporta a JSON, un prompt builder combina ese diff con la política del equipo, el modelo clasifica los hallazgos por severidad y el resultado se publica como comentario en el PR. En ningún paso el agente toca infraestructura real.
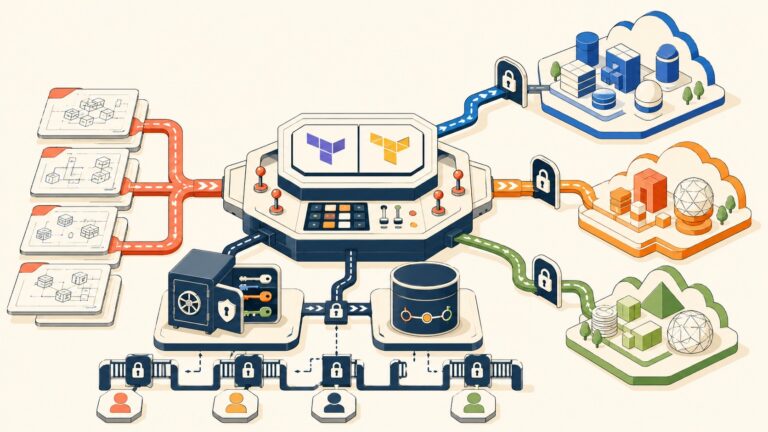
Dos límites arquitectónicos hacen casi todo el trabajo pesado acá. El primero: el único input del revisor es el diff del plan en JSON, sin credenciales de AWS ni de GCP, sin roles IAM, sin acceso a shell para meterse en las VPCs. Parsea texto, nunca toca metal en vivo.
El segundo límite es que la frontera de confianza queda adentro del runner de CI. La clave de API del modelo vive en los secrets de GitHub Actions o de GitLab CI, en ningún otro lado. Y el único camino de escritura que puede disparar un deploy a producción sigue siendo exclusivamente el botón de merge que aprieta un humano.
El prompt que propone la guía es deliberadamente simple: “You are a Terraform plan reviewer. Review the plan JSON against each rule in the policy. For every violation, return: rule id, severity, resource address, what changed, and a one-paragraph recommendation. Do not approve, merge, or apply anything.” Nada de ingeniería de prompts elaborada; el cerebro real del sistema vive en el archivo de política, no en trucos de redacción.
¿Cómo se integra este revisor en un pipeline de GitHub Actions?
Se integra con un workflow que dispara en cada pull_request que modifique archivos .tf o .tfvars, corre terraform plan, lo convierte a JSON con terraform show -json y pasa ese archivo a un script de revisión que usa la API key del modelo guardada como secret. Más contexto en cómo probar estos flujos con la demo de Kubernetes.
El paso terraform init -backend=false evita tirar del backend remoto si solo necesitás validar sintaxis de módulos. Como alternativa, el pipeline corre contra el state con un rol de solo lectura. Después, terraform show -json tfplan > plan.json convierte la salida en datos estructurados limpios, en vez de pasarle al modelo logs de terminal con colores y ruido.
Un ejemplo concreto del JSON que recibe el modelo: un cambio en google_storage_bucket.logs donde uniform_bucket_level_access pasa de true a false. Eso, sin más contexto, es exactamente el tipo de dato que dispara una alerta HIGH más adelante.
Si corrés tus propios runners self-hosted en vez de depender de los de GitHub, vas a necesitar una VPS estable para alojarlos: ahí donweb.com es una opción válida para equipos en Argentina que quieren mantener esa infraestructura cerca y con soporte local.
¿Qué reglas debe incluir el archivo de política y cómo se clasifican por severidad?
El archivo de política debe incluir reglas escritas en lenguaje plano que el equipo entero discuta y acuerde, versionadas en policy/review-policy.yaml junto al código HCL que audita. No hace falta copiar cincuenta benchmarks de seguridad de internet.
- bucket-no-public (HIGH): ningún bucket de almacenamiento puede permitir acceso público.
- modules-pinned (MEDIUM): todo módulo externo debe pinnear una versión exacta, nunca apuntar a
latesto a una rama genérica. - stateful-lifecycle-guard (HIGH): bases de datos y recursos con estado necesitan el bloque
prevent_destroy. - tag-hygiene (LOW): todo recurso lleva tags de owner y environment.
La severidad HIGH bloquea el merge del PR. MEDIUM publica una advertencia visible sin frenar el build. LOW queda completamente en silencio salvo que alguien pida explícitamente un comentario de auditoría. Esa gradación es la que evita la fatiga de alertas: un bot que tira veinte nitpicks de estilo en cada PR es el tipo de herramienta que el equipo silencia en una semana.
Ejemplo hipotético (a modo ilustrativo, no es un caso real reportado por las fuentes): imaginá un equipo de infraestructura chico, de unas seis personas, que recibe en promedio tres o cuatro pull requests con cambios de Terraform por semana. Uno de esos PRs agrega una base de datos Postgres para un servicio nuevo y, en el mismo diff, sin que nadie lo note, queda sin el bloque prevent_destroy. Con revisión manual, ese detalle depende de que la persona de turno esté atenta ese día puntual. Con el esquema descrito acá, la regla stateful-lifecycle-guard dispararía un hallazgo HIGH apenas se abre el PR, con el resource address exacto y la recomendación de agregar el guard antes de mergear. El punto no es que la IA “sepa más” que el equipo, sino que aplica la misma regla acordada las veces que haga falta, sin depender del horario en que se abrió el PR.
¿En qué se diferencia un LLM de un linter determinístico como OPA o Conftest?
Un LLM puede detectar cuando el diff contradice la intención declarada en el PR, algo que un linter determinístico no hace porque solo valida sintaxis contra reglas booleanas fijas. Open Policy Agent o Conftest siguen siendo imbatibles para los “no, nunca” sin ambigüedad. Te puede servir nuestra cobertura de integrar la API de Gemini en tus pipelines.
¿Y si el título del PR dice “Internal metric scraper update” pero el diff abre silenciosamente un puerto de base de datos a toda la VPC? Exacto, ahí un linter determinístico no dice nada porque la sintaxis es válida. El modelo sí lo marca, porque compara el diff contra el texto humano que describe el cambio.
| Criterio | Revisión humana | Revisor con LLM | Linter determinístico (OPA/Conftest) |
|---|---|---|---|
| Velocidad | Cuando alguien tiene un hueco libre | En cada PR, sin excepción | En cada PR, instantáneo |
| Consistencia | Depende del cansancio | Mismo checklist siempre | 100% determinístico |
| Detecta contradicción intención vs. diff | Sí, si está atento | Sí, lo flaguea solo | No, no entiende intención |
| Reglas booleanas estrictas (no ambiguas) | Variable | Puede fallar por nuance | Ideal para esto |
| Puede aplicar infraestructura | Sí (humano decide) | Nunca | Nunca |
Lo más sano, según plantea la fuente, es usar ambos en cascada: las reglas rápidas y baratas de OPA corren primero, y el modelo gasta su atención solo en las zonas grises donde hace falta juicio de ingeniería real.
¿Cuándo conviene implementar este revisor y cuándo no?
No todo equipo necesita este esquema desde el día uno. Combinando lo que aportan las dos fuentes, hay tres señales que, juntas, indican que vale la pena invertir tiempo en armarlo:
- El equipo creció más rápido que la disciplina de revisión. Si hace un año una sola persona revisaba todos los planes de Terraform y hoy esa misma persona sigue siendo cuello de botella mientras el equipo se duplicó o triplicó, ahí el problema de escala descrito en la primera fuente ya está pasando factura.
- Ya existe una política de infraestructura, aunque sea informal. Si el equipo nunca se puso de acuerdo en reglas mínimas (buckets públicos, pinning de módulos,
prevent_destroyen bases), conviene escribir esa política primero, aunque sea en una charla de 30 minutos, antes de automatizar la lectura de esas reglas. Un revisor con IA sin política clara detrás no tiene de dónde “colgarse”. - Hay suficiente volumen de PRs de infraestructura como para que la fatiga de alertas sea un riesgo real. Con uno o dos PRs de Terraform por mes, probablemente alcance con una checklist humana. El caso de uso descrito acá rinde más cuando el volumen semanal hace que la atención humana empiece a degradarse, como en el ejemplo hipotético de la sección anterior.
Si ninguna de esas tres condiciones aplica todavía, probablemente convenga primero ordenar la política en texto plano y recién después pensar en automatizar la lectura con un modelo.
¿Qué guardrails de seguridad son obligatorios antes de llevar esto a producción?
Antes de dejar que un LLM lea diffs de infraestructura en CI de producción hacen falta reglas que la propia fuente trata como no negociables. Conviene chequearlas una por una antes de activar el workflow en un repo real:
- Solo lectura por construcción: el revisor parsea JSON, nunca tiene credenciales que puedan correr
terraform apply. - Sin auto-merge ni auto-apply: el modelo sugiere, el humano decide, siempre.
- Redacción de secretos antes de transmitir: las variables marcadas como sensibles se eliminan para que ninguna contraseña salga del runner de CI.
- Gating estricto por severidad: HIGH puede frenar el check del PR, MEDIUM advierte, LOW queda mudo.
Según el repositorio terraform-review-ai-action, publicado por el usuario de GitHub thomast1906, una implementación concreta de este patrón envía evidencia acotada del plan a Microsoft Foundry y devuelve hallazgos de seguridad, costo, confiabilidad y riesgo de entrega, enmascarando valores sensibles y desconocidos antes de salir del pipeline. Esa misma lógica de “mandá solo lo que necesitás, enmascará el resto” es la que sostiene todo el esquema de guardrails.
¿Reemplaza este sistema la revisión humana final?
No reemplaza la revisión humana final porque el modelo no tiene contexto de negocio: no sabe que un “borrado riesgoso” de una base de datos es en realidad seguro porque ese microservicio se da de baja el trimestre que viene.
Es un primer revisor excelente y un último revisor terrible. Nunca se cansa, nunca salta párrafos, nunca aprueba algo solo porque quiere cerrar la laptop un viernes. Eso sí: cuando el prompt le pide admitir falta de contexto en vez de inventar una respuesta, lo hace, tal como señala el blueprint publicado en dev.to. Por eso el humano se queda en el asiento del conductor, con los derechos de merge intactos. Cubrimos ese tema en detalle en nuestra guía para crear una VM en Azure.
Errores comunes al implementar un revisor de Terraform con IA
- Copiar cincuenta reglas de un benchmark genérico: arrancá con una docena de reglas que el equipo acuerde de verdad. Un bot con cincuenta nitpicks es un bot que se silencia en una semana.
- Darle credenciales cloud al revisor “por las dudas”: el único input tiene que ser el JSON del plan. Si el bot puede correr
apply, dejó de ser un revisor y pasó a ser un riesgo. - Tratar las alertas MEDIUM como bloqueantes: eso infla la fricción y mata la adopción. MEDIUM advierte, no frena el build; solo HIGH bloquea.
- Reemplazar OPA o Conftest en vez de complementarlos: las reglas booleanas duras (como “ningún bucket público, punto”) siguen siendo terreno de un linter determinístico, no del modelo.
Preguntas Frecuentes
¿Cómo funciona un revisor de Terraform basado en IA dentro de CI/CD?
Funciona leyendo el JSON exportado con terraform show -json contra un archivo de política del equipo, clasificando cada hallazgo por severidad y publicando el resultado como comentario en el pull request. El pipeline dispara en cada PR que toque archivos .tf o .tfvars, y el agente nunca ejecuta cambios reales.
¿Qué reglas debe tener la política de revisión de infraestructura?
Debe tener reglas escritas en lenguaje plano, versionadas junto al código, como no permitir buckets públicos, exigir pines exactos de versión en módulos, forzar prevent_destroy en bases de datos y pedir tags de owner y environment. Lo ideal es arrancar con una docena de reglas acordadas por el equipo, no con decenas copiadas de un benchmark externo.
¿Un LLM puede reemplazar al linter o a OPA en revisión de Terraform?
No, un LLM no reemplaza a OPA ni a Conftest para reglas booleanas estrictas sin ambigüedad, como bloquear cualquier bucket público. El modelo complementa esas herramientas detectando contradicciones entre la intención declarada en el PR y lo que realmente cambia el diff, algo que un linter determinístico no puede evaluar.
¿Qué permisos necesita un bot de IA que revisa pull requests de Terraform?
Necesita únicamente acceso de lectura al JSON del plan y permiso para comentar en el pull request, nada más. No requiere credenciales de AWS, GCP ni Azure, ni roles IAM, ni acceso a shell sobre la infraestructura real, porque su único trabajo es parsear texto estructurado.
¿Cómo evitar que la IA apruebe cambios peligrosos en la infraestructura?
Se evita diseñando el sistema para que nunca tenga capacidad de aprobar ni aplicar nada: solo sugiere, y el merge queda exclusivamente en manos humanas. Sumale gating estricto por severidad, donde los hallazgos HIGH bloquean el check del PR en vez de depender de que alguien los lea a tiempo.
Conclusión
Lo que cambia con un revisor de Terraform con IA no es la seguridad de la infraestructura en sí, sino quién lee cada plan con la misma atención el lunes a la mañana y el viernes a las cinco de la tarde. El modelo no aprueba nada, no tiene llaves de la nube y no reemplaza el criterio de negocio de un ingeniero senior.
Si tu equipo ya pasó por el clásico “subís el PR, lo probás en local, funciona bárbaro, alguien lo aprueba sin mirarlo bien porque son las seis de la tarde de un viernes, y el lunes aparece un bucket abierto al público en producción”, este patrón vale la pena probarlo en un repo chico antes de escalarlo. Usá los tres criterios de arriba para decidir si ya te toca: equipo que creció más rápido que la revisión, política mínima ya acordada y volumen de PRs suficiente para que la fatiga humana sea un riesgo real. Arrancá con una docena de reglas, dejá que OPA se ocupe de lo booleano, y usá el modelo solo para las zonas grises donde hace falta leer intención. El botón de merge, eso sí, no se lo prestes a nadie que no sea una persona.