Plan de rollback para un cutover entre nubes: qué revertir
La sección de rollback de la mayoría de los planes de cutover ocupa una línea: «revertir si algo sale mal». Un artículo publicado este 14 de noviembre de 2026 por el usuario OneLifeVibe en DEV Community sostiene que esa línea esconde la parte más difícil de una migración entre nubes. Cuando el corte arranca, los registros DNS ya cambiaron, las rutas se retiraron en un lado y se anunciaron en otro, hay conexiones abiertas por caminos que no existían una hora antes y algunas escrituras ya se aceptaron en el destino. Volver atrás no es la ida al revés: es un diseño de red propio que hay que escribir, cronometrar y probar antes de abrir la ventana.
Conviene fijar el alcance de la evidencia. Se trata de una pieza de opinión técnica de un proveedor —cierra promocionando CloudVerg y sus productos de conectividad multi-nube—, no de un estándar ni de documentación oficial, y no cita métricas propias. Lo que sí se puede contrastar aparece en la documentación de referencia: la guía de rollback para AKS de Microsoft Learn describe la vuelta como una secuencia por capas, no como un interruptor único.
En este artículo:
¿Qué es un plan de rollback en una migración cloud?
Es un procedimiento documentado y ensayado que permite devolver tráfico y datos al entorno original si el cutover falla. La distinción central es temporal: mientras la base vieja siga siendo la fuente de verdad, alcanza con reactivar escrituras y devolver el DNS; desde la primera escritura aceptada solo en la nube nueva, el rollback deja de ser una reversión y pasa a ser una segunda migración, con reconciliación de datos propia. Cubrimos ese tema en detalle en GitHub Actions se cae y frena deploys.
Microsoft Learn ordena ese regreso por capas —tráfico, aplicación, datos, infraestructura— para limitar el radio de daño: un rollback de release con Helm, la restauración de un snapshot de disco o el cordon y drain de un node pool nuevo resuelven incidentes que no justifican una reversión completa. En el plano de la red, el post de moveinfra.eu del 5 de noviembre de 2026 agrega la pieza que suele faltar: replicación lógica inversa desde la base nueva hacia la vieja, con pausa de escrituras, y sincronización de los objetos creados después del corte, para que un regreso días más tarde no borre la actividad de los clientes.
¿Cuándo se cruza el punto de no retorno?
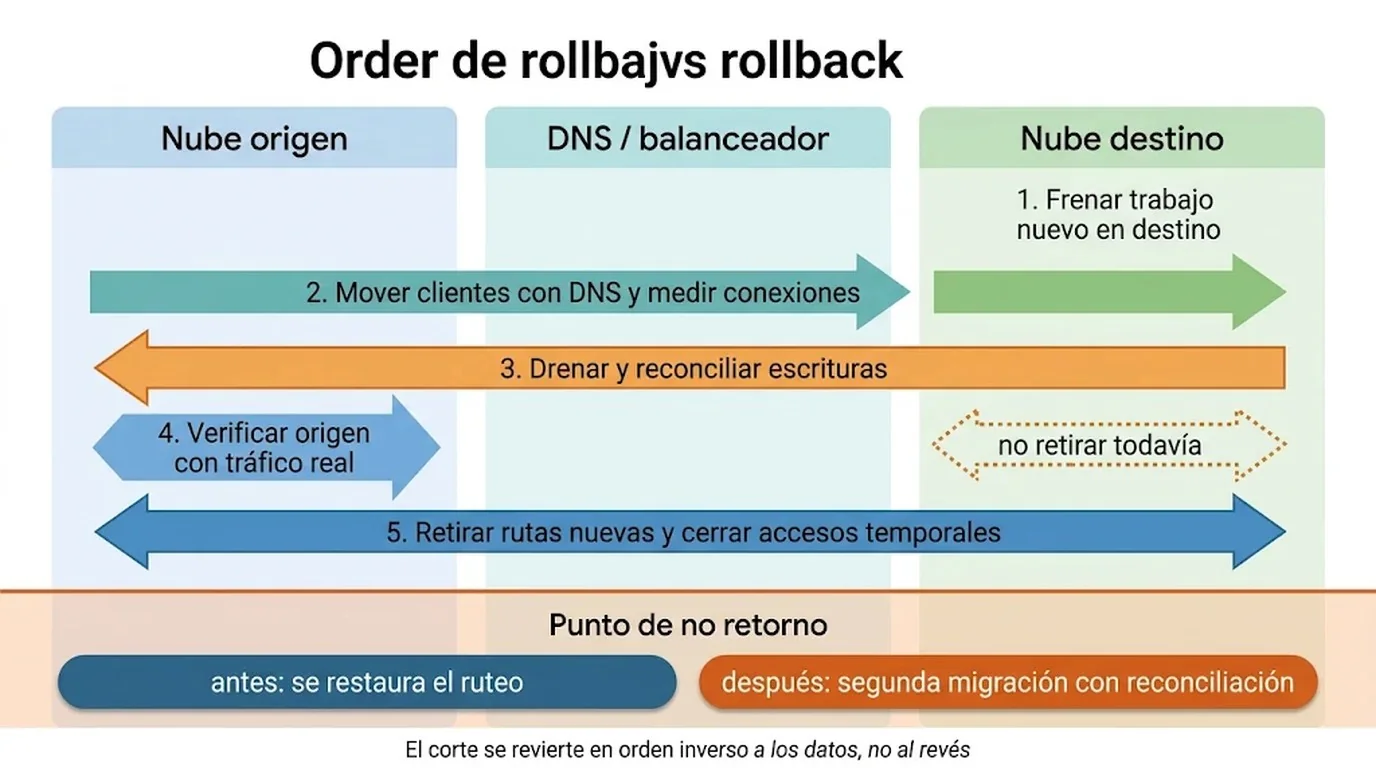
Se cruza en un evento observable, no en una sensación: la primera escritura aceptada solo en el lado nuevo, el drenaje y borrado de una cola vieja o el cambio de formato de una base compartida. Antes de ese momento el rollback consiste en restaurar el routing y el DNS previos; después, exige reconciliar datos. El runbook debería tener dos secciones separadas, con dueños y estimaciones de tiempo distintas, y una regla explícita sobre quién declara en cuál de las dos situaciones está el equipo.
| Escenario | Quién manda | Qué hace falta para volver | Cómo se cierra |
|---|---|---|---|
| Dentro de la ventana, antes de la primera escritura solo en el destino | La base vieja sigue siendo la fuente de verdad | Reactivar escrituras en el lado viejo y devolver DNS o balanceador | Conteo de conexiones en la ruta nueva cerca de cero |
| Después de la primera escritura en el destino | La nube nueva es el sistema de registro | Replicación inversa, sincronización de objetos, pausa de escrituras y promoción del primario viejo | Lag en cero, datos reconciliados y lado viejo sirviendo bajo carga real |
El test que propone el artículo funciona como filtro previo: si quien decide no puede decir en una frase qué cambió de forma irreversible, el cutover no está listo para arrancar. Esto se conecta con lo que analizamos en los precios de Google Cloud en 2026.
¿Cómo se arma un plan de rollback de red paso a paso?
Antes de abrir la ventana hay que bajar el TTL de todos los registros involucrados, anotar cada apertura temporaria en un ledger con dueño único, fijar disparadores numéricos con una hora límite de decisión y ensayar la vuelta a mitad de camino. Durante la reversión, el camino nuevo se mantiene arriba hasta que las sesiones terminan de volver al lado viejo.
Bajar el TTL del DNS antes, y restaurarlo a propósito después
El DNS es el volante del cutover y también la parte más lenta de revertir. Con un TTL de una hora, una decisión tomada en el minuto diez puede tardar casi otra hora en llegar a todos los resolvers, y algunos clientes seguirán entrando al lado nuevo cuando el equipo ya cree que el tráfico volvió. La recomendación es bajar el TTL de todos los registros involucrados al menos un período completo de TTL viejo antes de la ventana y verificar que el valor corto se esté sirviendo de verdad desde resolvers públicos, no solo que figure en el archivo de zona. El post de moveinfra.eu es más específico: 60 segundos —o 300 si el proveedor impone un mínimo— con dos o tres días de anticipación.
Dos detalles se pasan por alto. El primero: guardar los valores originales en el runbook para restaurar registro y TTL una vez estabilizado el servicio. El segundo: una porción de resolvers y de clientes con IP fijada ignora el TTL, así que el rollback no termina cuando el cambio de registro devuelve OK, sino cuando los conteos de conexión del camino nuevo caen cerca de cero. Dejar producción con TTL de cinco minutos durante semanas también tiene costo: más consultas y más dependencia de la disponibilidad del DNS. Ya lo cubrimos antes en automatizar la revisión de Terraform en CI.
La deuda de rollback: un ledger y un dueño
Cada cutover acumula estado temporario: una regla de firewall abierta para la herramienta de migración, una ruta agregada para una subnet, un security group ampliado por una noche, una excepción en la política de egreso. En un éxito se limpian con calma; en un rollback nadie sabe cuáles sigue necesitando la configuración vieja, se deja todo y el entorno termina menos seguro que al empezar. La propuesta es un ledger único desde el primer cambio, con el ítem, por qué existe, qué depende de él y el paso exacto que lo elimina tanto en el camino de éxito como en el de vuelta, asignado a una persona cuyo único trabajo durante la ventana es esa lista.
Disparadores numéricos y hora límite de decisión
En medio de un cutover que falla, toda señal parece ambigua: los errores subieron pero quizá se estabilicen, la latencia empeoró pero quizá sea caché frío. Sin disparadores acordados en frío, la decisión se convierte en un debate en el peor momento. Los posts citados dan ejemplos, no umbrales universales: lag de replicación que no baja de 5 segundos durante 10 minutos, tasa de error 5xx por encima del 2% durante 15 minutos seguidos, o la falla de una transacción crítica probada desde una ubicación nombrada. Conviene sumar una hora límite: si no se alcanzó determinado hito, el rollback arranca solo porque la ventana restante ya no alcanza para terminar y volver. Escribirlos también protege a quien declara la vuelta: cumplir un disparador acordado es seguir el plan, no rendirse.
Ensayar la vuelta, no solo la llegada
Los game days de migración suelen practicar el camino de ida. Agregar un ejercicio donde el equipo se detiene a mitad y vuelve saca a la luz piezas faltantes en minutos: el certificado del lado viejo que venció durante el proyecto, la ruta que ya se había retirado en la preparación, el dashboard que solo muestra la ruta nueva, el acceso que se movió y no se duplicó. En un ensayo cada una es un arreglo chico; a las dos de la mañana, una demora larga. En un plan de recuperación ante desastres profundizamos en esto.
¿Cómo revertir un cutover entre nubes sin dejar tráfico sin ruta?
Invirtiendo la lógica del cutover, no su secuencia literal. Primero se frena el trabajo nuevo en la nube destino sin apagar sus caminos, después se devuelve a los clientes con DNS o balanceador, se drenan y reconcilian las escrituras hechas del lado nuevo, se confirma que el lado viejo sirve bajo tráfico real y recién al final se retiran las rutas nuevas y se cierran las aperturas de firewall.
El cutover forward suele mover datos, desplazar lecturas, desplazar escrituras y retirar las rutas viejas. El reflejo en la vuelta es retirar primero las rutas nuevas porque «parece deshacer el cambio», y es justo lo que deja clientes colgados: los que todavía están siendo dirigidos al lado nuevo llegan a un camino sin retorno, y los firewalls stateful descartan las respuestas aunque exista un camino de ida. El orden seguro es otro.
- Frenar el trabajo nuevo en el lado nuevo, manteniendo sus caminos arriba.
- Llevar clientes de vuelta con DNS o cambios en el balanceador, y mirar cómo se mueven los conteos de conexión.
- Drenar y reconciliar las escrituras hechas del lado nuevo desde que empezó el corte.
- Confirmar que el lado viejo sirve normalmente bajo tráfico real, no solo con health checks.
- Retirar las rutas nuevas y cerrar las aperturas temporales de firewall al final.
Mantener vivo el camino que se abandona es contraintuitivo y necesario: todavía lleva las sesiones que hay que traer de vuelta. En migraciones con estado, cualquier cambio de primario exige pausa de escrituras y lag en cero antes de invertir la replicación; hacerlo con los dos lados aceptando escrituras produce un split-brain que después lleva días desenredar.
Para entidades financieras y sus proveedores críticos de TIC en la Unión Europea, este trabajo dejó de ser opcional: el reglamento DORA exige estrategias de salida y planes de continuidad probados al cambiar de proveedor, según recuerda el artículo de moveinfra.eu. Es el argumento más fuerte para tratar el rollback como un entregable con pruebas y no como una cláusula de estilo en el documento de migración.
Un criterio de verificación que se puede aplicar sin tocar producción: tomar el runbook y pedirle a quien tiene autoridad de decisión que nombre en una frase el último cambio irreversible que ya ocurrió, y que muestre en el ledger qué aperturas temporales están abiertas en ese momento. Si alguna de las dos respuestas es vaga, el plan de red todavía no está a la altura del corte. Es una propuesta editorial, no un método validado: sirve para detectar ambigüedad antes de la ventana, no para medir la calidad de una migración en curso.
Fuentes
- Rollback Needs a Network Plan Too: Reversing a Cross-Cloud Cutover Without Stranding Traffic — DEV Community, 14 de noviembre de 2026.
- Rollback strategies for Kubernetes migration on Azure Kubernetes Service (AKS) — Microsoft Learn.
- Why every cloud migration needs a rollback plan, and how to build one — DEV Community, 5 de noviembre de 2026.
- Cloud migration cutover plan – rollback — Progressive Robot, 10 de agosto de 2026.