cgroup v2: así se frena un backup que ahoga tu base
En pocas palabras: Se frena con el controlador io de cgroup v2: creás un slice de systemd para el backup y le aplicás un techo duro con io.max (vía IOWriteBandwidthMax e IOWriteIOPSMax), verificable en /sys/fs/cgroup/backup.slice/io.max, en vez de confiar en ionice, que no funciona con mq-deadline ni none.
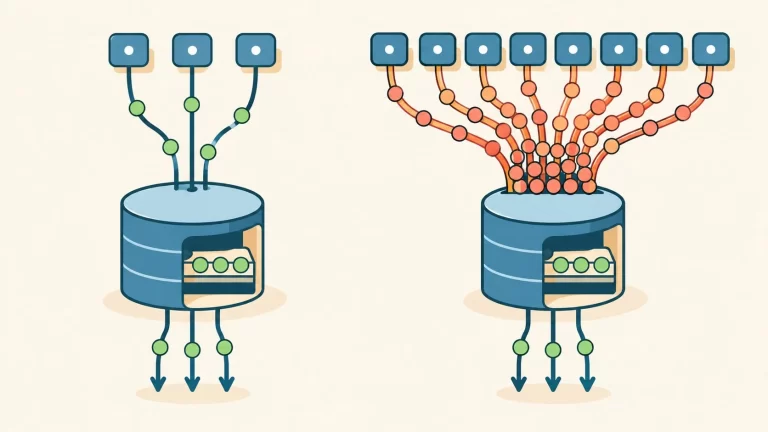
Son las 01:05 AM, el backup arrancó hace cinco minutos y la latencia p99 de tu base de datos pasó de 4 ms a 90 ms. El job no está roto ni lento: está escribiendo 400 MB/s al mismo disco NVMe donde vive la base, y ahora todas las queries hacen cola en el bloque de I/O.
El control de I/O en cgroup v2 es el mecanismo del kernel Linux que permite limitar, repartir o proteger el ancho de banda y los IOPS de disco por grupo de procesos, a través de archivos como io.max, io.weight e io.latency. Según la documentación oficial del kernel, estos controladores actúan sobre la jerarquía de cgroups, no sobre procesos sueltos, y systemd expone esa jerarquía con unidades como slices y services.
En este artículo:
- En 30 segundos
- ¿Por qué ionice no limita el I/O en discos modernos?
- ¿Qué mecanismos de control de I/O ofrece cgroup v2?
- ¿Cómo confirmo que el controlador io está disponible antes de configurar nada?
- ¿Cómo creo un slice de systemd para aislar el backup?
- ¿Cómo limito el ancho de banda de disco de un proceso con cgroup v2?
- ¿Cómo verifico que el límite se está aplicando de verdad?
- io.max vs io.weight vs io.latency: ¿cuál usar para proteger la base de datos?
- Errores comunes al configurar límites de I/O con cgroup v2
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
ioniceno funciona en discos NVMe con schedulernoneomq-deadline, que son el default en la mayoría de los sistemas actuales.- CFQ, el scheduler que hacía funcionar
ionice, se eliminó en Linux 5.0. io.maxpone un techo duro en bytes/s o IOPS/s por dispositivo físico, usandoblk-throttle.- Los sufijos de systemd son base 1000:
100Mson 100.000.000 bytes, no 104.857.600 (MiB). - El writeback con cgroup solo se atribuye en ext4, btrfs, f2fs, xfs y ext2; en otros filesystems el límite no agarra los datos que la page cache vuelca después.
¿Por qué ionice no limita el I/O en discos modernos?
ionice no limita nada en la mayoría de los sistemas actuales porque depende de que el scheduler de bloque lea la prioridad que fija ioprio_set(2), y los schedulers default en NVMe (mq-deadline, none) simplemente no lo hacen.
CFQ, el scheduler que hizo famoso a ionice, se eliminó en Linux 5.0. ¿Y entonces quién respeta esa prioridad hoy? Solo BFQ, y de forma proporcional, no como techo: un backup a prioridad idle sigue comiéndose cada IOPS libre que la base de datos no esté usando en ese instante. En un NVMe rápido, “IOPS libre” alcanza y sobra para destruir la latencia de cola.
Para chequear qué scheduler tenés corriendo:
- lsblk -o NAME,MAJ:MIN,SIZE,ROTA,SCHED: te muestra el scheduler activo por dispositivo.
- cat /sys/block/nvme0n1/queue/scheduler: lo mismo, pero apuntado a un disco puntual.
¿Qué mecanismos de control de I/O ofrece cgroup v2?
El controlador io de cgroup v2 no es un solo mecanismo: son tres archivos, cada uno con una garantía y un costo distinto, según detalla la nota técnica publicada en dev.to.
| Archivo | Mecanismo | Garantía | Costo |
|---|---|---|---|
| io.max | blk-throttle | Techo duro de bytes/s o IOPS/s por dispositivo | No conserva trabajo: la capacidad libre se desperdicia |
| io.weight | iocost o BFQ | Reparto proporcional del tiempo de I/O entre hermanos | Solo activo si iocost está habilitado o BFQ es el scheduler |
| io.latency | blk-iolatency | Protege el objetivo de latencia de un grupo throttleando a sus pares | Solo compara hermanos; observa y después reacciona |
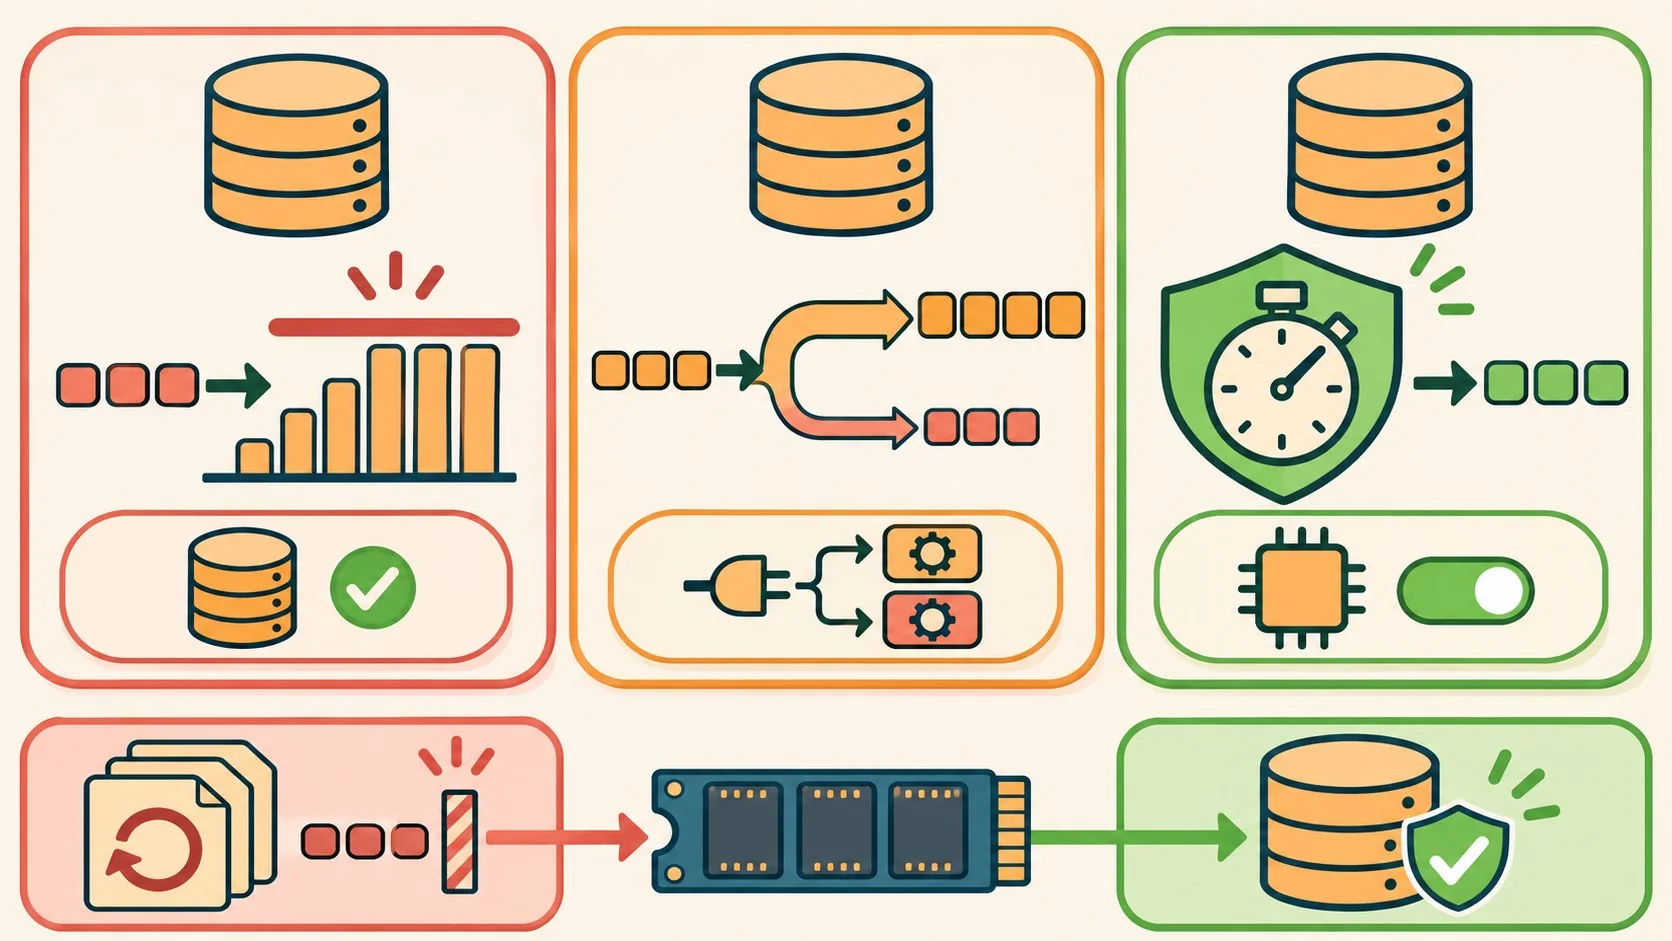
Dos detalles de diseño explican la mayoría de las sorpresas. Primero, io.max se aplica sobre los requests de la capa de bloque, no sobre las llamadas write(2): las escrituras bufferizadas van primero a la page cache y se convierten en I/O de disco recién durante el writeback, así que un proceso puede ensuciar cientos de megabytes antes de que el throttle los vea. Segundo, la documentación del kernel permite rachas explícitamente: BPS e IOPS se miden por dirección y las IOs se demoran si se llega al límite, pero se toleran picos temporales. io.max es un techo sobre el tráfico sostenido al dispositivo, no un limitador por syscall.
¿Cómo confirmo que el controlador io está disponible antes de configurar nada?
Confirmás que el controlador io está disponible con tres comandos: verificás que estás en la jerarquía unificada, que io aparece entre los controladores habilitados, y que apuntás al dispositivo físico (no a una partición o loop device). Te puede servir nuestra cobertura de controlar recursos en runners autohospedados.
- stat -fc %T /sys/fs/cgroup: tiene que devolver
cgroup2fs. - cat /sys/fs/cgroup/cgroup.controllers: tiene que incluir
iojunto acpuset cpu memory pids. - lsblk -o NAME,MAJ:MIN,SIZE,ROTA: los archivos de io se identifican por MAJ:MIN, así que necesitás ese número.
Si io no aparece en cgroup.controllers, el kernel se compiló sin CONFIG_BLK_CGROUP y nada de esto aplica. Si aparece pero no está en cgroup.subtree_control, el controlador existe pero todavía no se delegó a los hijos. La página de systemd.resource-control(5) es explícita en esto: hay que referenciar el dispositivo físico de origen, no una partición ni un loop device.
¿Cómo creo un slice de systemd para aislar el backup?
Creás un slice dedicado (backup.slice) y colgás el servicio de backup ahí: todo lo que ese job genere (restic, rclone, un pipeline de shell) hereda el mismo presupuesto, y después podés subir el límite editando solo el slice.
El slice (/etc/systemd/system/backup.slice) lleva IOAccounting=yes y un CPUWeight=20 bajo. El servicio (restic-backup.service) apunta Slice=backup.slice y, de paso, fija IOSchedulingClass=best-effort e IOSchedulingPriority=7. Ojo con esas dos últimas líneas: son advisory en los schedulers modernos, no cuestan nada y ayudan en sistemas con BFQ, pero no son el mecanismo que realmente te protege. Eso lo hace el paso siguiente.
¿Cómo limito el ancho de banda de disco de un proceso con cgroup v2?
Limitás el ancho de banda de disco con un drop-in en el slice que fija IOReadBandwidthMax, IOWriteBandwidthMax e IOWriteIOPSMax apuntando al dispositivo físico, por ejemplo 200M de lectura, 100M de escritura y 2K IOPS en /dev/nvme0n1.
Tres cosas antes de copiar eso. Primero: los sufijos son base 1000, así que 100M son 100.000.000 bytes por segundo, no 104.857.600. Si pensabas en MiB, tu límite real queda un 4,6% por debajo de lo que calculaste. Segundo: el cap de bandwidth y el de IOPS actúan juntos, así que para escrituras chicas y random el límite que pega primero es el de IOPS, y para secuenciales grandes pega primero el de bandwidth, que es justo lo que querés para un backup. Tercero: la ruta se resuelve a un dispositivo. Apuntar a /srv funciona en layouts simples, pero no atraviesa RAID ni la mayoría de los volume managers, así que en cualquier cosa más compleja que LUKS sobre una partición hay que nombrar el dispositivo físico explícitamente. Relacionado: optimizar el rendimiento a nivel de kernel.
Después de aplicar con systemctl daemon-reload y reiniciar el servicio, cat /sys/fs/cgroup/backup.slice/io.max tiene que mostrar los valores exactos. Esa línea es la verdad de terreno: si falta, el controlador no está activo para el slice y reiniciar el servicio cien veces no cambia nada.
¿Cómo verifico que el límite se está aplicando de verdad?
Verificás el límite leyendo io.stat antes y después de una corrida, comparando el throughput real contra el cap, y confirmando con una prueba controlada de fio con direct=1 dentro del mismo slice.
io.stat da contadores en vivo por dispositivo (rbytes, wbytes, rios, wios). Dividís wbytes por los segundos de wall-clock y eso tiene que acercarse a tu cap, no superarlo por mucho. Sin límite, un restic en NVMe rápido va a mostrar cientos de MB/s; con el cap puesto, se achata.
Para una prueba limpia: systemd-run --unit=fiotest --property=Slice=backup.slice --wait --pipe fio --name=seqwrite --filename=/srv/fio-testfile --size=2G --rw=write --bs=1M --direct=1 --iodepth=16 --runtime=30 --time_based --group_reporting. Si el cap es 100M y ves 2 GB/s, el límite no está pegado al proceso: revisá io.max de nuevo y confirmá con systemctl status fiotest que la unidad realmente cayó dentro de backup.slice. En cómo responde un controller ante fallas profundizamos sobre esto.
¿Y iostat -x 1 con %util en 100%? No sirve como señal de saturación: en NVMe se pega a 100% aunque todavía haya margen. Mirá await y r_await, o directamente io.pressure, que reporta el tiempo real de stall.
io.max vs io.weight vs io.latency: ¿cuál usar para proteger la base de datos?
Usás io.max cuando conocés el presupuesto y querés aislamiento garantizado, io.weight cuando querés reparto justo sin techo fijo (confirmando antes que iocost o BFQ estén activos), e io.latency cuando el objetivo es proteger la latencia de un workload específico invirtiendo el problema.
La alternativa a poner un techo fijo es decirle al kernel qué latencia necesita la base y dejar que throttlee a quien se interponga. Con IODeviceLatencyTargetSec=/dev/nvme0n1 25ms en db.slice y un target más laxo (100ms) en backup.slice, cuando la base pierde su objetivo de 25ms, el backup se frena hasta que se recupera. Cuando la base está idle, el backup corre a full velocidad. Nada de presupuesto estático ni capacidad desperdiciada. Eso sí: necesita CONFIG_BLK_CGROUP_IOLATENCY y un target alcanzable. Poner 1ms en un disco que no puede entregarlo significa throttling permanente de todo lo demás sin beneficio para nadie.
Errores comunes al configurar límites de I/O con cgroup v2
- Medir con dd sin oflag=direct: reporta velocidad de copiar a page cache (memoria), no al disco. Puede mostrar 3 GB/s mientras el cgroup está capado a 100 MB/s, porque los bytes todavía no llegaron al dispositivo.
- Asumir que io.weight hace algo en un sistema stock: el reparto proporcional lo da iocost o BFQ. Con
noneomq-deadline, podés setear y leer weights sin que cambie nada. Confirmá concat /sys/fs/cgroup/io.cost.qos. - Poner el límite sobre una partición en vez del dispositivo físico: funciona en layouts simples, pero no atraviesa RAID ni la mayoría de los volume managers.
- Confiar en io.latency sin blkcg_debug_stats habilitado: los campos
missedytotalsolo aparecen con esa opción activa, que viene apagada por default. Sin eso, estás tuneando un controlador que no podés observar. - Intentar limitar un backup sobre NFS: no hay dispositivo de bloque que throttlear, así que
io.maxsobre un directorio montado por red no hace nada.
El writeback atribuido a un cgroup solo funciona en ext2, ext4, btrfs, f2fs y xfs. En otros filesystems, esa I/O se carga al cgroup raíz, y un límite en tu slice de backup no agarra los datos que la page cache vuelca después. Antes de confiar en los números, corré findmnt -no FSTYPE /srv. Para más detalles técnicos, mirá mantener bajo control el consumo de recursos.
Preguntas Frecuentes
¿Por qué ionice ya no limita el I/O en Linux?
Porque el scheduler que respetaba esa prioridad, CFQ, se eliminó en Linux 5.0. Los schedulers default en NVMe (mq-deadline, none) no leen la prioridad que fija ioprio_set(2), así que ionice -c3 registra un valor que nadie consulta.
¿Cómo limito el ancho de banda de disco de un proceso con cgroups v2?
Con un drop-in de systemd que fija IOReadBandwidthMax e IOWriteBandwidthMax apuntando al dispositivo físico (por MAJ:MIN), dentro de un slice dedicado. El límite queda escrito en /sys/fs/cgroup/[slice]/io.max y ese archivo es la verificación final de que está activo.
¿Qué diferencia hay entre io.max, io.weight y io.latency?
io.max es un techo duro de bytes o IOPS por segundo (blk-throttle). io.weight reparte proporcionalmente el tiempo de I/O entre grupos hermanos, pero solo funciona si iocost está habilitado o el scheduler es BFQ. io.latency protege un objetivo de latencia throttleando a los pares cuando ese objetivo se incumple.
¿Cómo evito que un backup afecte la latencia de mi base de datos?
Poniendo un techo con io.max en el slice del backup, o invirtiendo el problema con IODeviceLatencyTargetSec en el slice de la base de datos, para que el kernel throttlee automáticamente al backup cuando la base pierde su objetivo de latencia.
¿Cómo verifico que un límite de cgroup se está aplicando realmente?
Leyendo io.stat antes y después de una corrida y comparando el throughput real contra el límite configurado en io.max, o corriendo una prueba controlada con fio --direct=1 dentro del mismo slice. Si el throughput medido supera el cap, el límite no está pegado al proceso correcto.
Conclusión
Si un backup te está pisando la latencia de la base, la solución no es bajarle la prioridad: es darle un presupuesto y verificarlo en io.max. ionice quedó obsoleto para la mayoría de los schedulers modernos, y cgroup v2 te da tres herramientas distintas (techo, peso, latencia) que no son intercambiables entre sí. El criterio práctico es simple: si conocés el límite de tráfico que podés tolerar, usá io.max; si no lo conocés pero sabés qué latencia necesita tu base, invertí el problema con IODeviceLatencyTargetSec. Lo que no deberías hacer es confiar en un número sin confirmarlo primero en el archivo del sysfs correspondiente, porque ese archivo nunca miente sobre lo que el kernel está aplicando de verdad.