Conexiones Postgres Next.js: por qué se agotan
En pocas palabras: Cada instancia serverless crea su propio pool: con max: 10 y 15 instancias concurrentes, la app pide hasta 150 conexiones contra un límite de 100. Se corrige creando el pool una sola vez a nivel módulo, achicando max y sumando un pooler como PgBouncer; en Vercel, con attachDatabasePool.
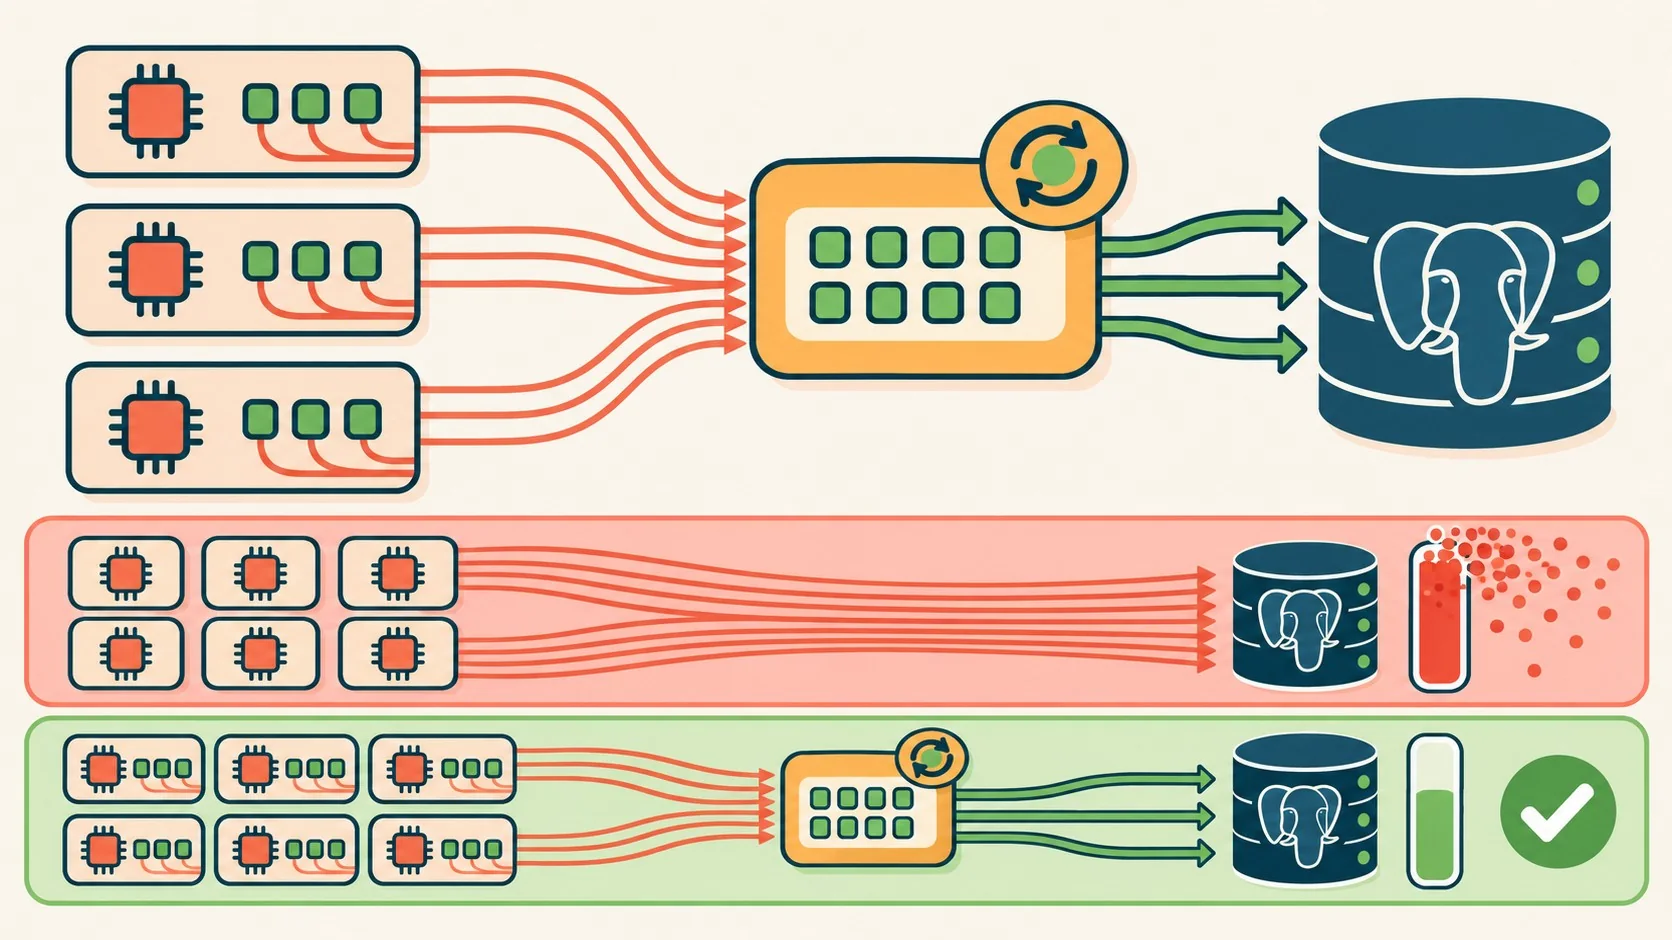
Las conexiones Postgres Next.js se agotan en producción porque cada instancia serverless arma su propio pool: con max: 10 y 15 instancias concurrentes, la app intenta abrir hasta 150 conexiones contra un límite de 100. Se corrige con un pool único por módulo, un max chico y un pooler.
Un pool de conexiones es un conjunto de conexiones abiertas a la base que la aplicación reutiliza en vez de abrir una por request. En node-postgres, la clase Pool crea clientes de a uno, a demanda, con un máximo de 10 por defecto. Un Route Handler de Next.js es la función GET o POST de un archivo route.ts que atiende cada request HTTP.
En este artículo:
- En 30 segundos
- ¿Por qué funciona en local pero falla al deployar en serverless?
- ¿Cómo se multiplican las conexiones Postgres Next.js en cada instancia serverless?
- ¿Qué error de Postgres aparece cuando se agotan las conexiones?
- ¿Dónde se crea el Pool de pg en Next.js para reutilizar conexiones?
- ¿Qué valor de max e idleTimeoutMillis conviene usar en serverless?
- ¿Cuándo hace falta PgBouncer y qué modo de pooling usar?
- ¿Qué está confirmado y qué no?
- Errores comunes con el pool de Postgres en Next.js
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Crear el Pool dentro del handler abre conexiones nuevas en cada invocación. En local no se nota porque
next devcorre en un único runtime de Node. - La cuenta del relato de dev.to: max 10 por 15 instancias da hasta 150 conexiones contra un límite de 100.
- El arreglo base: pool en
lib/db.ts, cacheado englobalThisfuera de producción, yclient.release()en unfinally. - El valor de max es discutido: dev.to propone 1 o 2 por instancia, Vercel advierte que 1 perjudica la concurrencia con Fluid compute. Medí.
- Para picos de concurrencia, PgBouncer en modo transaction pooling.
¿Por qué funciona en local pero falla al deployar en serverless?
Porque next dev corre en un único proceso de Node de larga vida y las requests llegan de a una, así que el límite de Postgres local (100 conexiones por defecto, según el relato) casi nunca se toca. En serverless cada invocación puede caer en una instancia nueva, y un new Pool() dentro de GET() paga el handshake TCP y TLS cada vez.
La fuente de este caso es un relato en primera persona publicado en dev.to el 7 de octubre de 2026, no documentación oficial. El autor cuenta que con tráfico bajo la base ya rechazaba conexiones. Es una experiencia, no una medición, y conviene leerla así.
// app/api/data/route.ts (anti-patrón)
export async function GET() {
 const pool = new Pool({ connectionString: process.env.DATABASE_URL });
 const client = await pool.connect();
 try {
 const result = await client.query('SELECT NOW()');
 return NextResponse.json(result.rows);
 } finally {
 client.release();
 }
}
Según la guía de Vercel sobre pools con Fluid compute, abrir una conexión implica handshake TCP, autenticación y asignación de recursos que pueden tardar 50 a 100 ms o más. Pagar eso en cada request es un gol en contra que no figura en ningún log.
¿Cómo se multiplican las conexiones Postgres Next.js en cada instancia serverless?
Cada instancia que levanta la plataforma ejecuta tu código con su propio pool, así que el total es max por la cantidad de instancias concurrentes. Con max: 10 y 15 instancias, la cuenta del relato da hasta 150 conexiones; si tu base admite 100, las requests empiezan a fallar con rechazos o timeouts. Te puede servir nuestra cobertura de desplegar tu proyecto gratis en Vercel.
El ciclo es este: cold start, ejecución, congelamiento de la instancia y, si llegan requests en paralelo, instancias hermanas que repiten todo con pools nuevos. Y como Postgres asigna un proceso del sistema operativo por conexión, cada una cuesta de verdad. Ponele que tenés un pico después de un deploy, las instancias viejas quedan congeladas con sockets abiertos, las nuevas abren los suyos y la base ve el doble de conexiones de las que tu código cree estar usando.
Ese último punto lo confirma Vercel: cuando una función se suspende, los timeouts de conexiones ociosas no corren, y las conexiones quedan abiertas hasta que la VM se apaga o la base las corta. La guía oficial de pooling con Vercel Functions le llama uso “fantasma” del pool.
Ojo con un matiz. Con Fluid compute, que según esa guía es el modelo por defecto en proyectos nuevos de Vercel, varias invocaciones concurrentes comparten una instancia y por lo tanto un pool. La multiplicación existe igual, pero con menos instancias.
¿Qué error de Postgres aparece cuando se agotan las conexiones?
Depende del límite que toques. Por conocimiento general de Postgres (las fuentes no traen mensajes exactos), sorry, too many clients already indica que llegaste al max_connections del servidor, y too many connections for role indica un tope por rol. El relato de dev.to solo habla de conexiones rechazadas y timeouts. Fijate primero cuál de los dos límites estás pegando, porque la solución cambia. Tema relacionado: comparativa entre Vercel y AWS Amplify.
¿Dónde se crea el Pool de pg en Next.js para reutilizar conexiones?
En el ámbito del módulo, fuera de cualquier handler, por ejemplo en lib/db.ts, y exportado para que los Route Handlers lo importen. Así las invocaciones de una instancia caliente reutilizan los mismos sockets en vez de repetir el handshake. En desarrollo, el hot reload reevalúa módulos, por eso el relato cachea el pool en globalThis.
// lib/db.ts
import { Pool } from 'pg';

const globalForDb = globalThis as unknown as { connPool?: Pool };

export const pool =
 globalForDb.connPool ??
 new Pool({
 connectionString: process.env.DATABASE_URL,
 max: 2, // valor de ejemplo, ajustalo
 idleTimeoutMillis: 10000,
 connectionTimeoutMillis: 5000,
 });

if (process.env.NODE_ENV !== 'production') globalForDb.connPool = pool;
// app/api/data/route.ts
import { NextResponse } from 'next/server';
import { pool } from '@/lib/db';
export async function GET() {
const client = await pool.connect();
try {
const result = await client.query('SELECT NOW()');
return NextResponse.json(result.rows);
} finally {
client.release();
}
}Si desplegás en Vercel, la guía suma attachDatabasePool(pool) de @vercel/functions justo después de crear el pool. Según Vercel, ese helper cierra las conexiones ociosas antes de que la instancia se suspenda, usando waitUntil para mantenerla viva lo justo.
Tres advertencias de la documentación de node-postgres:
- Liberá siempre el cliente. Si olvidás
release(), el pool se queda sin clientes y lospool.connect()siguientes dan timeout, o se cuelgan siconnectionTimeoutMillises 0. - No uses
pool.queryen transacciones. Cada llamada puede caer en un cliente distinto y la transacción se rompe. - Escuchá el evento
errordel pool. Sin listener, un error de un cliente ocioso puede tirar el proceso de Node.
¿Qué valor de max e idleTimeoutMillis conviene usar en serverless?
No hay un valor universal. El relato de dev.to recomienda max de 1 o 2 por instancia; la guía de Vercel dice que max: 1 no reduce las conexiones totales y perjudica la concurrencia con Fluid compute. Arrancá bajo y medí. Más contexto en cuánto cuesta realmente Vercel con Next.js.
| Parámetro | Default de node-postgres | Relato de dev.to | Guía de Vercel |
|---|---|---|---|
| max | 10 | 1 o 2 por instancia | Evitar 1 |
| idleTimeoutMillis | 10000 | 10 a 15 s | Unos 5 s |
| connectionTimeoutMillis | 0 (sin timeout) | Bajo, para fallar rápido (ejemplo con 5000) | No lo especifica |
| min | 0 | No lo menciona | 1 |
Los dos consejos se pisan, y no me cierra copiar uno sin saber en qué modelo de ejecución corrés. Si cada instancia atiende requests casi de a una, max: 1 tiene lógica. Si varias requests comparten instancia, ese 1 las encola. Tomalo con pinzas: ninguna de las dos fuentes publica mediciones. Otro detalle de node-postgres: min evita que el pool cierre clientes, pero no crea clientes hasta llegar a ese número.
¿Cuándo hace falta PgBouncer y qué modo de pooling usar?
Hace falta cuando limitar cada instancia no alcanza: si 200 usuarios disparan 200 instancias a la vez, se piden 200 conexiones aunque cada una use max: 1. PgBouncer se ubica entre las funciones y Postgres, mantiene pocas conexiones reales y acepta muchas efímeras. Para serverless, el relato recomienda transaction pooling.
Según el relato de dev.to, en transaction pooling las conexiones vuelven al pool apenas termina la query o la transacción. Por eso unas pocas conexiones sirven a muchos handlers. Ya lo cubrimos antes en costo oculto de PostgreSQL gestionado frente a Hetzner.
Si tu proveedor ofrece un pooler gestionado, verificá si usa transaction o session pooling antes de cambiar DATABASE_URL. Y si tu Postgres corre en un VPS o servidor propio (por ejemplo en donweb.com), instalar y configurar el pooler corre por tu cuenta.
¿Qué está confirmado y qué no?
- Confirmado por documentación: los defaults de node-postgres (max 10, idle 10000 ms, connection timeout 0), la fuga de conexiones al suspenderse una función y el rol de
attachDatabasePoolen Vercel. - Relato de una persona: los síntomas con tráfico bajo y la recomendación de max 1 o 2. No hay mediciones ni método publicado.
- Aritmética de ejemplo: los 150 contra 100 son una cuenta ilustrativa, no un incidente medido.
- Sin datos: qué max conviene en tu carga y cuántas instancias concurrentes escala tu plataforma en un pico real.
Una propuesta editorial para verificar en tu caso (no viene de las fuentes y no la probamos): multiplicá tu max por el pico de instancias que ves en el panel de tu plataforma y comparalo con el límite de la base. Durante un pico, contá las filas de pg_stat_activity por estado y logueá pool.totalCount, idleCount y waitingCount, que node-postgres documenta. Si waitingCount sube con la base holgada, tu max quedó corto.
Errores comunes con el pool de Postgres en Next.js
- Crear el Pool dentro de
GEToPOST. Se resuelve moviéndolo a un módulo compartido. - Llamar
pool.end()en cada request. El relato advierte que cada llamada igual paga handshake; el pool existe para no cerrarlo. - Copiar max: 1 sin mirar el modelo de ejecución. Con Fluid compute, Vercel lo desaconseja.
- Dejar
connectionTimeoutMillisen 0. Si el pool se llena, las requests esperan hasta que la función llega a su límite de ejecución. Poné un timeout corto. - Apuntar a un pooler sin saber su modo. El relato recomienda transaction pooling para serverless; verificá cuál usa tu proveedor antes de cambiar
DATABASE_URL.
Preguntas Frecuentes
¿Por qué Next.js agota las conexiones de Postgres en producción?
Porque cada instancia serverless crea su propio pool y el total de conexiones es max por instancias concurrentes. Si además instanciás el Pool dentro del handler, cada invocación abre conexiones nuevas, y las de una instancia congelada pueden quedar abiertas en la base.
¿Dónde tengo que crear el Pool de pg en Next.js?
En el ámbito del módulo, por ejemplo en lib/db.ts, nunca dentro de un Route Handler. En desarrollo conviene cachearlo en globalThis para que el hot reload no deje pools huérfanos.
¿Qué valor de max conviene usar en un pool de Postgres en serverless?
Las fuentes no coinciden: el relato de dev.to sugiere 1 o 2 por instancia y Vercel desaconseja 1 con Fluid compute. El default de node-postgres es 10, que en serverless multiplica rápido. Arrancá con un valor bajo y ajustalo mirando waitingCount.
¿Para qué sirve PgBouncer con Vercel o funciones serverless?
PgBouncer mantiene un pool chico de conexiones reales hacia Postgres y acepta muchas conexiones efímeras de las funciones. Protege a la base cuando la plataforma escala a cientos de instancias a la vez, algo que limitar max por instancia no resuelve.
¿Qué diferencia hay entre transaction pooling y session pooling?
Según el relato de dev.to, en transaction pooling las conexiones vuelven al pool apenas termina la query o la transacción, así un pool diminuto sirve a una flota grande de handlers; por eso lo recomienda para serverless. Si tu proveedor ofrece un endpoint gestionado, verificá cuál de los dos modos usa.
Conclusión
El relato de dev.to no descubre nada nuevo, pero ordena bien el problema, y la documentación de Vercel y node-postgres respalda lo central: un pool por módulo, liberación de clientes y cuidado con las instancias suspendidas. Lo discutible es el número de max, y ahí no hay atajo: depende de si tus instancias atienden una request o varias a la vez.
Antes de tocar nada, revisá este checklist en tu repo:
- Ningún
PoolniClientdentro del cuerpo de los handlers. - Pool único en módulo, cacheado en
globalThisfuera de producción. client.release()en unfinallyy un listener para el eventoerror.- max e idle acotados, con timeouts que fallen rápido.
- Pooler externo en transaction pooling si tu pico de instancias supera el límite de la base.