Hub and Spoke en Azure Bicep: 5 errores que explotan
En pocas palabras: El error AnotherOperationInProgress al desplegar varios virtualNetworkPeerings en loop se resuelve con el decorator @batchSize(1) en Bicep, que fuerza el despliegue secuencial sobre la VNet hub en lugar de paralelo, evitando que varias escrituras choquen contra el mismo recurso.
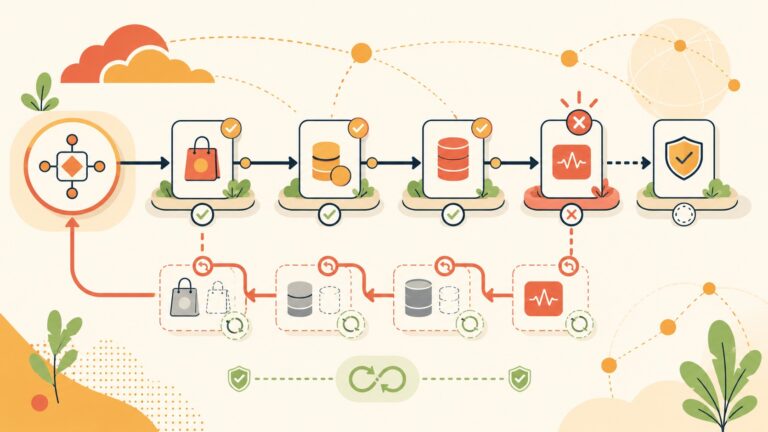
Un deploy de hub and spoke en Azure Bicep que crea varios peerings en loop falla en forma intermitente con el error AnotherOperationInProgress, porque cada peering es hijo de la VNet hub y Azure solo permite una operación de escritura a la vez sobre ese recurso. La solución documentada es un decorator, @batchSize(1), que fuerza el despliegue secuencial en vez de paralelo.
Hub and spoke es un patrón de arquitectura de red que Microsoft recomienda en el Cloud Adoption Framework de Azure: una VNet central (hub) concentra servicios compartidos como firewall, VPN Gateway y Bastion, mientras varias VNets periféricas (spokes) aíslan cargas de trabajo y se conectan al hub mediante peering. En Bicep, ese patrón se declara con recursos virtualNetworks y virtualNetworkPeerings, con decorators y funciones (como cidrSubnet) que evitan errores comunes de despliegue.
En este artículo:
- En 30 segundos
- ¿Por qué falla el deploy al crear varios peerings en loop con Bicep?
- ¿Por qué dos spokes peered al hub no pueden comunicarse entre sí?
- ¿Cómo evitar que los rangos de subred hardcodeados generen conflictos?
- ¿Qué configuración necesita el forced tunneling en las route tables de los spokes?
- ¿Por qué un Azure Firewall recién creado bloquea todo el tráfico saliente?
- Checklist para validar tu despliegue hub and spoke en Azure Bicep antes de producción
- Errores comunes al armar hub and spoke en Bicep
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El error AnotherOperationInProgress aparece cuando un loop de Bicep despliega varios virtualNetworkPeerings en paralelo contra el mismo hub; se resuelve con
@batchSize(1). - El peering no es transitivo: dos spokes conectados al mismo hub no se ven entre sí a menos que rutees por un Azure Firewall o armes peering directo (con 10 spokes, una malla completa son 45 peerings).
- La función
cidrSubnet()calcula subredes a partir de un rango padre (por ejemplo 10.0.0.0/22) y evita que un addressPrefix hardcodeado quede fuera de rango cuando cambia el espacio del hub. - Antes de activar forced tunneling hay que poner
disableBgpRoutePropagation: trueen la route table del spoke y cargar allow rules en el firewall, porque una policy nueva bloquea todo el tráfico saliente por default. - Azure Firewall y Bastion se facturan por hora aunque estén idle, así que conviene declararlos como parámetros opcionales en el template.
¿Por qué falla el deploy al crear varios peerings en loop con Bicep?
Falla porque cada virtualNetworkPeering es un recurso hijo de la VNet hub, y Azure solo acepta una actualización concurrente sobre esa VNet. Un loop estándar de Bicep despliega sus iteraciones en paralelo por default, así que cuando tenés tres o cuatro spokes peered al mismo hub, varias peticiones de escritura chocan entre sí.
El síntoma es el mensaje AnotherOperationInProgress: Another operation on this or dependent resource is in progress. Es intermitente, lo que lo hace especialmente molesto: no sigue una lógica visible, es puro timing de red. Según el análisis técnico publicado en Bicep & Beyond, la corrección es agregar el decorator @batchSize(1) arriba del recurso en loop, lo que obliga a Bicep a desplegar los peerings de a una.
@batchSize(1)
resource hubToSpoke 'Microsoft.Network/virtualNetworks/virtualNetworkPeerings@2023-05-01' = [
 for (spoke, i) in spokes: {
 parent: hub
 name: 'peer-hub-to-${spoke.name}'
 properties: {
 remoteVirtualNetwork: { id: spokeVnets[i].id }
 allowVirtualNetworkAccess: true
 allowForwardedTraffic: true
 }
 }
]
El costo es un deploy un poco más lento. Pero deja de fallar por esta razón, que no es poco cuando tenés un pipeline de CI/CD que reintenta automáticamente y multiplica el ruido en los logs.
¿Por qué dos spokes peered al hub no pueden comunicarse entre sí?
No pueden comunicarse porque el peering de VNet en Azure no es transitivo: conecta solo las dos VNets entre las que se declara. Si el Spoke A está peered con el hub y el Spoke B también, eso no abre automáticamente una ruta entre A y B. En los fundamentos del diseño hub-spoke en la nube profundizamos sobre esto.
Ponele que tenés un spoke de aplicación y otro de base de datos, ambos conectados al hub, y asumís que por estar “en la misma arquitectura” ya se ven. No se ven. El tráfico de A hacia B simplemente no tiene a dónde ir, porque cada peering es un acuerdo bilateral, no una red mallada implícita.
Hay dos caminos, según documenta la misma guía de Bicep & Beyond:
- Rutear por el hub: poner Azure Firewall (u otro NVA) en el hub, agregar una route table en cada spoke que mande el tráfico hacia el otro spoke a la IP privada del firewall, y permitirlo con una regla de firewall. Es la opción más usada porque te da un único punto de inspección y log.
- Peering directo entre spokes: funciona bien con dos o tres spokes, pero escala mal: con 10 spokes, una malla completa implica 45 peerings.
Cualquiera de las dos opciones que elijas, necesitás allowForwardedTraffic: true en los peerings. Sin eso, el tráfico que pasó por el firewall llega marcado como “forwarded” y Azure lo descarta igual, aunque el firewall lo haya aprobado.
¿Cómo decidir entre peering directo y rutear por el hub?
El criterio práctico es la cantidad de spokes que necesitan hablar entre sí, porque una malla completa de peering directo crece según la fórmula n×(n-1)/2 (cada par de spokes necesita su propia conexión). Con pocos spokes el número es chico y manejable a mano; a partir de cierto punto, administrar y auditar cada peering por separado deja de ser razonable y conviene centralizar el tráfico en el firewall del hub.
| Spokes que necesitan comunicarse | Peerings en malla completa | Enfoque más práctico |
|---|---|---|
| 3 | 3 | Peering directo, manejable a mano |
| 5 | 10 | Empieza a convenir evaluar el firewall |
| 10 | 45 | Rutear por el hub (único punto de inspección) |
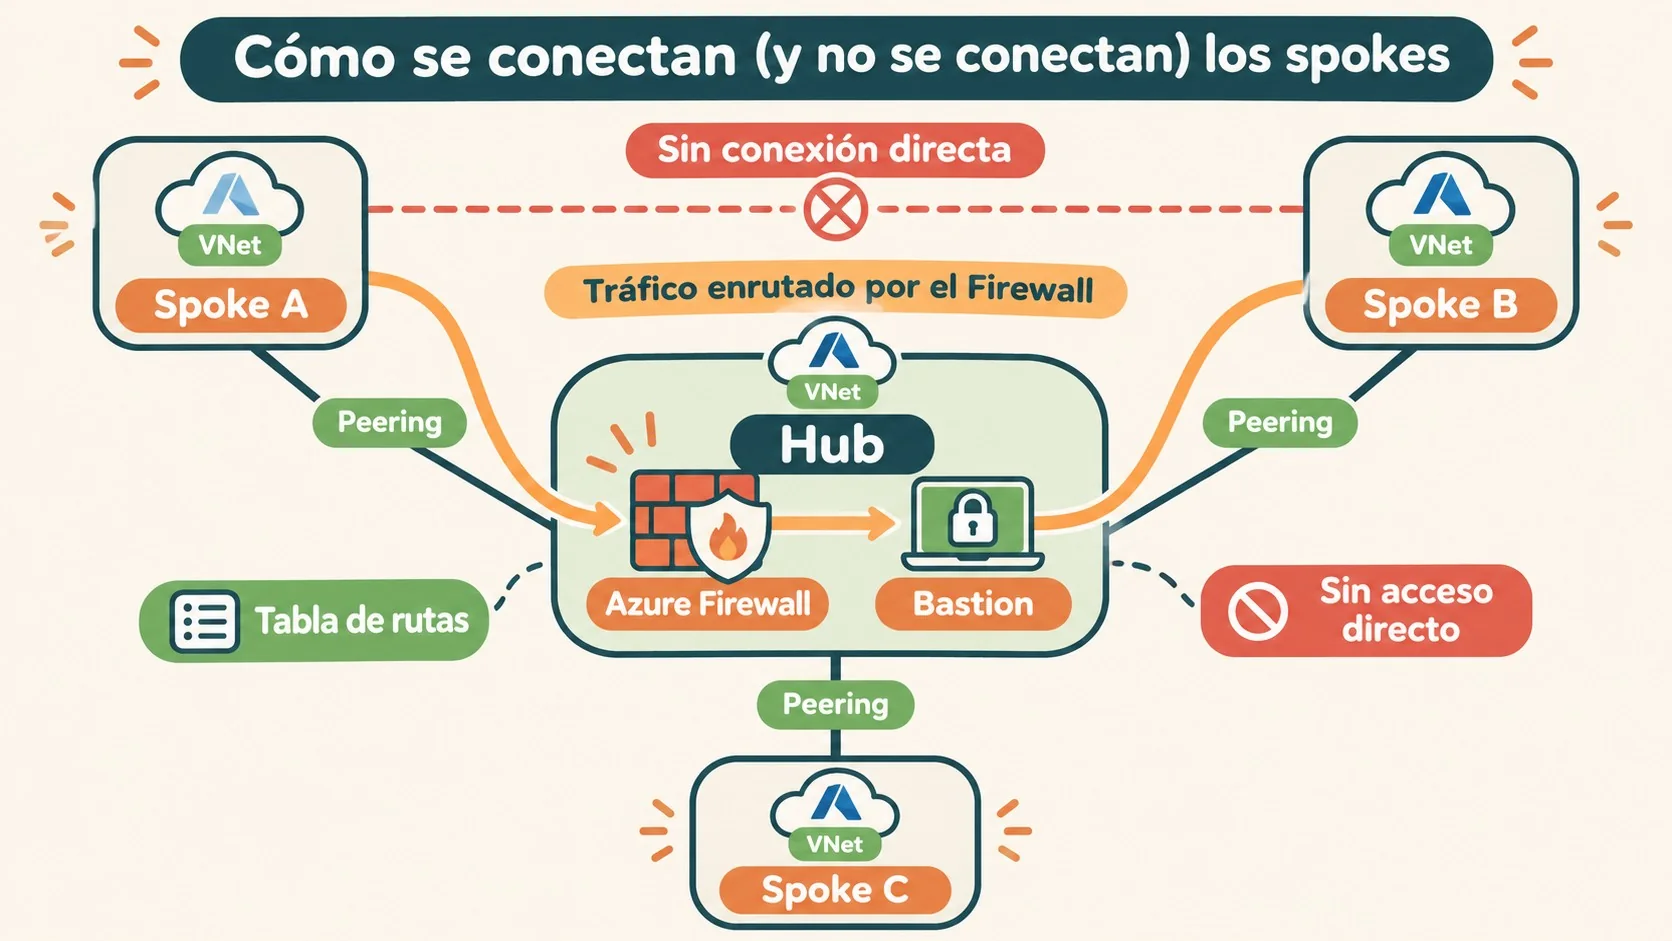
Ejemplo hipotético, no un caso real: pensemos en un equipo que arranca con un spoke de dev, uno de staging y uno de producción, y en algún momento necesita que staging y producción se sincronicen entre sí para un proceso batch. Con esos 3 spokes, armar el peering directo entre staging y producción es una línea más de Bicep y no pesa en el mantenimiento. Si ese mismo equipo después abre un spoke por cada equipo de producto y llega a 10, mantener una malla de 45 peerings sueltos —cada uno con su propia regla de allowForwardedTraffic para revisar— se vuelve difícil de auditar a ojo. En ese escenario, centralizar el tráfico spoke-a-spoke en el Azure Firewall del hub no es una preferencia estética: es la única forma de tener, en un solo lugar, quién puede hablar con quién.
¿Cómo evitar que los rangos de subred hardcodeados generen conflictos?
Se evita calculando las subredes con la función cidrSubnet() de Bicep en vez de escribir el prefijo a mano. El problema del hardcoding aparece cuando alguien del equipo cambia el address space del hub meses después y se olvida de ajustar una subred, que termina quedando fuera del rango de la VNet y rompe el deploy.
La alternativa calcula todo a partir de un único parámetro raíz:
param hubAddressSpace string = '10.0.0.0/22'

var sharedSubnetPrefix = cidrSubnet(hubAddressSpace, 24, 0) // 10.0.0.0/24
var firewallSubnetPrefix = cidrSubnet(hubAddressSpace, 26, 4) // 10.0.1.0/26
var bastionSubnetPrefix = cidrSubnet(hubAddressSpace, 26, 5) // 10.0.1.64/26
Los tres argumentos son el rango padre, el prefijo nuevo que querés y el índice de esa subred dentro del rango (contando desde cero). Cambiás hubAddressSpace una sola vez y todas las subredes se recalculan solas. Es el tipo de ajuste chico que no se nota hasta que lo necesitás, y ahí salva una tarde entera de debug.
¿Qué configuración necesita el forced tunneling en las route tables de los spokes?
Necesita disableBgpRoutePropagation: true en la route table del spoke, además de la ruta default hacia el firewall. Si tenés un VPN Gateway o un circuito ExpressRoute conectado al hub, ese gateway puede anunciar por BGP rutas más específicas que tu 0.0.0.0/0, y esas rutas más específicas ganan por default, lo que rompe el forced tunneling sin que nadie toque nada a propósito.
resource spokeRouteTable 'Microsoft.Network/routeTables@2023-05-01' = {
 name: 'rt-spokes'
 location: location
 properties: {
 disableBgpRoutePropagation: true
 routes: [
 {
 name: 'default-via-firewall'
 properties: {
 addressPrefix: '0.0.0.0/0'
 nextHopType: 'VirtualAppliance'
 nextHopIpAddress: firewall.properties.ipConfigurations.properties.privateIPAddress
 }
 }
 ]
 }
}
Apagar la propagación BGP en las route tables de los spokes garantiza que el tráfico siga yendo por el firewall, aunque el gateway esté anunciando otra cosa.
¿Por qué un Azure Firewall recién creado bloquea todo el tráfico saliente?
Bloquea todo porque una policy nueva de Azure Firewall nace sin allow rules. En el momento en que agregás la route default del punto anterior, cada llamada saliente de los spokes empieza a fallar: instalación de paquetes, Windows Update, llamadas a servicios de Azure, todo.
Subís el modelo de red, probás el peering en local, el forced tunneling queda prolijo en el diagrama, hacés el deploy a producción y de repente ningún workload puede salir a internet porque nadie cargó una sola regla de firewall antes de prender el tunneling (spoiler: es el gotcha que más gente pisa la primera vez). Antes de apuntar los spokes al firewall hace falta, como mínimo:
- Application rule collection con los dominios que tus workloads necesitan; los FQDN tags como
WindowsUpdateoAzureKubernetesServiceahorran escribir reglas a mano. - Network rules para el tráfico spoke a spoke, si decidiste rutearlo por el hub.
Y conviene declarar tanto Azure Firewall como Bastion como parámetros opcionales en el template. Ambos se facturan por hora aunque estén sin tráfico, y un entorno de test rara vez los necesita prendidos todo el tiempo.
Checklist para validar tu despliegue hub and spoke en Azure Bicep antes de producción
Antes de promover un template de hub and spoke a producción, conviene repasar estos puntos puntuales en vez de confiar en que “anduvo en dev”.
- @batchSize(1) en cualquier loop que cree peerings contra el hub.
- allowForwardedTraffic: true en los peerings hub-spoke si vas a rutear tráfico entre spokes.
- Un plan explícito para el tráfico spoke a spoke: por el firewall o por peering directo, no asumido.
- Subredes calculadas con
cidrSubnet()en vez de prefijos hardcodeados. - disableBgpRoutePropagation: true en las route tables de los spokes si forzás todo el tráfico por un firewall.
- Allow rules cargadas antes de activar el forced tunneling, no después.
- Firewall y Bastion como parámetros, apagados por default en entornos que no son producción.
Repasar el checklist anterior antes de promover el template a un ambiente que importe ayuda a evitar buena parte de estos gotchas, aunque no sustituye una revisión de seguridad completa.
Errores comunes al armar hub and spoke en Bicep
- Asumir que el peering alcanza para todo: mucha gente declara el peering hub-spoke y da por cerrado el tema de conectividad, sin planificar cómo van a hablar los spokes entre sí.
- Activar forced tunneling antes de cargar reglas: es el orden invertido de lo que corresponde, y el resultado es un ambiente entero sin salida a internet hasta que alguien nota los logs del firewall.
- Dejar Azure Firewall y Bastion siempre prendidos en dev: son los dos recursos que más silenciosamente inflan la factura de un entorno de pruebas que nadie usa los fines de semana.
- No fijar el batchSize en loops de peering: funciona en demos simples pero falla a medida que el número de spokes crece.
Si además estás evaluando dónde alojar la parte del proyecto que no necesita este nivel de complejidad de red (un sitio corporativo, un blog, un e-commerce chico), no todo tiene que vivir en una arquitectura hub and spoke. Para esos casos, un hosting administrado en Argentina como donweb.com resuelve lo mismo sin la curva de aprendizaje de VNets y firewalls.
Esto se conecta con arquitectura hub-and-spoke en Bicep, donde explicamos cómo armar el DNS privado paso a paso.
Preguntas Frecuentes
¿Qué es la arquitectura hub and spoke en Azure?
Es un patrón de red con una VNet central (hub) que concentra servicios compartidos como firewall, VPN Gateway y Bastion, y varias VNets periféricas (spokes) que aíslan cargas de trabajo distintas. Microsoft la documenta como la topología recomendada por el Cloud Adoption Framework para la mayoría de las landing zones.
¿El peering de VNet en Azure permite tráfico transitivo?
No. El peering solo conecta las dos VNets entre las que se declara explícitamente. Si necesitás que dos spokes se comuniquen, tenés que rutear por un firewall en el hub o crear un peering directo entre ellos; cuál conviene depende de cuántos spokes necesitan hablar entre sí, porque la cantidad de peerings de una malla completa crece mucho más rápido que la cantidad de spokes.
¿Qué hace el decorator @batchSize(1) en Bicep?
Fuerza a que las iteraciones de un loop se desplieguen de a una en lugar de en paralelo. Se usa típicamente en loops que crean virtualNetworkPeerings contra la misma VNet hub, donde el despliegue paralelo dispara el error AnotherOperationInProgress.
¿Para qué sirve la función cidrSubnet() en Bicep?
Calcula un rango de subred a partir de un prefijo padre, un nuevo tamaño de prefijo y un índice de subred. Permite declarar un solo parámetro con el address space del hub y que todas las subredes se recalculen automáticamente si ese rango cambia.
¿Por qué se recomienda hacer Azure Firewall y Bastion opcionales en el template?
Porque ambos recursos se facturan por hora aunque no reciban tráfico, y los entornos de test o desarrollo rara vez los necesitan activos todo el tiempo. Declararlos como parámetros con valor default apagado reduce el costo sin tocar el resto del template.
Conclusión
Ninguno de estos cinco gotchas es exótico: todos salen de cómo Azure maneja concurrencia, transitividad de red y reglas de firewall por default, y todos tienen una corrección puntual en Bicep. Lo que cambia la experiencia es anticiparlos en el template inicial (el decorator de batch, el plan de tráfico spoke a spoke según la cantidad de spokes involucrados, las subredes calculadas, la propagación BGP y las allow rules antes del tunneling) en vez de descubrirlos en producción cuando ya hay workloads reales atrás. Si estás armando una landing zone de Azure con Bicep desde cero, el checklist de este artículo es un buen filtro antes de promover el template a un ambiente que importe.
Fuentes
- Azure Hub-and-Spoke in Bicep: 5 Gotchas That Bite Later – Bicep & Beyond
- Topología de red hub-spoke en Azure – Azure Architecture Center (Microsoft)
- Microsoft.Network virtualNetworks/virtualNetworkPeerings – Referencia de templates Bicep/ARM
- How does one create vnets with peerings (chicken and egg?) – Azure/bicep discussions