Rotación de proxies para scraping: stickiness y backoff
En pocas palabras: La rotación de proxies funciona cuando se controlan tres variables independientes: granularidad (cuándo cambiás de IP), rate por salida y en conjunto, y backoff ante rechazos. Según dev.to (24/09/2026), un pool grande no soluciona un rate mal calibrado: solo reparte el mismo patrón de abuso entre más direcciones.
Un pool de proxies con mil IPs se bloquea en las primeras cien requests si el patrón de tráfico no coincide con el de un visitante real. Según una guía técnica publicada en dev.to el 24 de septiembre de 2026, el problema no es la cantidad de direcciones sino la combinación de velocidad, duración de sesión y reacción ante el rechazo.
La rotación de proxies para scraping es la técnica de cambiar la dirección IP desde la que un bot hace requests HTTP, para repartir el tráfico entre varias salidas y evitar que un sitio identifique un origen único. Cambiar de IP es apenas una parte: también hay que decidir con qué frecuencia rotás (granularidad), cuántas requests por segundo tolera cada salida (rate) y qué hacés cuando el sitio te rechaza (backoff).
En este artículo:
- En 30 segundos
- ¿Por qué un scraper con mil IPs igual termina bloqueado?
- ¿Cómo funciona la rotación de proxies para scraping en la práctica?
- Granularidad: ¿cuándo rotar por request, por sesión o fijar un proxy?
- Rate limit: ¿cuál es el techo por proxy y el techo agregado del sitio?
- ¿Cómo responder a un 429, un 403 y un soft block sin romper la corrida?
- ¿Cómo detectar que te están bloqueando antes de que sea tarde?
- Ejemplo de implementación: pool con token bucket, sticky sessions y retiro de proxies
- Errores comunes al configurar la rotación de proxies para scraping
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El bloqueo no depende de la cantidad de proxies sino del patrón: velocidad, duración de sesión y reacción ante el rechazo, según la guía de dev.to.
- Hay tres variables independientes: granularidad (cuándo cambiás de IP), rate (requests por segundo por proxy y en agregado) y backoff (qué hacés ante un rechazo).
- El techo por proxy recomendado es concurrencia de 1 a 4 y pocas requests por segundo; el techo agregado del sitio es lo que dispara un ban de rango completo.
- Un 200 con body corto o página de challenge es un soft block: un cliente ingenuo lo registra como éxito y reporta datos sucios.
- La tasa máxima de crawl se calcula como N (cantidad de exits) por b (requests por segundo por exit); el tamaño del pool es una cuenta aritmética, no una decisión de compra.
¿Por qué un scraper con mil IPs igual termina bloqueado?
Un pool de proxies con mil IPs se bloquea igual si el ritmo de las requests no imita a un visitante real. Los bloqueos casi nunca los causa una sola dirección mala, sino el patrón alrededor de ella: cuán rápido disparás, cuánto tiempo te quedás en una sesión y qué hacés cuando el target te empuja para atrás.
La mayoría de los equipos tratan la rotación como un único interruptor. En realidad son tres, y rotar más agresivo solo toca la primera (spoiler: no alcanza).
Si la tasa está mal calibrada, sumar proxies no soluciona nada, reparte el mismo abuso entre más direcciones y las termina marcando como grupo, lo cual es peor porque las IPs de reemplazo heredan la reputación del rango entero apenas entran al pool. Rotar más no es la solución. En nuestra guía práctica de rotación de IP profundizamos sobre esto.
¿Cómo funciona la rotación de proxies para scraping en la práctica?
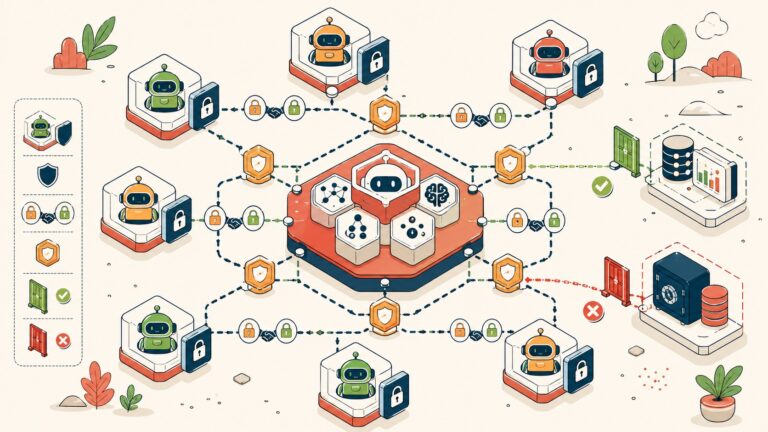
La rotación de proxies para scraping funciona asignando una IP distinta, o la misma según la regla vigente, a cada request o sesión, usando un pool que decide qué exit entregar en cada momento. El pool no elige al azar: valida que el proxy esté disponible, respeta bindings sticky vigentes y descarta exits que vienen fallando.
Lo que manda no es tu preferencia como desarrollador, sino la semántica de sesión del target: un flujo de autenticación necesita un exit coherente, mientras que un fetch anónimo no. Ahí es donde entra la granularidad.
Granularidad: ¿cuándo rotar por request, por sesión o fijar un proxy?
La granularidad correcta se elige por tarea, no por gusto: páginas estáticas y feeds de precios rotan libremente en cada request, mientras que un login o un formulario multi-paso necesitan un proxy sticky, sin excepción.
Un sticky session es una asignación de proxy que se mantiene fija durante N requests o T minutos, en vez de cambiar en cada llamada. Sirve para que el sitio vea una navegación coherente: un visitante real no cambia de país entre la página dos y la página tres de un checkout.
| Granularidad | Cambio de exit | Cuándo usarla | Cuándo falla |
|---|---|---|---|
| Por request | En cada llamada | Páginas estáticas, feeds de precios, paralelizar una consulta | El target ata la sesión a la navegación; falla en login o flujos CSRF |
| Sticky por sesión | Después de N requests o T minutos | Navegación con login, paginación, formularios multi-paso | TTL mal calibrado: muy largo concentra el volumen en un exit, muy corto parece bot |
| Pinned por target | Nunca, hasta retirarlo | Targets sensibles a la tasa, tareas atadas a una cuenta | El exit pinned se comparte en silencio con otro worker |
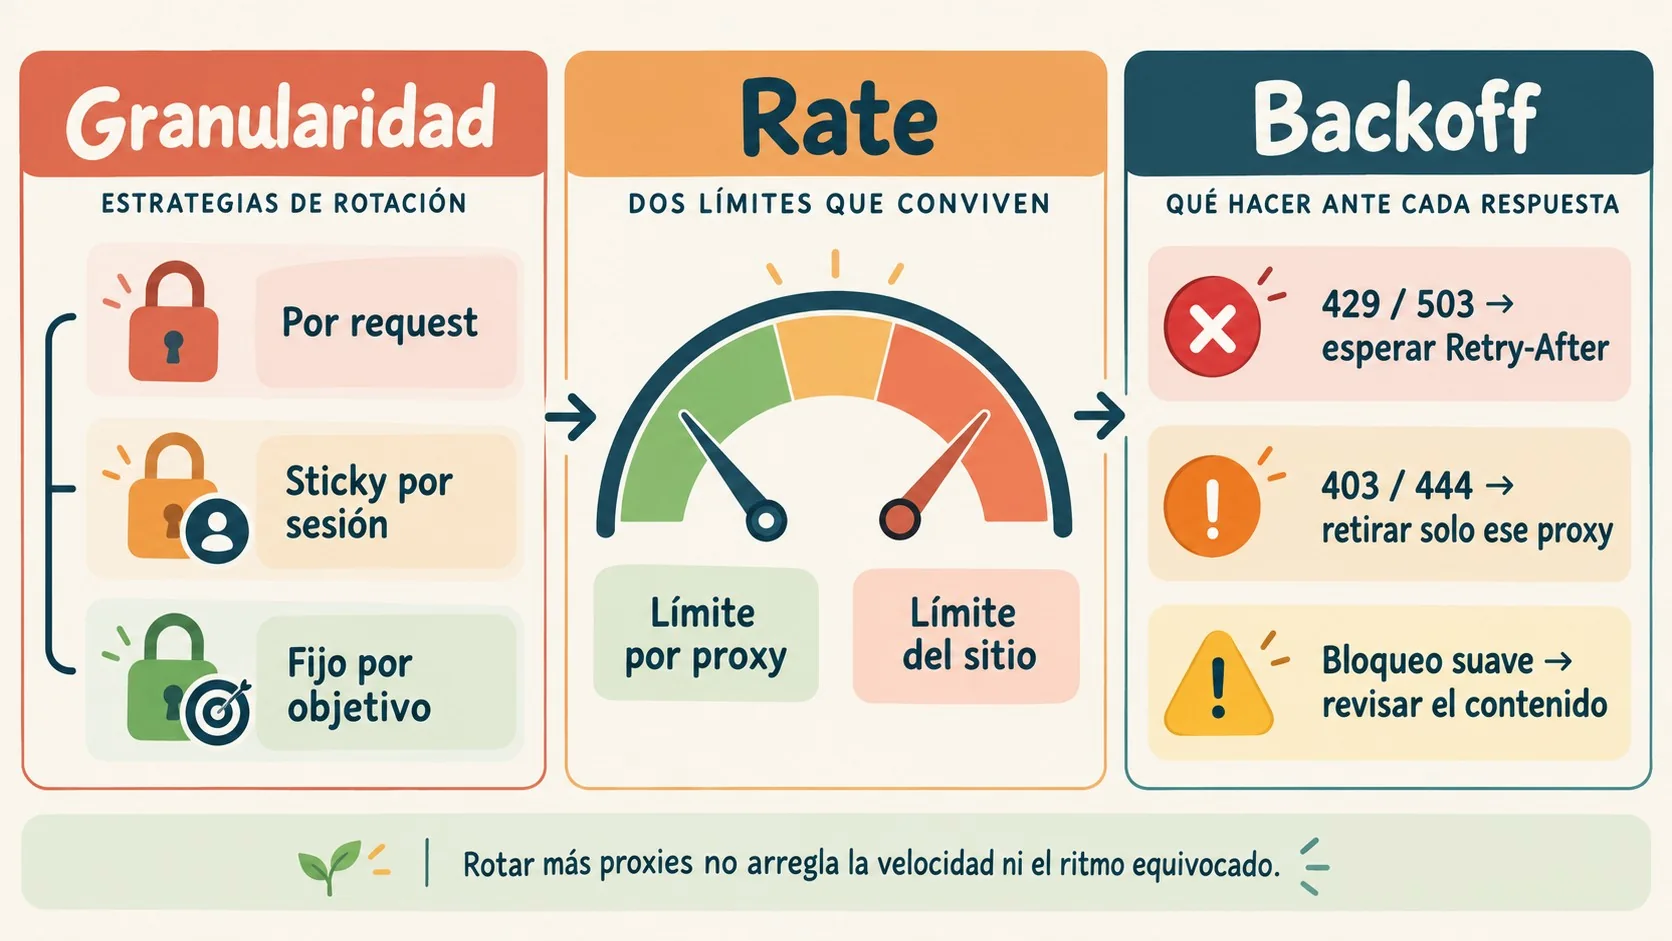
El tercer modo, pinned por target, fija un proxy hasta que se retira manualmente. Funciona para tareas atadas a una cuenta o targets sensibles a la tasa, pero falla si el exit pinned termina compartido en silencio entre dos workers del mismo pool, algo que pasa más seguido de lo que parece cuando la infraestructura crece rápido. Cubrimos ese tema en detalle en librerías Python alternativas a requests.
Rate limit: ¿cuál es el techo por proxy y el techo agregado del sitio?
Hay dos techos distintos y confundirlos es el error más común: el techo por proxy es lo que una línea real haría de forma plausible, y el techo agregado es lo que tolera el sitio en su población de visitantes completa.
Para el techo por proxy, la guía técnica de dev.to recomienda concurrencia de 1 a 4 y un ritmo de pocas requests por segundo como máximo. El techo agregado es el que dispara un ban de rango, y la rotación no lo esconde.
Si el pool tiene N exits a b requests por segundo cada uno, la tasa máxima de crawl es N × b. Esa cuenta responde si el scraper aguanta esta noche o la semana que viene, así que el tamaño del pool es aritmética, no una decisión de compra. No hay atajo acá.
Si corrés estos scrapers desde un VPS propio en vez de tu notebook, conviene tener la infraestructura de servidores separada de la del sitio productivo, algo que podés resolver con un proveedor de hosting como donweb.com.
¿Cómo responder a un 429, un 403 y un soft block sin romper la corrida?
Cada código pide una respuesta distinta: un 429 se respeta literal, un 403 en un solo exit se retira sin tocar el resto, y un soft block hay que detectarlo antes de reportarlo como éxito.
Si el target manda 429 o 503 con header Retry-After, hay que respetarlo literal. Ignorarlo escala un simple throttle a un ban directo.
Un 403 o 444 en un exit mientras el resto sigue funcionando significa retirar esa IP puntual, no frenar toda la corrida. Tirar abajo todo el proceso porque una dirección se gastó es la forma más común de convertir una hora de trabajo en tres días. Esto se conecta con lo que analizamos en comparativa entre API oficial y scraping.
Los soft blocks son los caros: un 200 “exitoso” que en realidad trae una página de challenge, un resultado vacío o un body truncado. ¿Alguien revisa el tamaño del body antes de dar por buena una respuesta? Casi nadie, y ahí es donde se terminan reportando datos que parecen limpios pero no lo son.
El backoff necesita jitter, y aplicado por proxy, no en forma global, para que los reintentos no se sincronicen en una ráfaga contra la misma dirección.
¿Cómo detectar que te están bloqueando antes de que sea tarde?
Se detecta midiendo tres cosas por proxy, nunca en agregado: tasa de éxito, latencia mediana y distribución del tamaño del body.
- Tasa de éxito por debajo de la mediana del pool: retirar cualquier exit que rinda bien por debajo del promedio, no solo el que está en cero.
- Caída brusca de latencia mediana: suele indicar que el sitio está devolviendo una página de challenge cacheada en vez de contenido real.
- Distribución del tamaño del body: las páginas reales se agrupan en un rango de tamaño parecido; las páginas de bloqueo no.
Ejemplo de implementación: pool con token bucket, sticky sessions y retiro de proxies
La guía de dev.to publica un pool en Python que resuelve las tres variables sin librerías externas.
La clase Exit implementa un token bucket: guarda el próximo momento permitido para hacer una request y un contador de fallos, y se considera usable mientras ese contador no llegue al máximo configurado. La clase Pool cicla entre exits usables y mantiene un diccionario de sesiones sticky con expiración (TTL); antes de reusar un binding, valida que el exit siga usable, así nunca entrega una dirección ya retirada. La función fetch intenta hasta cuatro veces: si el error es 403, 429 o 444, o si detecta un SoftBlock por body corto, suma un fallo al exit y aplica backoff exponencial con jitter antes del siguiente intento.
Dos detalles hacen que este pool sirva en producción real (que no es poco): pick() no devuelve nunca un exit retirado aunque tenga un sticky binding vigente, y el manejo de fallos suma un contador en vez de abortar la corrida completa. Eso convierte un pool en un recurso que se autorepara, en vez de una lista que hay que estar cuidando a mano. Sobre eso hablamos en automatizar scraping sin API con n8n.
Errores comunes al configurar la rotación de proxies para scraping
- Rotar en cada request contra un target atado a sesión: la rotación agresiva es en sí misma una señal de bot, no una forma de pasar desapercibido.
- Tratar un 403 como error de red y reintentar con el mismo exit: repetir la misma request contra el mismo rechazo convierte un soft block en un bloqueo permanente.
- Medir la salud del pool en agregado: esconde exits ya quemados que siguen recibiendo tráfico porque el promedio general todavía parece sano.
- Ignorar el header Retry-After: lo que empieza como un throttle temporal termina en un ban directo del rango.
Preguntas Frecuentes
¿Por qué me bloquean aunque uso proxies rotativos?
Porque la rotación es solo una de tres variables. Si el rate por proxy o el rate agregado están mal calibrados, un pool más grande reparte el mismo patrón de abuso entre más direcciones y las termina marcando como grupo.
¿Cuál es la diferencia entre proxy rotativo y sticky session?
Un proxy rotativo cambia de IP en cada request o según una regla de tiempo, mientras que una sticky session fija un mismo proxy durante N requests o T minutos para mantener una navegación coherente. Los flujos con login, CSRF o formularios multi-paso necesitan sticky; las páginas estáticas y los feeds de precios pueden rotar libremente.
¿Cuántas requests por segundo puedo hacer por proxy sin que me detecten?
La guía de dev.to recomienda concurrencia de 1 a 4 por exit y un ritmo de pocas requests por segundo como máximo, para que el tráfico se parezca al de una línea real. El número exacto depende del target: conviene empezar bajo y subir solo si la tasa de éxito se mantiene estable.
¿Qué hago cuando recibo un error 429 o 403 al scrapear?
Ante un 429 o 503 con header Retry-After, hay que respetar ese tiempo literal antes de reintentar. Ante un 403 o 444, conviene retirar solo ese proxy puntual y seguir la corrida con el resto del pool, en vez de frenar todo el proceso.
¿Cómo sé si un proxy fue bloqueado (soft block) aunque devuelva 200?
Un soft block se detecta cuando el body es mucho más chico de lo esperado, el resultado viene vacío o la página trae una pantalla de challenge en vez del contenido pedido. Medir la distribución del tamaño del body y la latencia mediana por proxy, en vez de confiar solo en el código HTTP 200, es la forma de pescarlo a tiempo.
Conclusión
El patrón importa más que el número de IPs. Un pool de mil proxies mal configurado en rate o granularidad se bloquea igual que uno de diez; la diferencia la marca cómo rotás, cuánto pedís por segundo y qué hacés apenas el sitio te frena. Si estás armando o rearmando un scraper, conviene arrancar por la tasa (N × b), después ajustar la granularidad según el flujo del target y recién al final pensar en cuántos exits necesitás. Comprar más proxies sin resolver eso primero es gastar presupuesto en tapar un síntoma.