Node.js 26.9 activa node:ffi por defecto: los números
En pocas palabras: Node.js 26.9.0, lanzado el 16 de septiembre de 2026, activa node:ffi por defecto sin necesidad de flags. Un benchmark independiente midió 37.5-38.1ns por llamada, un 7-8% más lento que un addon N-API equivalente (34.1-35.8ns). El módulo sigue marcado como experimental.
Node.js 26.9.0, lanzado el 16 de septiembre de 2026, activa node:ffi por defecto: ya no hace falta --experimental-ffi para llamar funciones nativas desde JavaScript. Un benchmark independiente midió 37.5-38.1ns por llamada contra 34.1-35.8ns de un addon N-API equivalente, un 7-8% más lento que la alternativa que dice reemplazar.
node:ffi Node.js 26.9 es la primera versión estable donde el módulo de interfaz de funciones foráneas de Node.js funciona sin flags. node:ffi permite cargar bibliotecas dinámicas (.so, .dylib, .dll) y llamar símbolos nativos en C directamente desde JS, sin escribir un addon compilado con node-gyp. Sigue marcado como experimental según la documentación oficial de Node.js.
En este artículo:
- En 30 segundos
- ¿Qué cambió exactamente en Node.js 26.9 con node:ffi?
- ¿Cuánto cuesta realmente una llamada con node:ffi?
- ¿En qué casos node:ffi gana en rendimiento?
- ¿Qué errores detecta node:ffi y cuáles no?
- ¿Qué pasa con node:ffi y el Permission Model de Node.js?
- ¿Cómo escala node:ffi en worker threads?
- Errores comunes al adoptar node:ffi en Node.js 26.9
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Node.js 26.9.0 (16/09/2026) activa
node:ffipor defecto;--no-experimental-ffies ahora la única forma de desactivarlo. - Una llamada FFI cuesta 37.5-38.1ns contra 34.1-35.8ns de un addon N-API: 7-8% más lento, según el benchmark publicado en dev.to.
- FFI gana cuando mueve volumen: sumar 10 millones de
float64tardó 13.8-14.0ms contra 16.0-18.4ms de un for loop en JS puro. - Declarar mal el tipo de retorno no tira error: un
fib(75)devuelto comoint32en vez deint64dio 1845853122 en lugar de 2111485077978050, sin ningún aviso. - Un puntero con largo incorrecto produce
Segmentation faultdirecto, sin chequeo previo de bounds.
¿Qué cambió exactamente en Node.js 26.9 con node:ffi?
Hasta la versión 26.8.2 necesitabas correr Node con --experimental-ffi para que node:ffi existiera; desde 26.9.0 el módulo está disponible sin ningún flag, y ese mismo flag ahora no hace nada porque ya está incluido. El módulo se agregó originalmente en Node.js 26.1.0, publicado el 7 de mayo de 2026, y desde entonces vivió detrás de la bandera experimental.
La única manera de recuperar el comportamiento viejo es pasar --no-experimental-ffi, que ahora tira ERR_UNKNOWN_BUILTIN_MODULE si algo intenta importar node:ffi. Node sigue mostrando el warning ExperimentalWarning: FFI is an experimental feature and might change at any time, así que la etiqueta de “experimental” no desapareció, solo el requisito de opt-in.
Ojo con esto si tenés CI con versiones ancladas dentro del rango 26.x: cualquier script que antes fallaba silenciosamente sin el flag ahora va a ejecutar node:ffi sin que nadie lo haya pedido. Si tu pipeline nunca esperó ese módulo activo, conviene revisar qué dependencias lo importan antes de actualizar.
¿Cuánto cuesta realmente una llamada con node:ffi?
Una llamada a node:ffi cuesta entre 37.5 y 38.1 nanosegundos, contra 34.1-35.8ns de un addon N-API equivalente y apenas 2.2-3.0ns de la misma operación en JS puro, según el benchmark de cinco millones de llamadas publicado en dev.to. La prueba comparó una función add_i32(a, b) compilada como biblioteca compartida contra el mismo cálculo vía addon N-API.
| Camino de ejecución | ns por llamada |
|---|---|
| JS plano | 2.2 – 3.0 |
| Addon N-API | 34.1 – 35.8 |
| node:ffi | 37.5 – 38.1 |
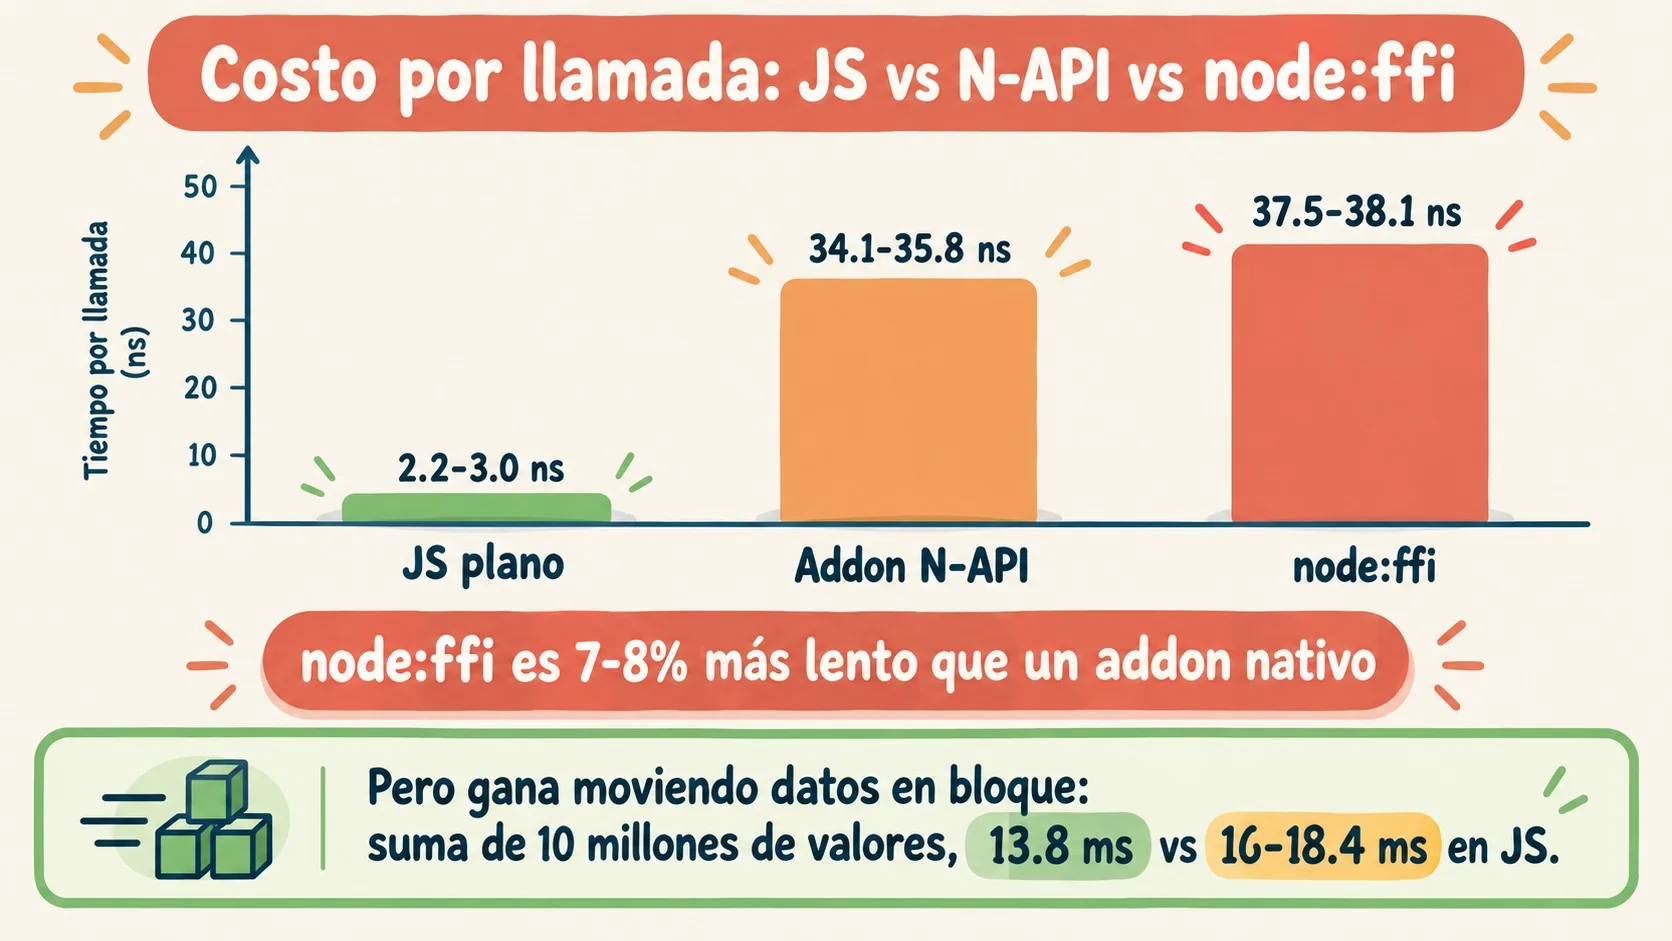
La diferencia entre FFI y N-API es 7-8%, y ambos son unas quince veces más lentos que quedarse en JS para algo tan trivial como sumar dos enteros. Ese costo extra es el precio de convertir argumentos entre JS y el mundo nativo en cada llamada, lo pagues escribiendo C o solo declarando una firma. Para más detalles técnicos, mirá gestionar fallos con circuit breakers y timeouts.
El dato que importa acá no es que FFI sea lento (37ns no es nada en sí mismo), sino que no supera a la cosa que dice reemplazar. Si ya tenés un addon nativo funcionando, node:ffi no es una mejora de rendimiento sobre eso. Lo que ofrece es comodidad: nada de node-gyp, ni compilador en la imagen de deploy, ni recompilar por cada versión de ABI de Node.
¿En qué casos node:ffi gana en rendimiento?
node:ffi gana cuando una sola llamada mueve mucho volumen de datos, no cuando hace muchas llamadas chicas. Sumando diez millones de valores float64 a través de un puntero, node:ffi tardó 13.8-14.0ms contra 16.0-18.4ms de un for loop en JS, una mejora de 15-20% porque el costo de marshalling se paga una sola vez en vez de diez millones de veces.
¿Y qué pasa con una sola llamada pesada en vez de un bucle masivo? El mismo benchmark corrió un fib(75) nativo iterativo contra la versión en JS: 0.09ms para FFI, 0.10ms para JS. Prácticamente idéntico. El JIT de V8 compila un loop simple casi tan rápido como gcc -O2, así que para un cálculo moderado y puntual, cruzar a código nativo no aporta nada.
Ponele que estás por reemplazar un cálculo que corre una vez por request con una llamada FFI porque “es nativo, tiene que ser más rápido”. Según estos números, no vas a notar diferencia, y sumaste una dependencia con un modelo de fallas distinto al de JS puro. Relacionado: armar un pipeline CI/CD con GitHub Actions.
¿Qué errores detecta node:ffi y cuáles no?
node:ffi valida el conteo de argumentos y el tipo escalar básico, pero no valida bounds de punteros ni la corrección del tipo de retorno. La documentación oficial lo describe como una API “insegura” donde una firma incorrecta puede crashear el proceso, y el benchmark de dev.to probó cuatro formas concretas de romperlo.
- Pasar un Number donde se espera BigInt uint64: tira
TypeError: Argument 1 must be a uint64. No hay coerción automática, hay que pasar explícitamente un BigInt. - Llamar con menos argumentos de los declarados: tira
TypeError: Invalid argument count: expected 2, got 1. Chequeo limpio, sin sorpresas. - Declarar mal el tipo de retorno: acá está el problema real. Un
fib(75)que devuelveint64pero se declaró comoint32devolvió 1845853122 en vez del valor correcto, 2111485077978050. Sin error, sin warning, un número mal truncado que pasa cualquier revisión de código porque nada se ve raro. - Pasar un puntero con largo incorrecto: darle a una función un buffer de 10 elementos diciéndole que tiene diez millones produjo
Segmentation fault (core dumped), salida 139. No hizo falta nada exótico, solo un largo inconsistente, justo el tipo de bug que un refactor introduce cuando cambia el tamaño del buffer pero no el call site.
La conclusión práctica: node:ffi te cubre las espaldas en errores de forma (cuántos argumentos, qué tipo escalar), pero no en errores de contenido (qué tan grande es realmente ese buffer, si el tipo de retorno declarado coincide con el real). Antes de meter esto en producción, conviene correr una prueba propia contra los tamaños de buffer reales que usa tu código, no un valor inventado, porque un largo mal contado o un input de usuario sin validar es exactamente lo que convirtió una llamada funcional en un segfault en este caso.
¿Qué pasa con node:ffi y el Permission Model de Node.js?
El Permission Model de Node.js trata a FFI como una puerta separada: correr con --permission sin habilitar explícitamente FFI tira ERR_ACCESS_DENIED con el mensaje “Use –allow-ffi to manage permissions”. Agregar --allow-ffi lo destraba, pero viene con su propio warning.
Ese warning dice, textual, [PERM0003] SecurityWarning: The flag --allow-ffi must be used with extreme caution. It could invalidate the permission model. Vale leerlo literal: activar FFI dentro de un proceso restringido por el Permission Model puede anular el resto de las restricciones que configuraste, porque el código nativo cargado no está atado a ninguna de ellas una vez que corre.
Si tu aplicación usa el Permission Model como capa de seguridad seria (por ejemplo, restringiendo acceso a filesystem o red en un entorno multi-tenant), sumar --allow-ffi no es un detalle menor. Es básicamente abrir una puerta trasera al resto del sandbox. Más contexto en elegir entre cron y systemd para tus procesos.
¿Cómo escala node:ffi en worker threads?
node:ffi escala con la cantidad de workers sin serializar llamadas por un lock global: en una prueba con fib(30) corriendo en 4 vCPUs, un worker hizo ~7.1M llamadas/s, dos workers ~16.6M llamadas/s y cuatro workers ~23M llamadas/s.
| Workers | Llamadas totales | Throughput |
|---|---|---|
| 1 | 300.000 | ~7.1M calls/s |
| 2 | 600.000 | ~16.6M calls/s |
| 4 | 1.200.000 | ~23M calls/s |
El salto de 1 a 2 workers parece más grande de lo que en realidad es, porque el número de un solo worker está deprimido por su propio costo de arranque. Aun así, la tendencia general (throughput subiendo con más workers en vez de estancarse) es lo que uno esperaría de un módulo que no comparte un lock global entre threads.
Errores comunes al adoptar node:ffi en Node.js 26.9
- Asumir que node:ffi reemplaza con ventaja a un addon N-API que ya funciona: el propio benchmark mostró que FFI es 7-8% más lento por llamada. Migrar un addon existente a FFI por “modernizar” es, según estos números, un paso hacia atrás en performance.
- Confiar en que el tipo de retorno declarado se valida: no se valida. Si declarás
int32para una función que devuelveint64, vas a tener un número silenciosamente truncado y ningún log te va a avisar. - Chequear el exit code después de pipear la salida a otro comando: el propio autor del benchmark cayó en esto: pipeó la salida a
greppara filtrar el warning experimental y después revisó$?, que terminó siendo el exit code de grep, no el de Node. El segfault real solo apareció al correr el script sin pipe. - Activar
--allow-ffisin entender el alcance: el Permission Model no protege nada una vez que código nativo arbitrario puede cargarse. El SecurityWarning lo dice explícito: puede invalidar todo el modelo de permisos.
Preguntas Frecuentes
¿Qué es node:ffi en Node.js?
node:ffi es un módulo experimental de Node.js que permite cargar bibliotecas dinámicas y llamar funciones nativas en C directamente desde JavaScript, sin escribir un addon compilado. Se agregó en Node.js 26.1.0 (mayo de 2026) y usa dlopen, dlsym y objetos de firma con tipos como int32, uint64, pointer o string.
¿node:ffi viene activado por defecto en Node.js 26.9?
Sí, desde Node.js 26.9.0 (16 de septiembre de 2026) node:ffi funciona sin necesidad de ningún flag. Antes requería --experimental-ffi; ahora ese flag no hace nada porque el módulo ya está disponible, y --no-experimental-ffi es la única forma de desactivarlo. Te puede servir nuestra cobertura de comparación de rendimiento entre Bun y Node.js.
¿node:ffi es más rápido que un addon nativo N-API?
No para llamadas individuales: un benchmark midió 37.5-38.1ns por llamada en node:ffi contra 34.1-35.8ns en un addon N-API, un 7-8% más lento. node:ffi sí resultó más rápido (15-20%) en operaciones que mueven grandes volúmenes de datos en una sola llamada, como sumar diez millones de valores float64.
¿Cómo desactivo node:ffi si no lo quiero usar?
Corré Node con el flag --no-experimental-ffi. Cualquier script que intente importar node:ffi bajo ese flag va a fallar con ERR_UNKNOWN_BUILTIN_MODULE: No such built-in module: node:ffi.
¿node:ffi puede crashear mi aplicación Node.js?
Sí. Un puntero con un largo declarado incorrecto (por ejemplo, decirle a la función que un buffer de 10 elementos tiene diez millones) produjo Segmentation fault (core dumped) en las pruebas publicadas. node:ffi valida conteo de argumentos y tipos escalares básicos, pero no valida bounds de memoria ni la corrección del tipo de retorno declarado.
Conclusión
Node.js 26.9 sacó a node:ffi del modo opt-in y lo puso corriendo por defecto, lo cual cambia el cálculo de riesgo para cualquiera con pines de versión en CI dentro del rango 26.x. El módulo no le gana en velocidad a un addon N-API para llamadas puntuales (37.5-38.1ns contra 34.1-35.8ns), así que no tiene sentido migrar código que ya funciona solo por comodidad de no compilar.
Donde sí se justifica es en operaciones que mueven volumen: cargas de buffers grandes, procesamiento numérico masivo, casos donde una sola llamada amortiza el costo de marshalling sobre millones de elementos. Fuera de eso, y dado que no valida bounds de punteros ni tipos de retorno, cualquier equipo que lo adopte necesita sus propias pruebas contra los tamaños de datos reales que va a manejar en producción, no contra un caso de ejemplo. Si trabajás con infraestructura donde corren estos servicios Node, en donweb.com tenés opciones de hosting y VPS pensadas para cargas de este tipo en Argentina.