Rotación de certificados TLS: cómo probar cada endpoint
En pocas palabras: Hay que testear cada punto de terminación TLS por separado: según un worksheet publicado el 2 de octubre de 2026 en PKI Channel, probado con NGINX 1.28.0 y OpenSSL 3.5.4, ni el exit code cero ni el archivo nuevo en disco garantizan que el endpoint sirva el certificado actualizado.
Un job de rotación de certificados TLS puede terminar con código de salida cero, guardar el archivo nuevo en disco y aun así dejar un endpoint sirviendo el certificado anterior. Según un worksheet de pruebas de aceptación publicado el 2 de octubre de 2026 en PKI Channel, cada paso es una observación independiente: medir una sola no alcanza.
La rotación de certificados TLS es el proceso de reemplazar un certificado digital vencido o por vencer en cada punto donde un servidor termina conexiones TLS: balanceador de carga, ingress controller o aplicación upstream. El objetivo no es solo renovar el certificado en sí, sino confirmar que cada endpoint entrega el certificado nuevo a un cliente real, con el nombre, la confianza y la vigencia aceptados.
En este artículo:
- En 30 segundos
- La rotación “exitosa” que no lo es: tres señales que se confunden
- Qué puntos de terminación TLS hay que probar por separado
- Las seis observaciones y qué NO prueba cada una
- Ejemplo hipotético: aplicando el worksheet a un stack con balanceador y CDN
- Cómo verificar con OpenSSL qué certificado está sirviendo realmente un endpoint
- Fallas que conviene provocar a propósito
- Qué mostró el experimento local con NGINX 1.28.0 y OpenSSL 3.5.4
- Qué queda fuera del alcance de este worksheet
- Criterios de decisión al adaptar el worksheet a infraestructura propia
- Errores comunes al validar la rotación de certificados TLS
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El 2 de octubre de 2026, un worksheet publicado en dev.to documentó que renovar un certificado TLS y recargar NGINX no garantiza que el endpoint sirva el certificado nuevo.
- La fuente probó NGINX 1.28.0 y OpenSSL 3.5.4 sobre Windows, con CA raíz, intermedia y leaf generadas localmente en loopback.
- El comando clave para verificar qué certificado entrega un servidor es
openssl s_clientcon-verify_hostnamey-verify_return_error. - El worksheet distingue seis observaciones separadas: certificado obtenido, guardado, reload solicitado, leaf recibido, verificación TLS pasada y cobertura de todos los targets.
- El experimento no cubre emisión vía ACME, reinicio del sistema operativo, alertas ni balanceadores comerciales: el alcance declarado es local.
La rotación “exitosa” que no lo es: tres señales que se confunden
Que un job de renovación termine con éxito no dice nada sobre qué certificado recibe un cliente real en el endpoint. El worksheet separa tres hechos que suelen confundirse como si fueran uno: la renovación salió bien, el archivo en disco cambió y el endpoint sigue entregando el certificado previo. Son tres observaciones distintas, y cada una puede ser verdadera de forma independiente de las otras dos.
Certbot documenta los hooks de renovación por separado de la renovación misma. NGINX, por su lado, describe la aplicación de cambios de configuración como un proceso que puede fallar y conservar la configuración vieja (algo que cualquiera que haya tocado un nginx -s reload a las dos de la mañana conoce bien).
¿Por qué importa la diferencia? Porque si tratás la renovación como la única señal de éxito, un error de reload queda invisible hasta que alguien nota el certificado vencido sirviendo en producción, y para ese momento ya es un incidente, no una prueba de aceptación. La regla práctica que se desprende de esto: ninguna de las tres señales reemplaza a las otras dos; si solo tenés una, tu rotación está sin verificar, no confirmada. Relacionado: cómo armamos la PKI paso a paso.
Qué puntos de terminación TLS hay que probar por separado
Un balanceador de carga público, un ingress controller y una aplicación upstream pueden sostener certificados distintos para el mismo hostname, así que cada uno necesita su propia prueba de aceptación. Antes de tocar nada hay que fijar tres cosas: el hostname, el leaf esperado y la trust policy del cliente que vas a usar para verificar.
- Hostname objetivo: el nombre que el cliente pide vía SNI al conectar.
- Leaf esperado: el fingerprint SHA-256 del certificado que debería responder ese endpoint después de la rotación.
- Trust policy del cliente: qué cadena de confianza y qué política de aceptación de revocación aplica el cliente real que vas a simular.
El worksheet también pide registrar IPv4 e IPv6 por separado cuando ambos están en uso. Si un servicio de edge administrado no expone una forma estable de seleccionar cada nodo, hay que anotar el método de muestreo y esa limitación. Una sola conexión exitosa no es evidencia de que todos los nodos del edge estén actualizados: es evidencia de que ese nodo, en ese momento, respondió lo esperado. Nada más.
Las seis observaciones y qué NO prueba cada una
Lo que distingue a este worksheet de un checklist genérico es que cada fila incluye explícitamente el límite de lo que esa observación demuestra. Eso es lo útil: no alcanza con anotar “reload OK”, hay que anotar también qué pregunta ese dato no responde.
| Observación | Evidencia a guardar | Qué NO prueba |
|---|---|---|
| Certificado nuevo obtenido | Identidad, validez y resultado de emisión | Que se haya desplegado al servidor |
| Certificado nuevo guardado | Versión del archivo o secreto y referencia configurada | Que el proceso en ejecución lo haya cargado |
| Reload solicitado | Chequeo de configuración, código de salida, log del servicio | Qué leaf recibe un cliente nuevo |
| Leaf esperado recibido | Endpoint, SNI, timestamp, fingerprint SHA-256 | Aceptación de nombre, confianza o revocación |
| Verificación TLS pasada | Nombre esperado, configuración de confianza, hora, resultado | Aceptación bajo cualquier política de browser o dispositivo |
| Todos los targets observados | Una fila por cada target definido | Cobertura de targets no especificados o inalcanzables |
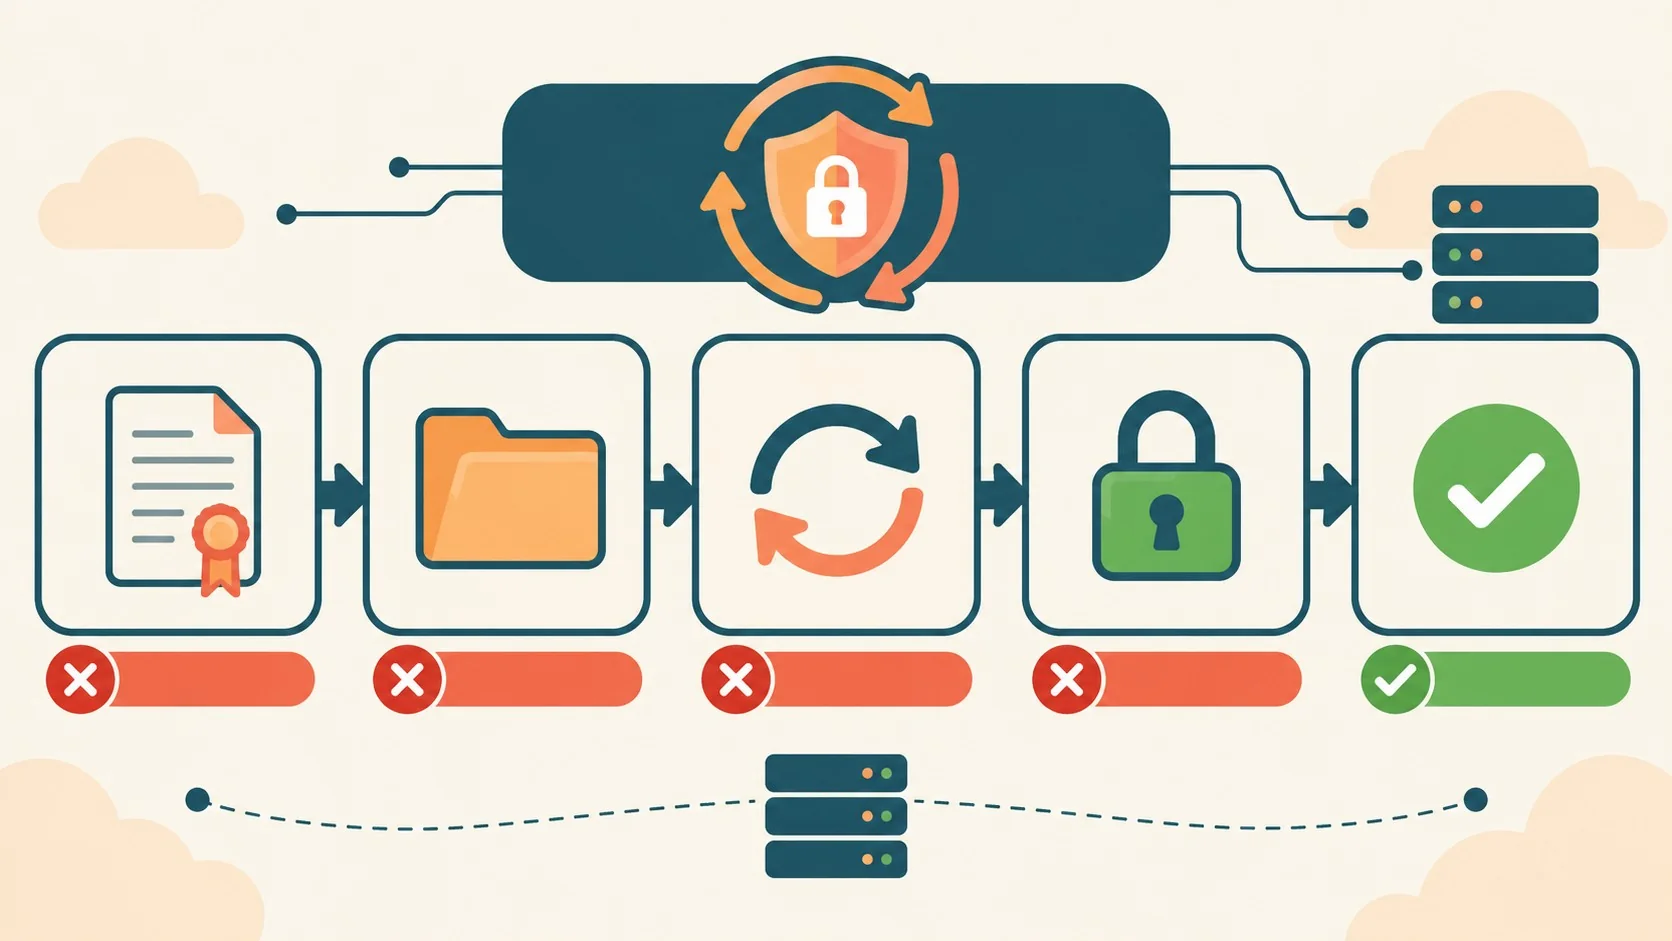
Criterio de decisión: si en tu checklist de rotación solo podés tildar las primeras tres filas (obtenido, guardado, reload solicitado), todavía no tenés evidencia de que un cliente real vea el certificado nuevo. Las tres últimas filas son las que determinan si la rotación está cerrada o solo “en curso”.
Ejemplo hipotético: aplicando el worksheet a un stack con balanceador y CDN
Nota: el siguiente escenario es hipotético y sirve para ilustrar cómo se usarían las columnas del worksheet. No corresponde a datos medidos ni a la prueba local descrita más abajo, que sí es la que reportó la fuente.
Supongamos un hostname api.ejemplo.com que termina TLS en tres lugares: un balanceador de carga administrado por un proveedor cloud, un ingress de Kubernetes detrás de ese balanceador, y una app upstream que también valida TLS internamente. Si el equipo renueva el certificado y solo verifica contra el balanceador, puede completar las filas “obtenido”, “guardado” y “leaf recibido” con un resultado correcto — y aun así dejar el ingress sirviendo el certificado viejo, porque ese reload falló silenciosamente en un pod que no se reinició.
Aplicando el worksheet, la fila “todos los targets observados” obligaría a registrar una entrada separada para el ingress, no solo para el balanceador. Si el proveedor del balanceador no permite elegir un nodo específico para el probe (solo resuelve DNS a “algún” nodo del pool), el criterio del worksheet pide anotar esa limitación como coverage_limit en lugar de asumir que el muestreo cubrió todo el pool. La decisión operativa en ese caso hipotético no sería “repetir la emisión del certificado” (el certificado es correcto), sino investigar por qué el ingress no cargó la versión nueva — exactamente la distinción que señala el worksheet entre fallo de emisión y fallo de carga.
Cómo verificar con OpenSSL qué certificado está sirviendo realmente un endpoint
El comando openssl s_client con -servername, -verify_hostname y -verify_return_error te dice si la verificación de nombre y confianza pasa contra un CAfile específico, además de mostrarte el certificado que el servidor envía realmente. El ejemplo de la fuente usa OpenSSL 3.x y un timeout de GNU coreutils. Lo explicamos a fondo en la revocación vía CRL y OCSP.
HOST='service.example.test'
ADDRESS='192.0.2.10:443'

timeout 12s openssl s_client \
 -connect "$ADDRESS" \
 -servername "$HOST" \
 -verify_hostname "$HOST" -verify_return_error \
 -no-CApath -no-CAstore -CAfile trusted-root.pem \
 -showcerts
Ojo con un detalle que se presta a confusión: SNI pide un nombre de servidor, pero no verifica por sí mismo la identidad del certificado. -showcerts muestra los certificados que el servidor manda, no una cadena ya verificada. Por eso hay que guardar el resultado de verificación junto con el leaf recibido, no uno solo de los dos: si solo guardás el fingerprint, no sabés si ese fingerprint además pasó la verificación de nombre y confianza.
Fallas que conviene provocar a propósito
El worksheet propone probar fallas deliberadas para confirmar que el proceso de verificación las detecta antes de que lo haga un cliente real. La lógica detrás de esto es simple: si nunca forzaste el escenario de falla, no sabés si tu proceso de verificación lo detectaría o lo dejaría pasar.
| Falla probada | Evidencia requerida | Respuesta operativa aceptable |
|---|---|---|
| Disco cambia pero el proceso sigue sirviendo el leaf viejo | Fingerprints guardado y servido distintos | Identificar el paso de carga o despliegue que falló |
| Validación de configuración falla | Resultado de chequeo distinto de cero y diagnóstico | Mantener la configuración conocida y corregir el error |
| Un endpoint queda desactualizado | Observaciones específicas de ese endpoint | Reparar ese target puntual, no pedir otro certificado por default |
| SNI incorrecto selecciona un server default | Leaf recibido comparado con el nombre pedido | Corregir el probe o la configuración del virtual host |
| Target inalcanzable | Falla de conexión y alcance de la observación | Marcar cobertura incompleta, no comparar contra un fingerprint vacío |
| Certificado coincide pero falla la verificación | Identidad correcta más resultado fallido de nombre, confianza o tiempo | Investigar la condición de verificación que falló |
La fuente marca algo que suele pasarse por alto: probar que una alerta se dispara en un log no prueba que la persona responsable la recibió. Notificación y escalamiento se prueban aparte, con su propio criterio de aceptación — no alcanza con "el log tiene la línea", hay que confirmar que alguien la vio y actuó.
Qué mostró el experimento local con NGINX 1.28.0 y OpenSSL 3.5.4
El 2 de octubre de 2026, el equipo de PKI Channel corrió el worksheet sobre Windows con NGINX 1.28.0 y OpenSSL 3.5.4, usando una CA raíz, intermedia y leaf generadas localmente, todo sobre loopback. Reemplazar el certificado en disco dejó el leaf viejo activo en las conexiones nuevas hasta que corrigieron la configuración y recargaron el servicio. Para más detalles técnicos, mirá terminar TLS en el edge sin Cloudflare.
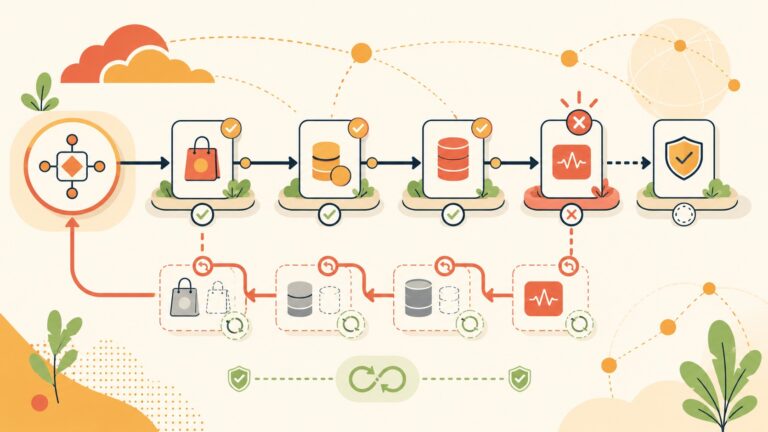
Lo interesante es la secuencia completa: reemplazaron el certificado en disco, el proceso siguió sirviendo el leaf viejo, una configuración apuntando a un certificado faltante falló la validación, el comando de reload corregido devolvió código cero y solo después de eso las conexiones con verificación estricta recibieron el fingerprint nuevo. La verificación final hizo falta incluso con el reload ya exitoso — ese es, en definitiva, el punto central de todo el worksheet: ningún paso intermedio reemplaza a la observación en el endpoint.
Para un caso de laboratorio más extenso, PKI Channel tiene publicado un lab de NGINX y ACME con comandos y resultados registrados, en japonés y con CA de prueba local.
Qué queda fuera del alcance de este worksheet
El experimento de PKI Channel no emite certificados vía ACME, no prueba privilegios de un entorno productivo, no reinicia el sistema operativo, no envía alertas y no ejercita un balanceador de carga comercial. El alcance declarado es cargar y observar un certificado TLS local.
Eso delimita bastante lo que se puede concluir: el método funciona como criterio de verificación para el paso de carga y observación, pero extenderlo a un edge productivo con CDN o balanceador comercial requiere validar la cobertura de muestreo contra cada nodo, algo que la fuente marca explícitamente como pendiente y que el ejemplo hipotético de arriba intenta ilustrar.
Criterios de decisión al adaptar el worksheet a infraestructura propia
Más allá de copiar la tabla de la fuente, conviene fijar de antemano en qué condición una rotación se considera cerrada. Tres criterios concretos que se desprenden del worksheet:
- Si tenés fila "leaf recibido" pero no "verificación TLS pasada": el certificado correcto puede estar llegando, pero todavía no sabés si un cliente real lo aceptaría. No des la rotación por cerrada.
- Si un target no tiene owner asignado para su seguimiento: tratalo como cobertura incompleta, no como aprobado por omisión. El worksheet es explícito en que un target sin observar necesita una decisión, no un silencio.
- Si tu proveedor de edge solo permite muestreo y no selección de nodo: documentá el método de muestreo como limitación conocida en vez de reportar la rotación como 100% verificada.
Si tu stack corre detrás de un balanceador administrado por tu proveedor de hosting, el primer punto a confirmar con ese criterio es si te deja seleccionar cada nodo del edge para el probe, o si solo podés muestrear. En infraestructura propia, el mismo worksheet aplica directo: definís el hostname, el leaf esperado y corrés el probe de OpenSSL contra cada punto de terminación antes de dar por cerrada la rotación. Complementá con alertas de certificados en tu stack Docker.
Errores comunes al validar la rotación de certificados TLS
- Confiar en el código de salida del job de renovación como prueba final. Certbot y herramientas similares pueden devolver éxito sin que el servicio haya recargado la configuración nueva.
- Probar un solo endpoint y asumir que el resto del edge está igual. Un balanceador, un ingress y una app upstream pueden tener certificados distintos para el mismo hostname.
- Usar
-showcertssin revisar el resultado de verificación. Esa opción muestra lo que el servidor envía, no una cadena ya validada contra tu trust policy. - Pedir un certificado nuevo cuando el problema es de carga o reload. Si el endpoint sirve el leaf viejo con el archivo correcto en disco, el error está en el paso de despliegue, no en la emisión.
Preguntas Frecuentes
¿Por qué un servidor sigue mostrando el certificado SSL anterior después de renovarlo?
Porque el job de renovación y la carga del certificado por el proceso en ejecución son dos pasos distintos. El archivo en disco puede estar actualizado mientras el proceso de NGINX u otro servidor sigue sirviendo el certificado viejo hasta que se ejecuta un reload exitoso.
¿Cómo se prueba que la rotación de certificados TLS funcionó en todos los endpoints?
Se prueba conectándose a cada endpoint por separado con un cliente que verifique nombre, confianza y vigencia, y registrando el fingerprint SHA-256 recibido contra el esperado. Un único endpoint verificado no es evidencia de que el resto del edge esté actualizado.
¿Qué comando de OpenSSL sirve para verificar qué certificado está sirviendo un servidor?
-->openssl s_client con las opciones -servername, -verify_hostname y -verify_return_error contra un -CAfile específico. Esto muestra el certificado que el servidor envía y confirma si pasa la verificación de nombre y confianza.
¿Certbot renueva el certificado pero no reinicia NGINX, qué hago?
Revisá si configuraste un renewal hook que ejecute el reload de NGINX, porque Certbot documenta esos hooks como un paso separado de la renovación misma. Sin ese hook, el certificado en disco cambia pero el proceso sigue sirviendo el anterior hasta un reload manual.
¿Cómo diferenciar un fallo de renovación de un fallo de recarga de configuración?
Un fallo de renovación se ve en el log del cliente ACME, con un código de salida distinto de cero en esa herramienta. Un fallo de recarga se ve en el chequeo de configuración de NGINX o en el código de salida del comando de reload, aunque la renovación haya terminado bien.
Conclusión
El worksheet publicado por PKI Channel el 2 de octubre de 2026 no inventa un estándar nuevo de ACME ni de TLS. Lo que hace es nombrar algo que muchos equipos tratan como un solo evento y que en realidad son seis observaciones separadas, desde la emisión hasta la verificación final en cada endpoint. La rotación de certificados TLS queda completa para el alcance que probaste cuando el leaf esperado llega, la verificación del cliente pasa y cada target sin observar tiene un responsable y una decisión de seguimiento explícita. Lo que no permite concluir el experimento local de la fuente es cómo se comporta un balanceador comercial o un CDN con múltiples nodos de edge —el ejemplo hipotético de más arriba apunta justamente a esa brecha— y queda como tarea pendiente para quien lo adapte a un entorno productivo.