Tessera: así se diagnostican incidentes en Kubernetes
En pocas palabras: Tessera, app de escritorio open source (Apache 2.0) construida con Tauri 2 y Rust, diagnostica el hop roto trazando la ruta Entry point → Service → Workload → Pods → Nodes, marca con líneas rojas el punto de falla y entrega evidencia verificable con comandos kubectl de solo lectura en 12 categorías de fallos.
Un error 503 aparece en producción y nadie sabe si el problema está en el ingress, en el Service, en los pods o en el nodo que los aloja. Tessera es una app de escritorio gratuita y de código abierto que automatiza el diagnóstico de incidentes en Kubernetes: traza cada petición desde el punto de entrada hasta el nodo, marca el salto exacto donde se corta y entrega evidencia verificable con comandos kubectl de solo lectura, según describe el artículo publicado en Dev.to por su autora.
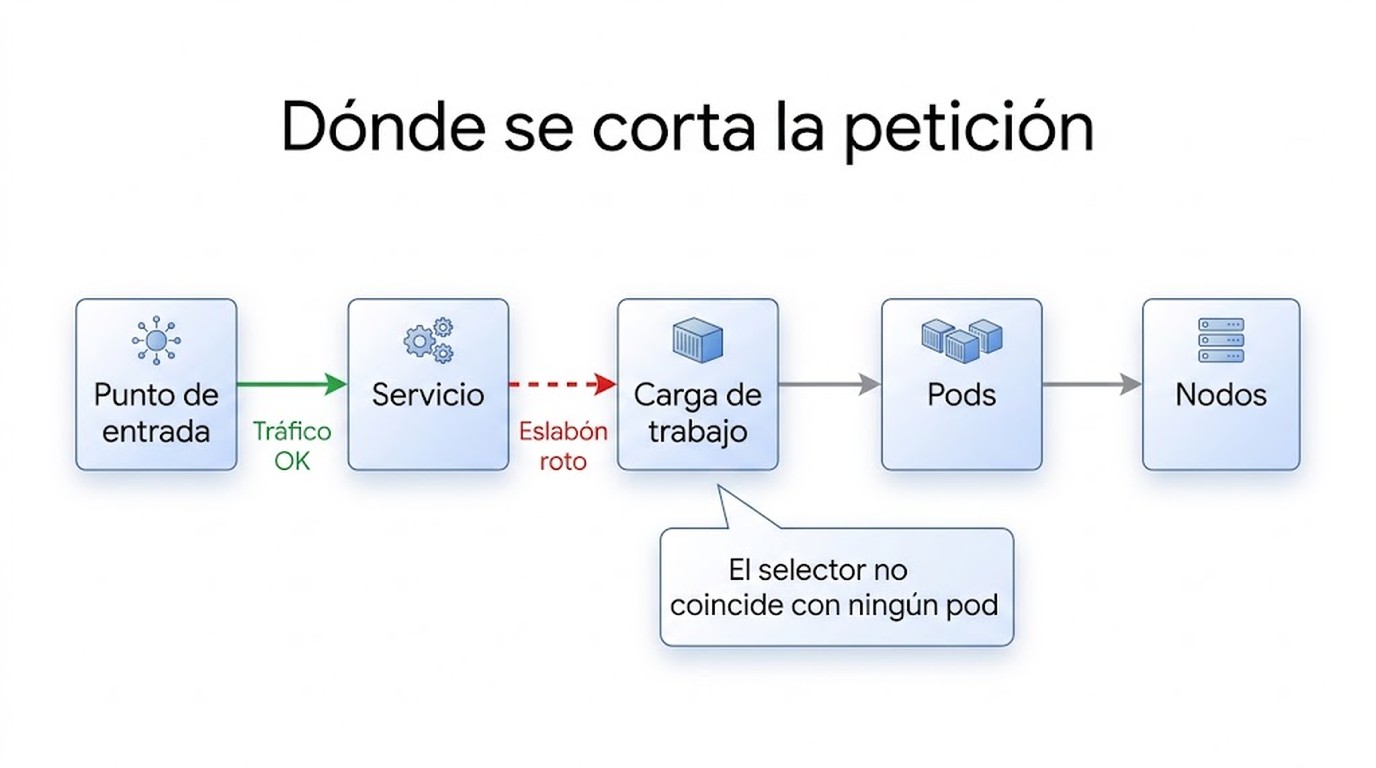
Tessera es una herramienta open source construida con Tauri 2 y Rust que organiza el diagnóstico por ruta de petición en vez de por lista de recursos. Sigue la cadena Entry point → Service → Workload → Pods → Nodes, dibuja un mapa de tráfico y señala con líneas rojas punteadas el hop que falla, con la causa raíz marcada de forma explícita.
En este artículo:
- En síntesis
- ¿Por qué es tan difícil saber qué falla en un incidente de Kubernetes?
- ¿Cómo funciona el diagnóstico de incidentes en Kubernetes que hace Tessera?
- ¿Qué tipos de fallos puede detectar la herramienta?
- ¿Es segura para usar en clusters de producción y con múltiples cuentas?
- ¿Cómo probar Tessera en un cluster local?
- Qué significa para empresas y equipos en Latinoamérica
- Errores comunes al diagnosticar incidentes en Kubernetes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En síntesis
- Tessera cubre 12 categorías de fallos (routing, DNS, network policy, service mesh, imágenes, admission, storage, scheduling, quota, autoscaling, crashes/probes y nodos).
- Al momento de la publicación original en Dev.to, la versión disponible era la 0.2, en estado pre-release, con instaladores sin firmar para macOS, Windows y Linux.
- Los pods de prueba para tests de red corren sin root, sin token de service account, y se autodestruyen a los 90 segundos.
- Es un proyecto Apache 2.0 desarrollado por Manvitha Potluri, disponible en el repositorio de GitHub.
- En clusters marcados como producción, los tests de red activos están apagados por defecto y exigen escribir el nombre exacto del cluster para confirmarlos.
¿Por qué es tan difícil saber qué falla en un incidente de Kubernetes?
Porque una petición HTTP atraviesa cinco capas independientes antes de llegar al código de la aplicación: el ingress o load balancer cloud, el Service, el Workload dueño de los pods, los pods mismos y los nodos que los alojan. Cada capa tiene su propio estado y su propia forma de fallar. Cuando un usuario ve un error 503, cualquiera de esas capas puede ser la responsable.
La respuesta típica es una secuencia de comandos: kubectl get ingress, describe svc, get endpoints, get pods, describe pod, logs --previous, describe node. Funciona. Pero es lenta, depende mucho de la experiencia de quien la corre, y falla justo bajo presión, que es exactamente cuando más importa. Complementá con los errores de configuración YAML en Kubernetes.
Ponele que estás de guardia un sábado a la madrugada, el dashboard se llena de 503, corrés los siete comandos de siempre, armás mentalmente la explicación de cómo se conectan ingress, Service y pods, y recién ahí te das cuenta de que el selector del Service cambió por un deploy mal hecho hace tres horas. Eso, ese armado mental bajo presión, es el problema que Tessera intenta resolver con reglas en vez de intuición.
¿Cómo funciona el diagnóstico de incidentes en Kubernetes que hace Tessera?
Tessera organiza el diagnóstico por ruta de petición, no por tipo de recurso: arma la cadena Entry point → Service → Workload → Pods → Nodes para cada servicio del cluster y evalúa cada eslabón por separado. El resultado se muestra en un mapa de tráfico donde las rutas sanas tienen indicadores de tráfico en vivo y los saltos rotos aparecen como líneas rojas punteadas.
La frase “which hop is broken” (¿qué salto está roto?) es literal: cada “hop” es una capa que la petición tiene que cruzar, y la herramienta señala cuál de esas capas corta el tráfico. Un Service cuyo selector no matchea ningún pod aparece, según el artículo de Dev.to, “conectado a nada” en el mapa.
Cada hallazgo tiene que cumplir tres condiciones:
- Específico: nombra el objeto exacto, el valor problemático y el arreglo sugerido, no un mensaje genérico de “hay un error”.
- Verificable: incluye los comandos kubectl de solo lectura que permiten confirmar el hallazgo de forma independiente, porque la herramienta nunca es la única fuente de verdad.
- Causal: agrupa los fallos de pods por workload y baja de prioridad los síntomas cuando una causa anterior ya los explica, para que el primer ítem de la lista sea el que hay que arreglar.
¿Qué tipos de fallos puede detectar la herramienta?
Tessera cubre doce categorías de diagnóstico: routing, network policy, DNS, service mesh, imágenes, configuración y admission, storage, scheduling, quota, autoscaling, crashes y probes, y nodos con redes de pod. Las reglas son conservadoras a propósito: si los datos disponibles no alcanzan para probar un problema, la herramienta no reporta nada en vez de arriesgar un diagnóstico incorrecto. Sobre eso hablamos en generar NetworkPolicies a partir de flujos de Hubble.
| Fallo introducido | Diagnóstico de Tessera |
|---|---|
| Selector del Service cambiado a app=wrong | El Service web selecciona app=wrong, que no matchea ningún pod; los pods están etiquetados app=web. Sugiere el arreglo exacto. |
| CPU request de 64 cores | El deployment pide 64 CPUs y el nodo más grande ofrece 12. Lo identifica como “ningún nodo alcanza”, distinto de “el cluster está lleno”. |
| Límite de memoria de 20Mi en un proceso que crece | El contenedor fue matado por exceder el límite. Lo distingue de un crash loop genérico y sugiere un nuevo valor. |
| Tag de imagen inexistente | El deployment no puede bajar la imagen porque el tag no existe, diferenciándolo de una falla de autenticación del registro. |
Además de los checks dentro del cluster, Tessera tiene dos capacidades opcionales que atacan fallas invisibles desde adentro. La primera consulta a AWS el estado de los targets del load balancer y explica, por ejemplo, cuando el health check pega contra / y recibe un 404 mientras el readiness probe del workload usa /ready. La segunda corre pods de prueba efímeros, uno en el nodo del pod objetivo y otro en un nodo distinto, para comparar resolución DNS, IP del Service e IPs de pods y así aislar si el problema es de kube-proxy, de CNI entre nodos, de una NetworkPolicy o de una app que directamente no está escuchando en el puerto.
¿Es segura para usar en clusters de producción y con múltiples cuentas?
Sí, según el diseño descripto por su creadora, Tessera es de solo lectura por defecto y separa cada cluster de forma completa, tanto en credenciales como en configuración. Eso no significa que no haya que tener cuidado: significa que el diseño está pensado para minimizar el riesgo de tocar el cluster equivocado, que es justamente el error más caro cuando una organización maneja varias cuentas y regiones.
- Solo lectura por defecto: únicamente corre get, list y logs; hay un rol RBAC mínimo de solo lectura provisto en el repositorio.
- Aprobación explícita: antes de crear cualquier pod de prueba, muestra el manifiesto exacto y no ejecuta nada sin confirmación del usuario.
- Pods de prueba acotados: corren sin root, sin token de service account, sin capabilities de Linux y con filesystem de solo lectura; se apagan a los 90 segundos y siempre se borran.
- Protección de producción: los clusters de producción se detectan por nombre, se marcan con un banner rojo y los tests activos están apagados salvo que se escriba el nombre exacto del cluster para confirmarlos.
- Aislamiento por cluster: cada contexto usa su propia identidad de kubeconfig, su propio perfil de AWS y su propia región, según explica la guía de multi-ambiente del proyecto.
- Política organizacional: un archivo de políticas opcional puede desactivar funciones, restringir qué clusters aparecen y definir qué cuenta como producción, con un archivo de sistema que tiene prioridad y falla en modo seguro si no se puede leer.
Para chequeos en la nube, Tessera usa solo cinco operaciones de solo lectura sobre AWS (describe de load balancers, target groups, target health e instance health), reforzadas en el código mismo. No guarda credenciales ni manda telemetría. Cada test de red, cada pod creado y borrado, y cada intento bloqueado queda registrado en un log de actividad local. Ya lo cubrimos antes en la demo Online Boutique de Google para probar escenarios.
¿Cómo probar Tessera en un cluster local?
Al momento de la publicación original en Dev.to, Tessera estaba en versión 0.2, pre-release, con la lógica de diagnóstico cubierta por tests automatizados y validada contra un cluster real. Los instaladores para macOS (Apple Silicon e Intel), Windows y Linux todavía no estaban firmados, así que en macOS hacía falta correr un comando de xattr una vez para poder abrir la app.
La forma más rápida de verlo funcionar es armar un cluster local con kind, romper algo a propósito y abrir Tessera para ver el diagnóstico:
- Creá el cluster:
kind create cluster --name tessera-lab - Desplegá un deployment de prueba:
kubectl create deployment web --image=nginx --port=80 - Exponelo como Service:
kubectl expose deployment web --port=80 - Rompé el selector a propósito:
kubectl patch service web -p '{"spec":{"selector":{"app":"wrong"}' - Abrí Tessera y seleccioná el contexto
kind-tessera-labpara ver el diagnóstico completo.
El proyecto está bajo licencia Apache 2.0 y acepta reportes de bugs, patrones de fallas nuevos y contribuciones de código, sobre todo para soporte de Azure y rutas de Gateway API, que son parte del roadmap junto con actualizaciones en vivo basadas en watch en vez de polling. Relacionado: los distintos patrones de arquitectura en Kubernetes.
Qué significa para empresas y equipos en Latinoamérica
Si tu equipo maneja varios clusters EKS en distintas cuentas de AWS, algo bastante común en empresas de la región que arrancaron con un cluster de dev y terminaron manejando varios entre staging y producción, el aislamiento por perfil y región que ofrece Tessera resuelve un dolor real: evitar que alguien corra un test de red en el cluster de producción pensando que estaba en el de staging. Ahora bien, si tu infraestructura combina Kubernetes con servicios que no viven en el cluster (bases de datos administradas, sitios estáticos, correo transaccional), plataformas de hosting como donweb.com siguen siendo parte de la ecuación para esos componentes que Tessera no llega a ver.
Errores comunes al diagnosticar incidentes en Kubernetes
- Confiar el diagnóstico sin verificarlo: Tessera da los comandos kubectl para confirmar cada hallazgo, y saltearse ese paso anula justamente la parte más valiosa del diseño.
- Dar permisos RBAC amplios de entrada: la herramienta solo necesita get, list y logs para el uso diario; los permisos de crear y borrar pods para tests de red conviene limitarlos a namespaces específicos y, si se puede, a clusters que no sean de producción.
- Asumir que “sin hallazgos” significa “sin problemas”: las reglas son conservadoras y prefieren no reportar antes que arriesgar un falso positivo, así que la ausencia de un hallazgo no cierra el caso por sí sola.
- Ignorar el archivo de política organizacional: sin uno configurado, cualquier persona con acceso al cluster puede intentar habilitar tests activos en producción; el archivo de sistema tiene prioridad justamente para evitar eso.
Preguntas Frecuentes
¿Qué es Tessera y para qué sirve en Kubernetes?
Tessera es una app de escritorio open source que traza el camino de una petición dentro de un cluster de Kubernetes (ingress, Service, Workload, Pods y Nodes) y marca el salto exacto donde se corta el tráfico. Sirve para acortar el tiempo de diagnóstico durante un incidente sin reemplazar el criterio del ingeniero, porque cada hallazgo viene con el comando kubectl para confirmarlo.
¿Cómo saber qué componente de Kubernetes está fallando cuando hay un error 503?
Un 503 puede originarse en el ingress, en el Service, en los pods o en el nodo que los aloja, y la única forma de saberlo con certeza es revisar cada capa por separado. Tessera automatiza esa revisión armando la cadena completa y marcando en rojo el eslabón que corta la conexión, en vez de dejar que el ingeniero arme la explicación a mano con siete comandos distintos.
¿Qué diferencia hay entre usar kubectl manualmente y una herramienta de diagnóstico automatizada?
Con kubectl manual, el ingeniero corre comandos como get ingress, describe svc o describe pod y arma la explicación en su cabeza, algo lento y sensible al error bajo presión. Una herramienta como Tessera aplica esa misma lógica de forma sistemática sobre un snapshot del cluster, pero sigue dando los comandos kubectl de solo lectura para que el resultado se pueda verificar de forma independiente.
¿Es seguro correr una herramienta de diagnóstico en un cluster de producción?
Según el diseño descripto por Tessera, sí, siempre que se respeten los guardrails: acceso de solo lectura por defecto, tests de red desactivados en producción salvo confirmación explícita escribiendo el nombre del cluster, y pods de prueba sin privilegios que se autodestruyen a los 90 segundos. Cada acción queda registrada en un log de actividad local para poder auditarla después.
¿Cómo se instala y se prueba Tessera en un cluster local?
Se descarga el instalador correspondiente (dmg para macOS, exe o msi para Windows, AppImage/deb/rpm para Linux) desde la página de releases del repositorio en GitHub. Para probarlo rápido, se crea un cluster con kind, se despliega un deployment de nginx, se rompe a propósito el selector del Service con kubectl patch, y se abre Tessera para ver el diagnóstico sobre ese fallo introducido.
Conclusión
Tessera no inventa magia nueva: toma la misma secuencia de comandos que cualquier ingeniero de plataforma ya conoce de memoria y la convierte en reglas verificables, con evidencia adjunta y guardrails pensados para no romper nada en el intento. Lo que cambia es la velocidad para llegar a la capa correcta durante un incidente, sobre todo cuando la falla es rara (un selector cambiado, una imagen con tag inexistente, un límite de memoria mal calculado) y no algo que salta a la vista en el primer kubectl get pods.
Antes de sumarla a un flujo de guardia real, tiene sentido correrla primero contra un cluster de kind con fallas introducidas a propósito, revisar que los comandos de verificación que sugiere efectivamente confirmen cada hallazgo, y recién después evaluar el archivo de política organizacional para producción. Es software en pre-release: útil, pero todavía en construcción, y tratarlo como tal es la forma más sensata de adoptarlo.