Typesense para ecommerce: búsqueda por intención
En pocas palabras: Según la guía de Satyam Mishra, Typesense, motor open source con licencia GPL-3.0, entiende lo que busca el cliente combinando palabras y significado en una sola consulta: por defecto pesa 70% el ranking por palabras y 30% el semántico. Se completa con claves de solo búsqueda, timeout y fallback.
Con Typesense para ecommerce podés armar un buscador que entienda lo que el cliente quiere, combinando palabras y significado. Satyam Mishra, desarrollador de software, publicó el 10 de octubre de 2026 una guía con su caso en Frido. Las piezas técnicas coinciden con la documentación v30.2 de Typesense.
Typesense es un motor de búsqueda open source, escrito en C++, que guarda su índice en memoria y busca con tolerancia a errores de tipeo. Sirve para armar buscadores de productos y catálogos. Apunta a equipos que quieren un buscador rápido de armar y de operar. Tiene licencia GPL-3.0, corre como un único binario y también existe como servicio gestionado, Typesense Cloud.
En este artículo:
- En 30 segundos
- ¿Por qué el buscador de mi tienda online no entiende lo que escribe el cliente?
- ¿Cómo funciona la búsqueda híbrida de Typesense (palabras + significado)?
- ¿Typesense es gratis? Open source vs buscadores SaaS cerrados
- ¿Cómo armar la búsqueda de productos con Typesense para ecommerce paso a paso?
- ¿Qué medidas de seguridad y respaldo necesita un buscador con Typesense?
- ¿Qué cambia para una tienda que vende en español?
- ¿Qué está confirmado y qué falta verificar?
- Errores comunes al implementar la búsqueda
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El 56% de los sitios no soporta bien lo que los usuarios buscan, según el benchmark 2026 de Baymard Institute que cita la guía de Mishra.
- La búsqueda híbrida de Typesense combina palabras y significado en una sola consulta; el reparto 70/30 por defecto sale del artículo y hay que confirmarlo en la doc v30.2.
- El motor es gratis (GPL-3.0); Typesense Cloud se factura por hora según el tamaño del cluster, sin cargo por búsqueda ni por registro.
- Antes de salir a producción hacen falta claves de solo búsqueda, timeout duro y un fallback a búsqueda simple.
¿Por qué el buscador de mi tienda online no entiende lo que escribe el cliente?
Un buscador por palabras solo encuentra texto que ya está en tu catálogo. Según el benchmark 2026 de Baymard Institute (más de 170 sitios y apps), que Mishra cita en su guía, el 56% de los sitios no soporta de forma adecuada lo que los usuarios buscan. Cerca de la mitad de los compradores prefiere buscar antes que usar el menú.
Ponele que vendés sillas ergonómicas y alguien escribe “back pain”. Ninguna ficha dice eso. Pantalla vacía. (Ejemplo hipotético nuestro, no un caso medido.)
El problema también corre al revés. “Footwear” no aparece en el título de una plantilla, y está bien, porque quien busca zapatillas no quiere plantillas. Un buen buscador tiene que entender qué significa una consulta y qué no. Baymard separa las búsquedas en ocho tipos de consulta, y según la guía la falla se concentra cuando el comprador deja de escribir nombres de producto y empieza a describir su problema o su uso. Esto se conecta con lo que analizamos en desplegar un frontend React con Vite.
¿Cómo funciona la búsqueda híbrida de Typesense (palabras + significado)?
La búsqueda híbrida de Typesense corre en una sola consulta una búsqueda por palabras y otra semántica (por significado), y fusiona los dos rankings. Vos decidís cuánto peso tiene cada lado y a qué distancia se descartan los resultados flojos. Según la documentación v30.2, el propio Typesense puede generar los embeddings al indexar y cuando llega la consulta.
- Motor en C++ con índice en memoria. El README del proyecto apunta a búsquedas de menos de 50 ms.
- Tolerancia a typos. Hasta dos errores por palabra y coincidencia por prefijo, así que “insloe” igual encuentra plantillas.
- Sinónimos y curación. Declarás equivalencias propias y fijás productos arriba para una consulta puntual.
- Embeddings propios. Con modelos incluidos como all-MiniLM-L12-v2 no necesitás un servicio de machine learning aparte; la doc aclara que Typesense lo descarga solo al crear la colección.
- Búsqueda en lenguaje natural con LLM. Desde la v29 convierte “un Honda o BMW con al menos 200 hp” en filtros y orden. Tiene riesgos, que van más abajo.
Ahora bien, hay dos ajustes que mandan. El primero es cuánto confiar en el significado frente a las palabras. Mishra dice que la fusión por defecto da 70% al ranking por palabras y 30% al semántico, y para tiendas donde la gente busca por nombre de producto recomienda dejar a las palabras al mando. Ojo: ese 70/30 sale del artículo. El índice de la doc v30.2 tiene una sección sobre el peso, pero el fragmento que revisamos no trae el valor, así que verificalo antes de apoyarte en él.
El segundo es el umbral de distancia. Demasiado laxo y buscar “silla” te muestra almohadones. Demasiado estricto y “back pain” no encuentra nada. No hay valor universal (spoiler: depende de tu catálogo).
Los embeddings tienen costo. Mishra midió unos 0,1 segundos para embeber una consulta nueva, contra unos pocos milisegundos de una búsqueda por keyword; es medición del autor, sin verificación independiente. La doc avisa además que los modelos incluidos son pesados de correr y que una GPU es opcional para acelerar la generación de embeddings.
¿Typesense es gratis? Open source vs buscadores SaaS cerrados
El motor es gratis: tiene licencia GPL-3.0 y se autoaloja como un único binario sin dependencias de runtime, según el repositorio oficial. Si preferís no operarlo, Typesense Cloud es la opción paga y gestionada. Mishra explica que se factura por hora según el tamaño del cluster, sin cargos por búsqueda ni por registro.
| Pregunta | Open source (Typesense) | SaaS de búsqueda cerrado (según el autor) |
|---|---|---|
| ¿Qué pagás? | Tu propio servidor, o Typesense Cloud por hora según el tamaño del cluster | Muchas veces por búsqueda y por registro: el costo crece con tráfico y catálogo |
| ¿Un orden nuevo (precio, rating)? | El campo de orden se elige al consultar, sobre un solo índice | Algunos proveedores piden un índice duplicado por orden, con registros facturables extra |
| ¿Podés irte? | Sí: el mismo motor en tu servidor o en el de ellos, y podés leer el código | Tu lógica de ranking vive en el panel de otro |
| ¿Dónde viven los datos? | Donde elijas, lo que ayuda con normativas europeas | Donde los corra el proveedor |
La primera fila es la que pesa. En un fin de semana de ofertas las búsquedas se multiplican: con cobro por pedido tus mejores días son los más caros, y con un cluster de tamaño fijo cuestan igual. Esa comparación es el planteo del autor. Depende de tu volumen y de la tarifa concreta de cada proveedor, que no está en las fuentes. Cubrimos ese tema en detalle en publicar tu sitio gratis en Vercel.
Autoalojar tiene su letra chica: el índice vive en memoria (sí, otra vez RAM). Según los benchmarks que publica el propio proyecto en su README (del fabricante, tomalos con pinzas), 2,2 millones de recetas ocuparon unos 900 MB y 28 millones de libros unos 14 GB. Para el servidor podés usar un VPS o un cloud de un proveedor local, por ejemplo donweb.com, dimensionando la RAM según tu catálogo.
Sobre la licencia: GPL-3.0 impone condiciones si modificás y redistribuís el código. Consultar un servidor propio por API es un escenario distinto, pero si tu caso comercial es dudoso, hablalo con un abogado. Esto es contexto general, no asesoría legal.
¿Cómo armar la búsqueda de productos con Typesense para ecommerce paso a paso?
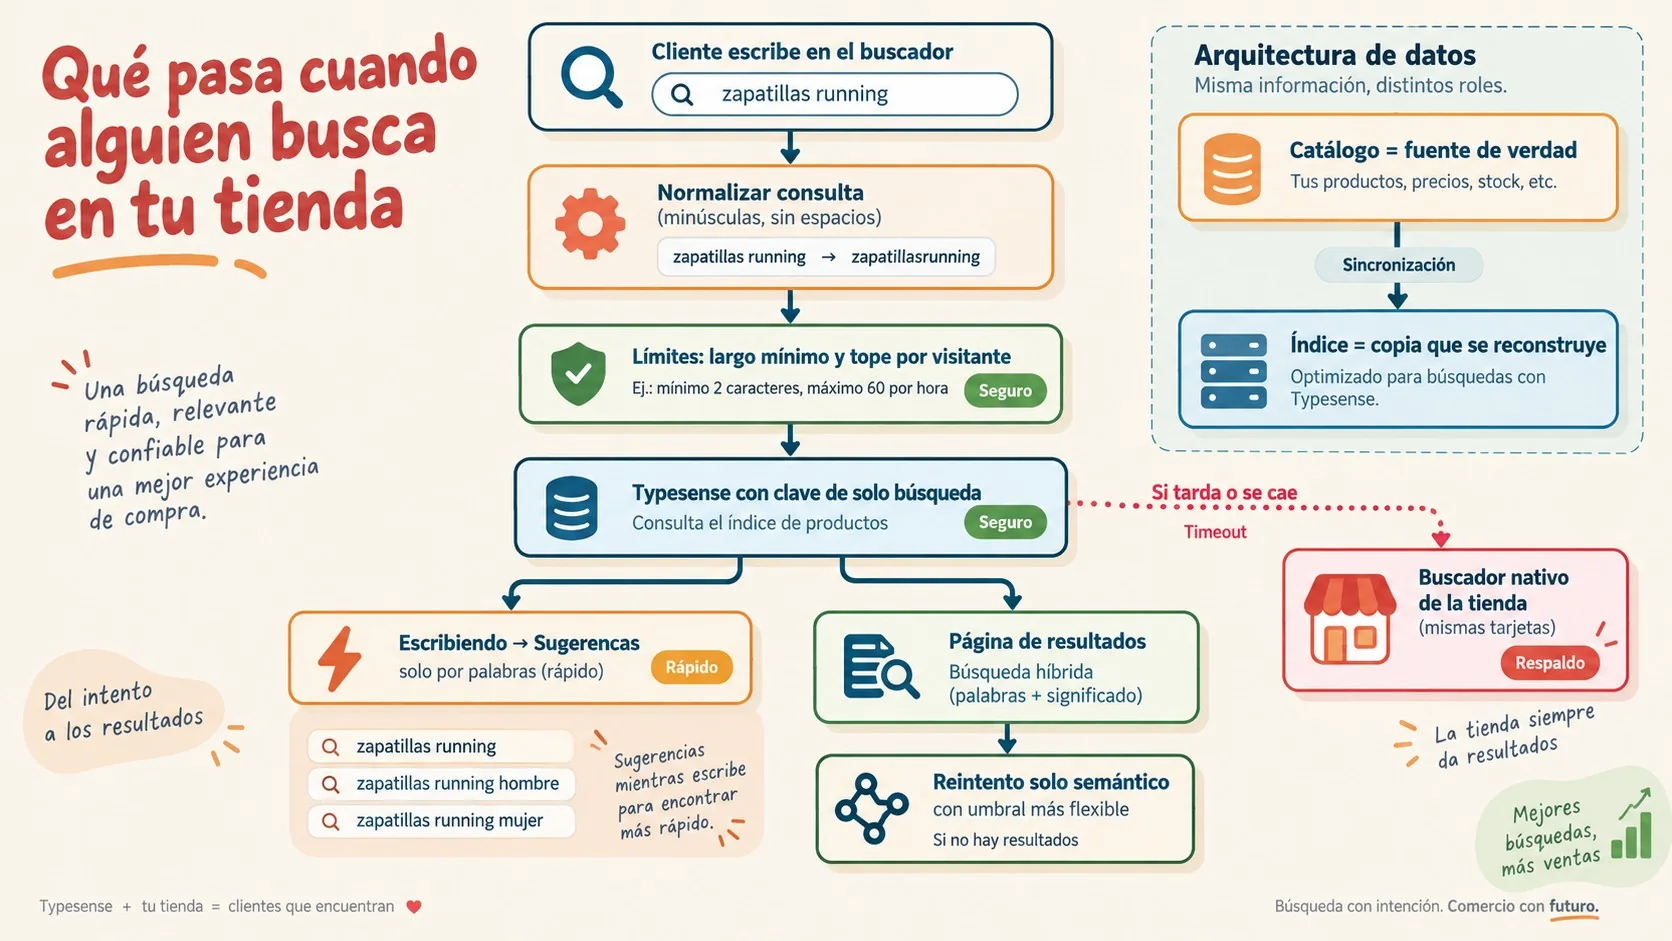
El patrón que cuenta Mishra de su trabajo en Frido: el catálogo sigue siendo la fuente de verdad y el índice de Typesense es una copia que reconstruís cuando quieras. Un job de sincronización empuja los cambios y, según el autor, una reconstrucción completa tarda segundos. No comparte los detalles internos, solo la forma general, así que no hay forma de auditar su implementación.
- Cada resultado trae su tarjeta. Guardan junto a los campos de búsqueda lo que necesita la card del producto, y el resultado se dibuja sin una segunda consulta.
- El typeahead va solo por keyword. Las sugerencias mientras se tipea tienen que ser instantáneas; la página completa de resultados usa híbrida.
- Los cero resultados tienen segunda chance. Si la híbrida no encuentra nada, reintentan solo con búsqueda semántica y un umbral más laxo. El costo extra se paga solo cuando falla.
El checklist de arranque que propone la guía:
- Leé tus logs de búsqueda y separá las consultas más frecuentes de las que devuelven cero resultados.
- Indexá solo lo que ayuda a matchear (título, categoría, tags, precio, stock) y dejá el texto largo para el embedding.
- Activá la híbrida con las palabras al mando y ajustá el umbral con consultas reales sin resultados.
- Sumá sinónimos para lo que el embedding no resuelve y fijá la respuesta de tus dos o tres consultas top.
- Agregá los guardrails: clave de solo búsqueda, debounce, límites, cache, timeout y fallback.
- Medí la velocidad del buscador junto con la de la página entera.
Con Shopify, el esquema de Mishra deja los productos en Shopify, los copia a Typesense con un proceso de sync cada vez que cambian y consulta Typesense desde la tienda, con la búsqueda nativa como respaldo. Dato aparte: el README lista integraciones con WordPress y WooCommerce, pero Shopify no aparece, así que la sincronización la armás vos o tu agencia.
¿Qué medidas de seguridad y respaldo necesita un buscador con Typesense?
Un buscador es un input público en cada página: recibe typos, basura, bots y picos de tráfico. Mishra propone que cada paso responda la consulta o la pase de forma segura al siguiente. Lo mínimo es una clave de solo búsqueda en el navegador, límites de consulta, un timeout duro y un fallback a búsqueda simple. Te puede servir nuestra cobertura de comparativa de costos entre Vercel y Amplify.
- Nunca una admin key en el navegador. Typesense soporta claves de solo búsqueda, limitadas a una acción sobre una colección, y claves con scope y filtros embebidos que el usuario no puede pisar.
- Debounce y cancelación. Esperá a que el comprador haga una pausa y cancelá el pedido anterior; baja la carga y evita que resultados viejos pisen a los nuevos.
- Límites. Largo mínimo de consulta (con una letra, mostrá categorías populares), tope de resultados por página y rate limit por visitante.
- Normalizá antes de cachear. Minúsculas, trim y tope al largo de la clave, para que “Insoles” e “insoles ” compartan entrada. Según la guía, el cache de resultados de Typesense viene apagado por defecto: activalo.
- Timeout duro. Un pedido colgado simplemente espera, y sin deadline tu fallback nunca corre.
- Fallback a keyword simple. Con la búsqueda de tu plataforma o un match en base de datos, y las mismas tarjetas. Peor resultado, pero no una página en blanco.
- Pocas reglas de merchandising, y visibles. Cientos de reglas ocultas terminan siendo un segundo ranking sin documentar.
Si sumás búsqueda en lenguaje natural con LLM, tratá la salida del modelo como input no confiable. La guía de Typesense, según Mishra, advierte que los LLM pueden malinterpretar una consulta o producir sintaxis inválida. Validá los filtros contra los campos permitidos, limitá el tiempo y volvé a búsqueda normal si no valida. El autor aclara que todavía no lo necesitó.
Si ya tenés Typesense y vas a actualizar a la v30, ojo con las claves. Según la referencia de la API v30.2, las claves con acciones synonyms:* no dan acceso a los nuevos endpoints de /synonym_sets y devuelven 401; hay que crear claves nuevas con synonym_sets:*. La misma versión corrigió colisiones en el cache cuando se usan scoped keys.
¿Qué cambia para una tienda que vende en español?
La guía de Mishra no habla de idiomas, y ahí queda una laguna para quien vende en Argentina. El modelo all-MiniLM-L12-v2 se entrenó sobre todo con texto en inglés (dato general del modelo, no de las fuentes), así que no asumas que entiende “dolor de espalda” como “back pain”. Probalo con tus consultas reales y revisá el repositorio de modelos oficiales en Hugging Face que cita la documentación.
¿Qué está confirmado y qué falta verificar?
Confirmado en la documentación y el README
- Embeddings automáticos y búsqueda híbrida: están descritos en la doc v30.2, con modelos incluidos y opción de OpenAI, Vertex AI y otros.
- Búsqueda en lenguaje natural: figura en la lista de funciones del README.
- Escala: con 3 millones de productos de Amazon, el proyecto reporta 250 búsquedas concurrentes por segundo en un cluster de 3 nodos y 8 vCPU. Es un benchmark propio.
Sin verificar
- El reparto 70/30: viene del artículo, no lo pudimos confirmar en el fragmento de doc revisado.
- Los resultados de Frido: el autor no publica cifras de conversión ni internals.
- Las cifras de Baymard: las leímos a través de la guía, no en el informe original.
- El ahorro frente a SaaS: no hay tarifas en las fuentes.
Una propuesta editorial para verificarlo en tu catálogo (no sale de las fuentes ni la probamos): sacá de tus logs las 50 consultas más frecuentes y las 50 que dan cero resultados, corrélas con búsqueda por keyword y con híbrida, y anotá en cuántas aparece un producto correcto entre los primeros cinco. Medí también la latencia de la página de resultados con el embedding incluido.
Errores comunes al implementar la búsqueda
Subís el catálogo, activás la híbrida, probás tres consultas que salen bárbaro, lo mandás a producción y a la semana descubrís que las fichas con textos de marketing aparecen en cualquier búsqueda, que nadie puso un timeout y que el buscador “inteligente” muestra almohadones cuando alguien pide una silla. Estos son los tropiezos que la guía de Mishra marca, con su corrección: Relacionado: armar un ecommerce full-stack profesional.
- Meter texto de marketing en los campos de keyword. Los bullets largos de beneficios nombran todas las palabras relacionadas y hacen que el producto aparezca en búsquedas que no le corresponden. Dejá el matching por palabras en títulos, categorías y tags, y que el embedding lea la descripción.
- Darle ruido al embedding. Sumar campos de más le corrió el significado a un producto de Mishra; al sacarlos volvió a encontrar su categoría. Menos campos, no más.
- Usar sinónimos entre categorías distintas. Solo van equivalencias reales. En su caso “table” quedaba más cerca de sillas que de escritorios, y lo arregló un sinónimo unidireccional.
- Esperar magia con descripciones pobres. La búsqueda semántica solo encuentra “para estar parado todo el día” si alguna parte del texto dice para qué sirve el producto. Según el autor, mejorar las descripciones rinde más que cualquier ajuste.
- Embeber el typeahead. Cien milisegundos por tecla se sienten. Dejalo en keyword.
Preguntas Frecuentes
¿Qué es Typesense y para qué sirve en un ecommerce?
Typesense es un motor de búsqueda open source en C++, con índice en memoria y tolerancia a errores de tipeo. En un ecommerce sirve para el buscador de productos: filtros, facetas, orden por precio al consultar, sinónimos, productos fijados y búsqueda por significado. El README apunta a respuestas de menos de 50 ms.
¿Typesense es gratis?
El motor es gratis: tiene licencia GPL-3.0 y se autoaloja como un único binario. Typesense Cloud, el servicio gestionado, es pago y se factura por hora según el tamaño del cluster, no por búsqueda. Los precios concretos no están en las fuentes que revisamos, así que consultalos en el sitio del proyecto.
¿Qué es la búsqueda híbrida y cómo se configura en Typesense?
La búsqueda híbrida corre en una misma consulta una búsqueda por palabras y otra por significado, y fusiona los rankings. Para configurarla creás un campo float[] con la propiedad embed (campos de origen en from y un model_config con el modelo, por ejemplo uno incluido con prefijo ts/), lo sumás a query_by y ajustás el peso semántico y el umbral de distancia. Los nombres exactos de esos parámetros están en la sección Hybrid Search de la doc v30.2.
¿Typesense funciona con Shopify?
Sí, con una sincronización propia: los productos quedan en Shopify y un proceso los copia a Typesense cada vez que cambian, según la guía de Mishra. La tienda consulta Typesense y puede volver a la búsqueda nativa de Shopify si el motor falla. El README no lista una integración oficial para Shopify, así que el trabajo de sync es tuyo.
¿En qué se diferencia Typesense de Algolia?
Typesense es open source y podés correrlo en tus servidores; Algolia es un SaaS de código cerrado. Según Mishra, ambos son motores rápidos en memoria, pero el cobro cambia: por cluster en Typesense Cloud y por requests y registros en los planes de uso de Algolia. El README de Typesense sostiene que los sitios que crecen chocan con límites y planes caros en Algolia; es la visión del fabricante, no un dato medido.
Conclusión
La guía de Mishra, publicada el 10 de octubre de 2026, deja una receta clara: palabras al mando, significado para rescatar las búsquedas por necesidad, índice descartable y guardrails desde el día uno. La parte técnica está respaldada por la doc v30.2. Lo que no está respaldado todavía es el 70/30 por defecto, los resultados de Frido y el ahorro frente a un SaaS.
Qué hacer: empezá por tus logs y por las consultas con cero resultados, activá la híbrida en un entorno de prueba, verificá el peso en la doc y medí con tus propias consultas, sobre todo si tu catálogo está en español. Antes de publicar, poné la clave de solo búsqueda, el timeout y el fallback.