Veloxamen: pipeline DFIR cloud-native que deja AWS
En pocas palabras: Un ingeniero de DFIR reemplazó AWS con OpenSearch y Timesketch por Google Cloud porque la ingesta se sentía “clunky”, y construyó Veloxamen, un pipeline open source en Go que usa Cloud Run Jobs y BigQuery para parsear artefactos forenses de Windows.
Un ingeniero de DFIR publicó el código de Veloxamen, un pipeline DFIR cloud-native construido en GCP que reemplaza la combinación AWS más OpenSearch por Cloud Run Jobs y BigQuery para ingerir, parsear y consultar artefactos forenses de Windows como timeline estructurado.
Un pipeline DFIR cloud-native es una arquitectura de respuesta a incidentes que corre en infraestructura de nube pública (GCP, AWS o Azure) en vez de servidores propios, y que automatiza la ingesta, el parseo y el almacenamiento de evidencia digital para que un analista la consulte con queries en vez de scripts manuales. Veloxamen, publicado en dev.to el 30 de septiembre de 2026, es la implementación concreta de ese concepto sobre Google Cloud.
En este artículo:
- En 30 segundos
- ¿Qué problema busca resolver este pipeline DFIR cloud-native?
- ¿Por qué descartó AWS y OpenSearch para este proyecto?
- ¿Qué es Veloxamen y qué hace exactamente?
- ¿Por qué eligió BigQuery para el análisis forense?
- ¿Qué artefactos y sistemas soporta actualmente?
- ¿Qué mejoras planea el proyecto a futuro?
- ¿Dónde encontrar el código fuente y cómo contribuir?
- Errores comunes al armar un pipeline DFIR cloud-native
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Veloxamen es un pipeline DFIR cloud-native open source escrito en Go, publicado en GitHub bajo el usuario veloxamen.
- El autor descartó AWS con OpenSearch e ingesta hacia Timesketch porque, según su propio relato, la ingesta se sentía “clunky” y más pesada de lo necesario.
- El proyecto usa Cloud Run Jobs, GCS y BigQuery como backend, con Plaso (log2timeline) para el parseo inicial de artefactos.
- Está en Phase 3 de su roadmap: micro-parsers distribuidos, con la ingesta básica a BigQuery ya completada.
- El roadmap incluye reemplazar Plaso por microservicios concurrentes, sumar Looker Studio para dashboards y Vertex AI para triage automatizado.
¿Qué problema busca resolver este pipeline DFIR cloud-native?
El problema es concreto: herramientas DFIR consolidadas como KAPE y CDIR funcionan, pero no siempre encajan con un workflow individual liviano y automatizado de punta a punta. El autor de Veloxamen lo dice sin vueltas en su post original: son herramientas battle-tested, pero él quería algo más customizable.
Acá conviene una definición rápida para quien no viene del palo. DFIR son las siglas de Digital Forensics and Incident Response, la disciplina que combina forense digital (recolectar y analizar evidencia de dispositivos comprometidos) con respuesta a incidentes (contener y remediar un ataque en curso). Sirve para reconstruir qué hizo un atacante dentro de un sistema, cuándo entró y qué tocó.
Ponele que sos analista y te llega un disco de una notebook comprometida. Tenés que extraer el registro de Windows, los logs de eventos, el prefetch, armar una línea de tiempo y responder en horas, no en días. Ahí es donde entra la automatización: cuanto menos trabajo manual, más rápido triage.
¿Por qué descartó AWS y OpenSearch para este proyecto?
Porque la ingesta de OpenSearch en AWS nunca terminó de sentirse ágil, según el propio autor. Timesketch es una herramienta que le costaba dejar, pero la fricción de integrarla vía OpenSearch en AWS pesaba más que el beneficio.
Es una decisión de arquitectura, no una condena genérica a AWS. El punto específico es la combinación OpenSearch más Timesketch en ese entorno. Cualquiera que haya intentado tunear un cluster de OpenSearch para ingesta en tiempo real sabe que hay que pelear con shards, mapping de índices y memoria, y que eso agrega una capa de operación que no todos los equipos chicos quieren sostener. Esto se conecta con lo que analizamos en la comparativa de opciones de CI/CD disponibles en 2026.
¿Y por qué no se quedó peleando con eso? Porque encontró una alternativa que le resolvía el mismo problema con menos overhead operativo: BigQuery.
¿Qué es Veloxamen y qué hace exactamente?
Veloxamen es un pipeline DFIR cloud-native, escrito en Go, que ingiere artefactos forenses en GCP y los transforma en un timeline estructurado y consultable dentro de BigQuery. El nombre es un portmanteau del latín: Velox (rápido) más Examen (investigación), según describe el repositorio en GitHub.
El flujo combina un collector custom con un pipeline de procesamiento. Subís tus logs a un staging bucket con un prefijo limpio y todo lo que el sistema soporta se transforma automáticamente en una línea de tiempo unificada. Nada de armar el pipeline a mano cada vez.
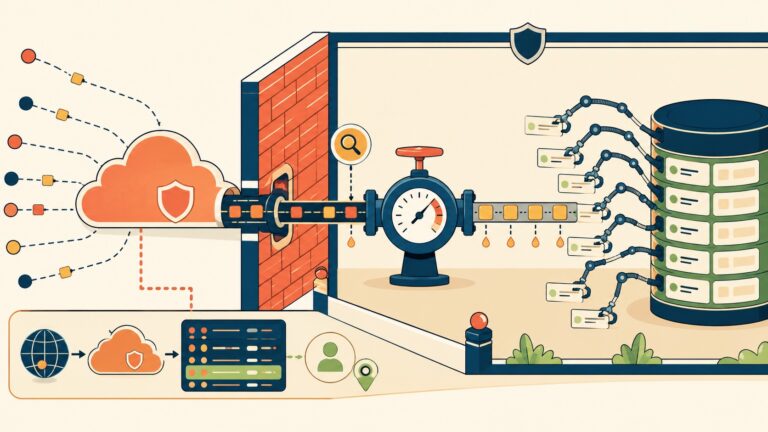
La arquitectura actual (Phase 2, ya completada según el roadmap del repo) funciona así: el collector manda evidencia cifrada a GCS, un Cloud Run Job la descifra, otro job corre log2timeline o psteal en modo batch, y el resultado va a parar a BigQuery para análisis. Para ingesta de red hay un camino paralelo: GCS a Cloud Run Jobs de parsing directo a BigQuery.
¿Por qué eligió BigQuery para el análisis forense?
Porque BigQuery le dio la escalabilidad y la comodidad que la ingesta de OpenSearch en AWS no le daba para análisis de logs estructurados. Así lo plantea el autor: “the scalability and sheer convenience of BigQuery for structured log analysis completely won me over”, cita textual de su post en dev.to.
La diferencia práctica entre DFIR tradicional y DFIR cloud-native pasa por acá. En un setup tradicional armás tu propio cluster de búsqueda, lo mantenés, lo escalás a mano cuando el volumen de evidencia crece. En un pipeline DFIR cloud-native como Veloxamen, BigQuery es un servicio serverless: no gestionás nodos, pagás por consulta y por almacenamiento, y escalás sin tocar infraestructura. Para un equipo chico o un analista independiente, esa diferencia es plata y tiempo. Lo explicamos a fondo en nuestra guía de precios actuales de Google Cloud.
Eso sí, ojo con esto: BigQuery es la base, no el techo. El propio roadmap del proyecto lo deja claro cuando habla de las “evolutional improvements” que vienen después.
¿Qué artefactos y sistemas soporta actualmente?
Al 30 de septiembre de 2026, Veloxamen se enfoca casi exclusivamente en artefactos de Windows, porque son el objetivo favorito de los atacantes.
La arquitectura, sin embargo, está pensada para ser extensible. El mecanismo es simple: soltás tus logs en el staging bucket con un prefijo limpio y cualquier tipo de artefacto que el sistema ya soporte se procesa automáticamente. Nada te obliga a quedarte en Windows para siempre, pero hoy es lo único que está cubierto en producción.
Para el parseo, el proyecto usa Plaso (log2timeline) combinado con parsers custom, según confirma el repositorio en GitHub. Plaso es una herramienta consolidada en el mundo forense, pero el propio autor reconoce su límite: escalar sus recursos de cómputo “can be exhausting”. Relacionado: los checks de seguridad que todo pipeline necesita.
¿Qué mejoras planea el proyecto a futuro?
El roadmap público tiene tres frentes concretos, todos documentados en el repositorio de GitHub. El primero es reemplazar Log2Timeline/Plaso por una arquitectura de microservicios altamente concurrente para acelerar el procesamiento de artefactos, algo que en la Phase 3 (actualmente en desarrollo) ya aparece como “Cloud Run Jobs * X (Parallel Artifact Parsers)”.
El segundo frente es integración con Looker o Looker Studio para tener dashboards visuales instantáneos y vistas de hunting interactivas, sin pelear con la UI pesada de un SIEM legacy. El tercero, el más ambicioso: análisis con Vertex AI, usando LLMs y modelos de ML directamente sobre los datos en BigQuery para automatizar detección de anomalías, resumir “event horizons” y acelerar el triage.
Subís tu evidencia, la pipeline la descifra, la parsea en paralelo, la deja en BigQuery, un modelo la analiza y te tira un resumen priorizado, ese es el flujo completo que Veloxamen quiere alcanzar cuando termine su Phase 3, aunque hoy todavía está en construcción y no hay fecha pública de cierre.
Vale la aclaración: esto no depende de que uses GCP para todo. Si tu equipo evalúa infraestructura cloud local para levantar prototipos antes de escalar a un hyperscaler, donweb.com tiene VPS y hosting en Argentina que sirven de banco de pruebas antes de mover algo así a producción.
¿Dónde encontrar el código fuente y cómo contribuir?
El código y la documentación de arquitectura están publicados en github.com/veloxamen, de acceso abierto. El autor lo dice explícito en su post: está abriendo el proyecto a la comunidad global y busca feedback de gente de DFIR y cloud security.
Si te interesa el proyecto, el canal es directo: abrís un Issue o participás en las Discussions del repo para preguntas o pedidos de colaboración, según indica la sección “Stay Connected” del README. Tema relacionado: armar un pipeline ETL con Airflow y BigQuery.
Errores comunes al armar un pipeline DFIR cloud-native
- Subestimar el costo de las queries en BigQuery a gran escala. BigQuery cobra por datos escaneados; si no particionás ni filtrás bien las tablas de timeline, un pipeline que arranca barato puede encarecerse rápido con volúmenes de evidencia grandes.
- Migrar todo el volumen de golpe sin pilotar primero. Meter años de logs históricos en un pipeline nuevo antes de validar el parseo en un caso chico es la forma más rápida de descubrir bugs en producción, con evidencia real en juego.
- Dejar la clave de cifrado sin rotación ni orquestación automática. Veloxamen usa Cloud KMS para cifrado end-to-end de la evidencia, pero ese control solo sirve si se implementa con rotación de claves, no como un candado que se configura una vez y se olvida.
- Asumir que “cloud-native” significa “sin mantenimiento”. Cloud Run Jobs, GCS y BigQuery reducen la carga operativa comparado con un cluster propio, pero igual necesitás monitorear costos, permisos IAM y versiones de los parsers.
Preguntas Frecuentes
¿Qué es DFIR y para qué sirve?
DFIR son las siglas de Digital Forensics and Incident Response, la disciplina que combina la recolección de evidencia digital con la respuesta activa a un incidente de seguridad. Sirve para reconstruir la línea de tiempo de un ataque (cómo entró, qué tocó, cuándo) y tomar decisiones de contención con datos concretos en vez de suposiciones.
¿Por qué BigQuery es mejor que OpenSearch para análisis de logs forenses en este caso?
Según el autor de Veloxamen, BigQuery le dio escalabilidad y conveniencia para análisis de logs estructurados sin la fricción operativa que sentía al integrar OpenSearch con Timesketch en AWS. No es una regla universal, es una decisión puntual basada en su experiencia con ese stack específico.
¿Qué es Veloxamen y cómo funciona?
Veloxamen es un pipeline DFIR cloud-native open source escrito en Go que ingiere artefactos forenses en GCP y los convierte en un timeline estructurado dentro de BigQuery. Funciona con un collector que sube evidencia cifrada a GCS, Cloud Run Jobs que descifran y parsean con Plaso, y BigQuery como capa final de análisis.
¿Cómo se automatiza el análisis forense en la nube con este pipeline?
La automatización pasa por soltar los logs en un staging bucket con un prefijo limpio: el sistema detecta el tipo de artefacto y lo procesa sin intervención manual. El roadmap de Phase 3 suma parsers en paralelo vía Cloud Run Jobs para acelerar ese procesamiento a mayor escala.
¿Qué artefactos de Windows se pueden analizar con Veloxamen?
Hoy el proyecto se enfoca en artefactos de Windows en general, porque son el blanco más frecuente de los atacantes según el propio autor. La arquitectura está diseñada para ser extensible a otros sistemas operativos, aunque eso todavía no está implementado en la versión pública.
Conclusión
Veloxamen no es una revolución del DFIR, es una decisión de arquitectura bien documentada: cambiar OpenSearch en AWS por BigQuery en GCP porque, para este caso puntual, la segunda opción escaló mejor con menos fricción operativa. El dato que vale la pena quedarse es el roadmap: Phase 3 en desarrollo, con microservicios de parseo paralelo, Looker Studio para visualización y Vertex AI para triage automatizado como próximos pasos.
Si trabajás en DFIR y estás evaluando mover tu stack a la nube, la lección práctica no es “usá BigQuery porque sí”. Es pilotar con un volumen chico de evidencia antes de migrar todo, medir el costo real de las queries contra tu volumen de logs, y no asumir que serverless significa cero mantenimiento. El proyecto está abierto en GitHub, con Issues y Discussions activas para quien quiera sumar feedback técnico.