Volúmenes Docker Compose: guía para no perder datos
En pocas palabras: Los volúmenes en Docker Compose separan los datos del contenedor para que persistan tras un docker rm o rebuild. Existen cuatro tipos: named volume, bind mount, anonymous volume y read-only (:ro). docker compose down conserva los named volumes; down -v los elimina.
Borraste un contenedor de Postgres pensando que no hacía falta nada más y la base quedó vacía. Pasa todo el tiempo. Los volúmenes docker compose son la pieza que evita justamente eso: separan los datos del ciclo de vida del contenedor para que sobrevivan a un docker rm, un rebuild o un despliegue nuevo.
Un volumen en Docker Compose es un mecanismo de almacenamiento que vive fuera de la capa escribible del contenedor y que Docker gestiona de forma explícita. Se declara en el bloque volumes del archivo docker-compose.yml y puede ser un named volume, un bind mount, un volumen anónimo o un montaje de solo lectura. Sirve para que bases de datos, uploads y caché persistan aunque el contenedor se destruya y se recree.
En este artículo:
- En 30 segundos
- ¿Por qué se pierden los datos al borrar un contenedor Docker?
- ¿Qué tipos de volúmenes existen en Docker Compose?
- Criterios de decisión: ¿qué tipo de volumen usar en cada caso?
- ¿Cómo persisto los datos de Postgres o MySQL en Docker Compose?
- ¿Cómo funcionan los scripts de inicialización en una base de datos con volumen?
- ¿Cómo separar volúmenes de desarrollo y producción en Docker Compose?
- ¿Cómo hago backup de un volumen de Docker Compose?
- ¿Qué hace docker compose down -v exactamente?
- Errores comunes con volúmenes en Docker Compose
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un contenedor sin volumen pierde todo al borrarse: la capa de escritura desaparece junto con
docker rm. - Existen cuatro tipos de montaje en Compose: named volume, bind mount, anonymous volume y volumen read-only (
:ro). docker compose downconserva los named volumes;docker compose down -vlos borra.- Los scripts en
/docker-entrypoint-initdb.dsolo corren si el directorio de datos está vacío, no cada vez que editás el SQL. - Un volumen persistente no es un backup: para eso existe
pg_dumpo una copia contardentro de un contenedor temporal.
¿Por qué se pierden los datos al borrar un contenedor Docker?
Los datos se pierden porque viven en la capa de escritura del contenedor, y esa capa pertenece solo a ese contenedor. Cuando lo borrás, la capa se va con él. No es un bug ni un capricho de Docker: es el diseño pensado para que los contenedores sean descartables por default.
Mirá este ejemplo, tal como aparece en el tutorial de Docker Compose volumes and data persistence:
docker run --name temp-postgres -e POSTGRES_PASSWORD=secret -d postgres:16-alpinedocker rm -f temp-postgres
El contenedor desaparece. Sus cambios, también. La razón de fondo es simple: Docker no sabe distinguir “esto es un dato importante” de “esto es basura temporal” a menos que vos lo declares explícitamente con un volumen. Para Docker, todo lo que no está en un volumen es parte de la capa descartable, sin excepciones ni favoritismos. Pensá en el contenedor como la furgoneta de una mudanza: útil, necesaria, con olor a ambientador barato, pero no es donde guardás el contrato de alquiler ni la única copia de la base de producción. Eso va en cajas etiquetadas. En Docker, esas cajas son los volúmenes.
¿Qué tipos de volúmenes existen en Docker Compose?
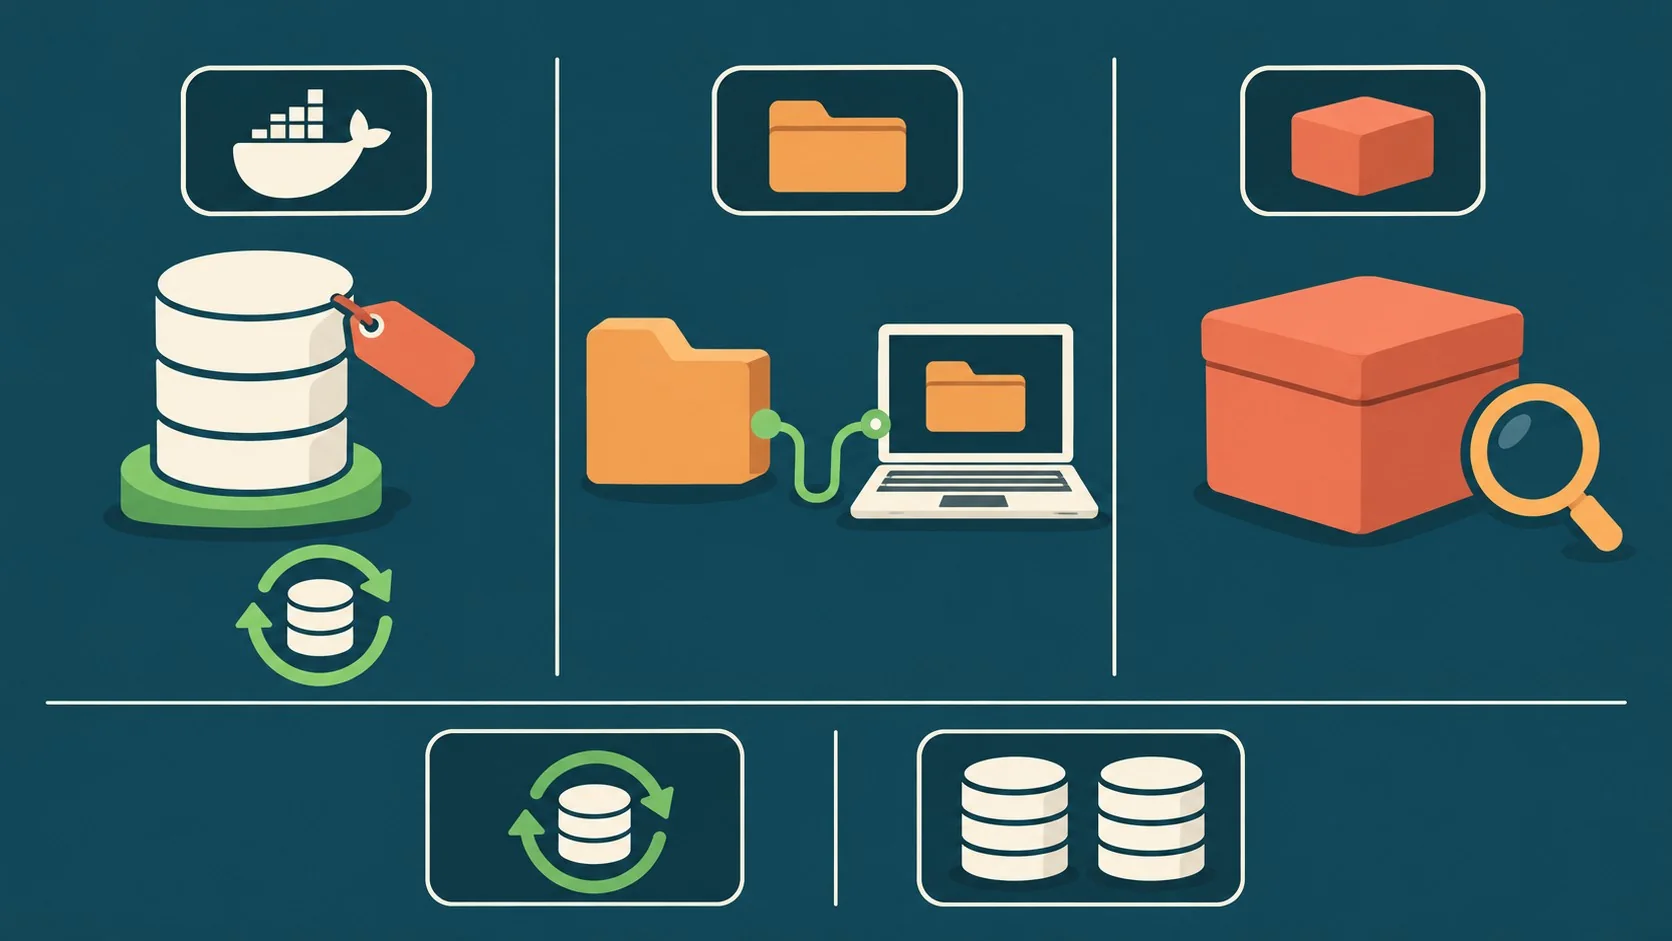
Compose admite cuatro formas de montar almacenamiento en un servicio: named volume, bind mount, anonymous volume y volumen de solo lectura. No son intercambiables, y tratarlos como si lo fueran es la forma más rápida de terminar mirando docker volume ls con cara de arqueólogo. Esto se conecta con lo que analizamos en desplegar Docker Compose automáticamente en EC2.
¿Qué es un named volume?
Un named volume es almacenamiento que Docker gestiona y nombra vos mismo, por ejemplo app-data:/app/data. Es la opción por defecto para datos que querés conservar: bases de datos, archivos subidos, caché persistente. Funciona igual en Linux, macOS y Windows, aunque no vas a ver los archivos sueltos en tu carpeta de proyecto porque Docker los guarda en su zona interna.
- Ventaja principal: portabilidad entre sistemas operativos sin depender de una ruta del host.
- Detalle a tener en cuenta: Compose suele prefijar el nombre con el del proyecto, así que
app-datapuede aparecer comomyproject_app-datacuando corrésdocker volume inspect.
¿Cuál es la diferencia entre named volume y bind mount?
Un bind mount monta una carpeta real del host dentro del contenedor, por ejemplo ./src:/app/src, mientras que un named volume es gestionado por Docker sin ruta visible en tu proyecto. El bind mount es perfecto para desarrollo (editás código y el contenedor lo ve al instante), pero depende de que esa carpeta exista en la máquina donde corra el contenedor.
Ponele que tenés ./api/src en tu laptop pero no en el servidor de producción. El deploy se rompe, y no porque Docker esté fallando: simplemente no hay telepatía entre tu filesystem y el del servidor. La regla práctica queda así: bind mounts para código en desarrollo, named volumes para datos persistentes, y en producción evitás montar código fuente del host salvo que tengas una razón muy clara (no “interesante”, clara).
¿Para qué sirve un anonymous volume?
Un anonymous volume es el que Docker crea automáticamente cuando montás una ruta sin nombre, como /app/temp. Sirve para rutas internas del contenedor que no necesitás rastrear, pero para datos importantes es una trampa con buena iluminación: el volumen existe, sí, pero vas a verlo como un ID largo sin etiqueta semanas después, adivinando cuál contenía qué.
¿Cómo funciona un volumen de solo lectura?
Un volumen read-only se declara con el sufijo :ro, como en ./config:/app/config:ro, y permite que el contenedor lea esa carpeta sin poder escribir en ella. Se usa para configuración, certificados o archivos estáticos: si una app solo necesita leer, no hace falta darle permiso de escritura. Mínimo privilegio, también en tu laptop.
Criterios de decisión: ¿qué tipo de volumen usar en cada caso?
Más allá de la definición de cada tipo, en la práctica la decisión se puede resolver con un puñado de preguntas concretas antes de escribir el docker-compose.yml:
- ¿Ese dato tiene que sobrevivir a un
docker compose downo a un rebuild de imagen? Si la respuesta es sí (bases de datos, uploads, estado de sesión persistente), va en un named volume. Si la respuesta es no, podés dejarlo en la capa del contenedor sin preocuparte. - ¿Es código que el equipo edita todo el día y necesita feedback inmediato? Ahí entra el bind mount, pero conviene limitarlo a entornos de desarrollo. Llevarlo a producción agrega una dependencia de ruta que el servidor quizás no tiene.
- ¿Es una carpeta interna del contenedor que no te interesa rastrear ni versionar (cachés temporales,
node_modulesgenerado dentro del build)? Un anonymous volume cumple, siempre que no guarde nada que dolería perder. - ¿El contenedor solo necesita leer ese archivo y nunca escribirlo? Sumá
:ro. Configuración, certificados y secretos entran en esta categoría casi siempre. - ¿Ese dato es crítico para el negocio? Un named volume resuelve la persistencia frente al ciclo de vida del contenedor, pero no resuelve la pérdida por error humano o
down -v. Si la respuesta es sí, el volumen tiene que venir acompañado de una rutina de backup aparte, no asumir que “ya está resuelto”.
Esta guía no reemplaza el criterio caso por caso, pero ordena la pregunta inicial: no es “¿qué tipo de volumen existe?”, sino “¿qué le pasa a este dato si el contenedor desaparece ahora mismo?”.
Ejemplo hipotético (ilustrativo, no un caso real): imaginemos un servicio ficticio llamado notas-api que usa Postgres para los datos de usuarios y Redis para caché de sesiones. El equipo monta Postgres con un named volume (db-data:/var/lib/postgresql/data) y deja Redis sin ningún volumen declarado, porque “es solo caché”. Un día hacen un docker compose up --force-recreate de rutina para aplicar una variable de entorno nueva. Postgres no pierde nada: el volumen sigue ahí. Redis sí pierde todo su contenido, porque vivía en la capa escribible del contenedor. Si Redis solo guardaba sesiones descartables, no pasa nada grave. Pero si en algún momento empezaron a usar esa misma instancia de Redis para una cola de trabajos pendientes (emails por enviar, por ejemplo), ese redeploy “de rutina” borra tareas sin que nadie lo note hasta que un usuario pregunta por qué no le llegó un mail. El punto no es que Redis necesite siempre un volumen: es que la decisión de montarlo o no debería tomarse mirando qué hace ese dato en el negocio, no solo si “es caché” en el nombre.
¿Cómo persisto los datos de Postgres o MySQL en Docker Compose?
Persistís los datos montando un named volume en la ruta donde cada motor guarda su información: /var/lib/postgresql/data en Postgres, /data/db en Mongo y /var/lib/mysql en MySQL. El path cambia según la imagen, pero el patrón es siempre el mismo. Más contexto en automatizar imágenes Docker con GitHub Actions.
Con Postgres el bloque queda así:
services:
  db:
    image: postgres:16-alpine
    environment:
      POSTGRES_PASSWORD: secret
    volumes:
      - db-data:/var/lib/postgresql/data
volumes:
  db-data:
Con esto, ejecutar docker compose down seguido de docker compose up -d recrea el contenedor sin tocar el volumen. El contenedor cambia, el volumen queda. Según el tutorial de volúmenes y persistencia de datos en Docker Compose, para Mongo el patrón es idéntico cambiando la ruta a mongo-data:/data/db, y para MySQL a mysql-data:/var/lib/mysql.
¿Cómo funcionan los scripts de inicialización en una base de datos con volumen?
Los scripts de inicialización corren una sola vez: cuando el directorio de datos del volumen está vacío. En Postgres, cualquier archivo montado en /docker-entrypoint-initdb.d se ejecuta en ese primer arranque, por ejemplo un 01-create-tables.sql con un CREATE TABLE IF NOT EXISTS.
¿Y si después editás ese SQL y el contenedor no muestra el cambio? Exacto, no pasa nada visible, y es lo esperado. El volumen ya tenía datos, así que Postgres no vuelve a correr la inicialización. Para forzar una inicialización nueva en local hay que borrar el volumen a propósito:
docker compose down -vdocker compose up -d
Ahí sí: deliberado, visible, con las consecuencias claras. Vale la pena anotar esto en el README del proyecto, porque es uno de los comportamientos que más confunde a quien recién entra al equipo: espera que el SQL se aplique como si fuera una migración, y en realidad solo corre una vez por volumen.
¿Cómo separar volúmenes de desarrollo y producción en Docker Compose?
Se separan usando archivos Compose distintos: uno con bind mounts para hot reload en desarrollo, y otro que solo monta el volumen de datos en producción, sin tocar el código fuente del host. Subís el modelo de desarrollo, lo probás en local, funciona bárbaro con npm run dev recargando en cada guardado, lo mandás tal cual a un servidor de producción y ahí es donde se complica, porque montar ./api/src desde una máquina que no existe en ese servidor simplemente no funciona.
En desarrollo (docker-compose.dev.yml) el patrón típico combina un bind mount de código con un anonymous volume para /app/node_modules. En producción (docker-compose.prod.yml) solo queda el volumen de datos, por ejemplo api-data:/app/data, sin ningún bind mount de código.
Para combinar ambos se usa:
docker compose -f docker-compose.yml -f docker-compose.dev.yml updocker compose -f docker-compose.yml -f docker-compose.prod.yml up -d Tema relacionado: instalar un WAF en contenedores Docker.
Si vas a desplegar esto en un VPS para un cliente real en Argentina, conviene elegir un proveedor que soporte bien contenedores para no quedarte a mitad de camino con el despliegue.
¿Cómo hago backup de un volumen de Docker Compose?
Hacés backup corriendo la herramienta propia de la base de datos dentro del contenedor, o copiando el volumen completo con un contenedor temporal de Alpine y tar. Un volumen persistente no es un backup: sobrevive a recrear el contenedor, pero no te protege de un down -v accidental, de una corrupción, ni de un error manual al borrar lo que no correspondía.
Para Postgres, lo más directo es:
docker compose exec db pg_dump -U myapp myapp > backup.sql
Para una copia de bajo nivel de cualquier volumen:
docker run --rm -v myproject_db-data:/data:ro -v "$(pwd)":/backup alpine tar czf /backup/db-data-backup.tar.gz -C /data .
Y para restaurar en un volumen vacío:
docker volume create myproject_db-datadocker run --rm -v myproject_db-data:/data -v "$(pwd)":/backup:ro alpine tar xzf /backup/db-data-backup.tar.gz -C /data
Ojo con un detalle: no copies archivos de una base de datos activa mientras el motor está escribiendo. En desarrollo puede sacarte de un apuro, pero en producción conviene pg_dump, snapshots consistentes o la herramienta oficial del motor que estés usando. La diferencia entre ambos métodos no es de preferencia: pg_dump entiende la estructura lógica de la base y genera un dump consistente aunque haya transacciones en curso, mientras que copiar archivos con tar asume que nadie está escribiendo en ese instante, algo que rara vez podés garantizar en un sistema productivo.
¿Qué hace docker compose down -v exactamente?
docker compose down -v borra contenedores, redes y además los named volumes declarados en ese proyecto. Es distinto de docker compose down sin el flag, que solo elimina contenedores y redes y deja los volúmenes intactos. Ese -v es chico, silencioso y destructivo, como un botón rojo sin tapa de seguridad.
| Comando | Qué hace |
|---|---|
docker compose stop | Detiene contenedores, no borra nada |
docker compose down | Borra contenedores y redes, conserva named volumes |
docker compose down -v | Borra contenedores, redes y volúmenes del proyecto |
docker volume rm <nombre> | Borra un volumen específico, puntual |
docker volume prune | Borra volúmenes sin ningún contenedor que los use |
docker volume prune pide confirmación, pero no sabe cuál de esos volúmenes era importante para el proyecto. Solo sabe si hay un contenedor usándolo en ese momento, lo cual deja afuera a cualquier volumen que pertenecía a un servicio que apagaste hace semanas pero todavía no borraste del Compose.
Errores comunes con volúmenes en Docker Compose
- Usar down -v como “limpieza general”: borra named volumes sin querer. Reservalo para cuando de verdad querés resetear datos, no como costumbre al terminar de trabajar.
- Guardar datos importantes en un anonymous volume: sin nombre estable, vas a terminar adivinando cuál ID tiene qué en
docker volume ls. Si el dato importa, nombralo con un named volume. - Confundir persistencia con backup: un volumen que sobrevive a
docker compose downno te salva de undown -v, de un error manual ni de un script con demasiada confianza. Para eso hace faltapg_dumpu otra herramienta dedicada. - Montar código fuente en producción: un bind mount que funciona en tu laptop puede no existir en el servidor. El resultado es un deploy roto por una ruta que no está en ningún lado más que en tu máquina.
- Esperar que un init script corra de nuevo: si editaste el SQL de inicialización y el volumen ya tenía datos, no se vuelve a ejecutar. Hay que borrar el volumen con
down -va propósito para probar el cambio. - No evaluar qué dato “descartable” dejó de serlo: como en el ejemplo hipotético de Redis usado para colas, un recurso que empezó como caché puede volverse crítico sin que nadie actualice el
docker-compose.ymlpara reflejarlo.
Preguntas Frecuentes
¿Por qué se pierde la base de datos al borrar un contenedor Docker?
Se pierde porque los datos vivían en la capa de escritura del contenedor, que se elimina junto con docker rm. Si esos datos estaban en un named volume declarado en Compose, en cambio, sobreviven porque el volumen no depende del ciclo de vida del contenedor.
¿Cuál es la diferencia entre named volume y bind mount?
Un named volume lo gestiona Docker y no depende de una ruta del host, ideal para datos persistentes. Un bind mount monta una carpeta real de tu máquina o servidor, ideal para desarrollo con hot reload, pero rompe si esa ruta no existe donde se ejecuta el contenedor.
¿Cómo hago backup de un volumen de Docker Compose?
Para bases de datos, lo correcto es usar la herramienta propia del motor, como pg_dump ejecutado dentro del contenedor con docker compose exec. Para un backup de bajo nivel de cualquier volumen, se usa un contenedor temporal de Alpine con tar czf apuntando al volumen montado en modo solo lectura.
¿Qué hace docker compose down -v exactamente?
docker compose down -v borra contenedores, redes y los named volumes declarados en ese proyecto Compose. Sin el flag -v, el comando down borra contenedores y redes pero conserva los volúmenes intactos.
¿Cómo persisto los datos de Postgres o MySQL en Docker Compose?
Montás un named volume en la ruta donde cada motor guarda sus archivos: /var/lib/postgresql/data para Postgres y /var/lib/mysql para MySQL. El path cambia según la imagen, pero el patrón de declarar el volumen en esa carpeta específica es siempre el mismo.
Conclusión
Los volúmenes docker compose no son un detalle de configuración más: son la línea que separa un contenedor descartable de un dato que necesitás conservar. La clave práctica queda clara después de recorrer todo esto: named volumes para lo que importa, bind mounts solo en desarrollo, nunca confundir persistencia con backup, y revisar dos veces antes de tipear ese -v que borra todo sin aviso previo más allá de la confirmación.
Si estás armando un stack con base de datos en Compose, el checklist mínimo es: declarar el volumen en la ruta correcta según el motor, separar archivos dev/prod con -f, correr los criterios de decisión de este artículo sobre cada servicio (no solo sobre la base de datos principal) y automatizar al menos un pg_dump periódico antes de confiar en que “el volumen ya se encarga”. No se encarga de todo. Nunca lo hizo.