Reconstruyó un servidor y se reinfectó en 6 horas
En pocas palabras: Se reinfectó porque el rebuild volvió a instalar la misma versión vulnerable de Next.js, afectada por GHSA-9qr9-h5gf-34mp (CVSS 10.0), una deserialización insegura en RSC Flight. Escáneres automáticos explotaron la falla sin autenticación unas 6 horas después del redeploy, antes de aplicar el parche.
Un equipo reconstruyó desde cero un servidor Linux con Next.js y Strapi después de encontrar un criptominero activo. Seis horas más tarde, el sitio volvió a infectarse. La causa no fue una brecha nueva: el rebuild reinstaló la misma versión vulnerable de Next.js, afectada por una vulnerabilidad crítica de Next.js catalogada como GHSA-9qr9-h5gf-34mp, con CVSS 10.0.
GHSA-9qr9-h5gf-34mp es el identificador de una vulnerabilidad crítica de Next.js registrada también como CVE-2025-55182 en React y CVE-2025-66478 en Next.js (este último rechazado como duplicado del primero). Es una deserialización insegura en el protocolo RSC Flight que permite ejecución remota de código sin autenticación, confirmada por GitHub Security Advisories y por Unit 42 de Palo Alto Networks. Afecta Next.js 15.x y 16.x con App Router, incluso en su configuración por defecto.
En este artículo:
- En 30 segundos
- ¿Qué vulnerabilidad de Next.js explicó la reinfección del servidor?
- ¿Cómo se detectó el primer compromiso del servidor?
- ¿Qué pasos se siguieron para contener y reconstruir el servidor?
- ¿Qué medidas de hardening se aplicaron después del rebuild?
- ¿Por qué volvió a infectarse el servidor seis horas después?
- ¿Cómo se confirmó la causa real con npm audit?
- ¿Qué aprendizajes deja este incidente para quienes usan Next.js o Strapi en producción?
- ¿Qué está confirmado y qué no sobre esta vulnerabilidad crítica de Next.js?
- Errores comunes al responder a un servidor comprometido con Next.js
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El rebuild no alcanzó: el servidor se reinfectó unas 6 horas después de reconstruirlo porque el despliegue volvió a instalar la misma versión vulnerable de Next.js.
- La falla tiene nombre y número: GHSA-9qr9-h5gf-34mp / CVE-2025-55182, CVSS 10.0, RCE no autenticado en el protocolo Flight de React Server Components.
- El exploit es casi infalible: según Unit 42, la confiabilidad es cercana al 100% y no requiere cambios de código contra configuraciones por defecto.
- El alcance es masivo: Cortex Xpanse de Palo Alto Networks detectó más de 968.000 instancias de React y Next.js expuestas en su telemetría.
- El comando que destapó todo:
npm auditfue lo único que confirmó la versión vulnerable desplegada, después de descartar teorías de credenciales robadas y dependencias envenenadas.
¿Qué vulnerabilidad de Next.js explicó la reinfección del servidor?
La vulnerabilidad crítica de Next.js que explicó todo el episodio es GHSA-9qr9-h5gf-34mp, una falla de deserialización insegura en el paquete react-server que procesa el protocolo Flight de React Server Components. Los investigadores la revelaron públicamente el 3 de diciembre de 2025, con una calificación CVSS de 10.0, el máximo posible.
El fallo afecta a React 19.0, 19.1 y 19.2, puntualmente a los paquetes react-server-dom-webpack, react-server-dom-parcel y react-server-dom-turbopack en sus versiones 19.0.0, 19.1.0, 19.1.1 y 19.2.0. En el lado de los frameworks, pega de lleno en Next.js 15.x y 16.x con App Router, y también en builds Canary desde la 14.3.0-canary.77. React Router, Waku, RedwoodSDK y los plugins RSC de Parcel y Vite quedan en la misma bolsa, porque todos empaquetan la misma implementación vulnerable.
| Componente | Versiones afectadas | Versión parcheada |
|---|---|---|
| React | 19.0, 19.1, 19.2 | 19.0.1, 19.1.2, 19.2.1 |
| Next.js (rama 16) | 16.x App Router | 16.0.7 |
| Next.js (rama 15) | 15.0 a 15.5 | 15.0.5, 15.1.9, 15.2.6, 15.3.6, 15.4.8, 15.5.7 |
¿Cómo se detectó el primer compromiso del servidor?
El primer compromiso del servidor, descripto en el relato publicado en dev.to, salió a la luz durante un chequeo de rutina. La máquina era un contenedor Linux chico corriendo un sitio marketing con Next.js y una CMS Strapi, ambos manejados por PM2.
Lo que encontraron no era poca cosa. Un criptominero corría desde /tmp al 200% de CPU hacía unos cinco días, hablando con un pool de minería por el puerto 33333. Había un binario con permisos de escritura para cualquier usuario en /usr/sbin, registrado como servicio systemd, con una conexión abierta por el puerto 443 (casi seguro, comando y control). Y el root crontab recreaba un usuario UID-0 oculto cada 30 minutos, reiniciaba un contenedor Docker escondido y, a medianoche, bajaba un script fresco de internet para pasarlo por /bin/sh usando curl, wget, python3 o perl, lo que estuviera disponible.
Ese último detalle fue el que definió la estrategia. Cualquier limpieza en caliente se habría borrado sola a las 00:00.
¿Qué pasos se siguieron para contener y reconstruir el servidor?
La respuesta siguió cuatro pasos: contener, preservar, rotar y reconstruir. Primero se bajó la interfaz de red del contenedor desde adentro, aprovechando que en Proxmox los comandos pct exec y pct pull pasan por el host, así que se pudo seguir trabajando sin conexión. Te puede servir nuestra cobertura de cómo comprometieron tags de Trivy en CI/CD.
Después se extrajeron los datos de la aplicación a través del host y se tomó un backup forense completo del contenedor, con el malware adentro, guardado offline. Se rotaron todos los secretos que habían vivido en esa máquina: la contraseña del rol de base de datos y todas las claves de firma del CMS.
El contenedor se destruyó y se reconstruyó con la misma dirección, esta vez sin soporte de Docker-in-container (que el sitio nunca necesitó), con SSH solo por clave y firewall a nivel de host. Horas después llegó el hardening serio.
¿Qué medidas de hardening se aplicaron después del rebuild?
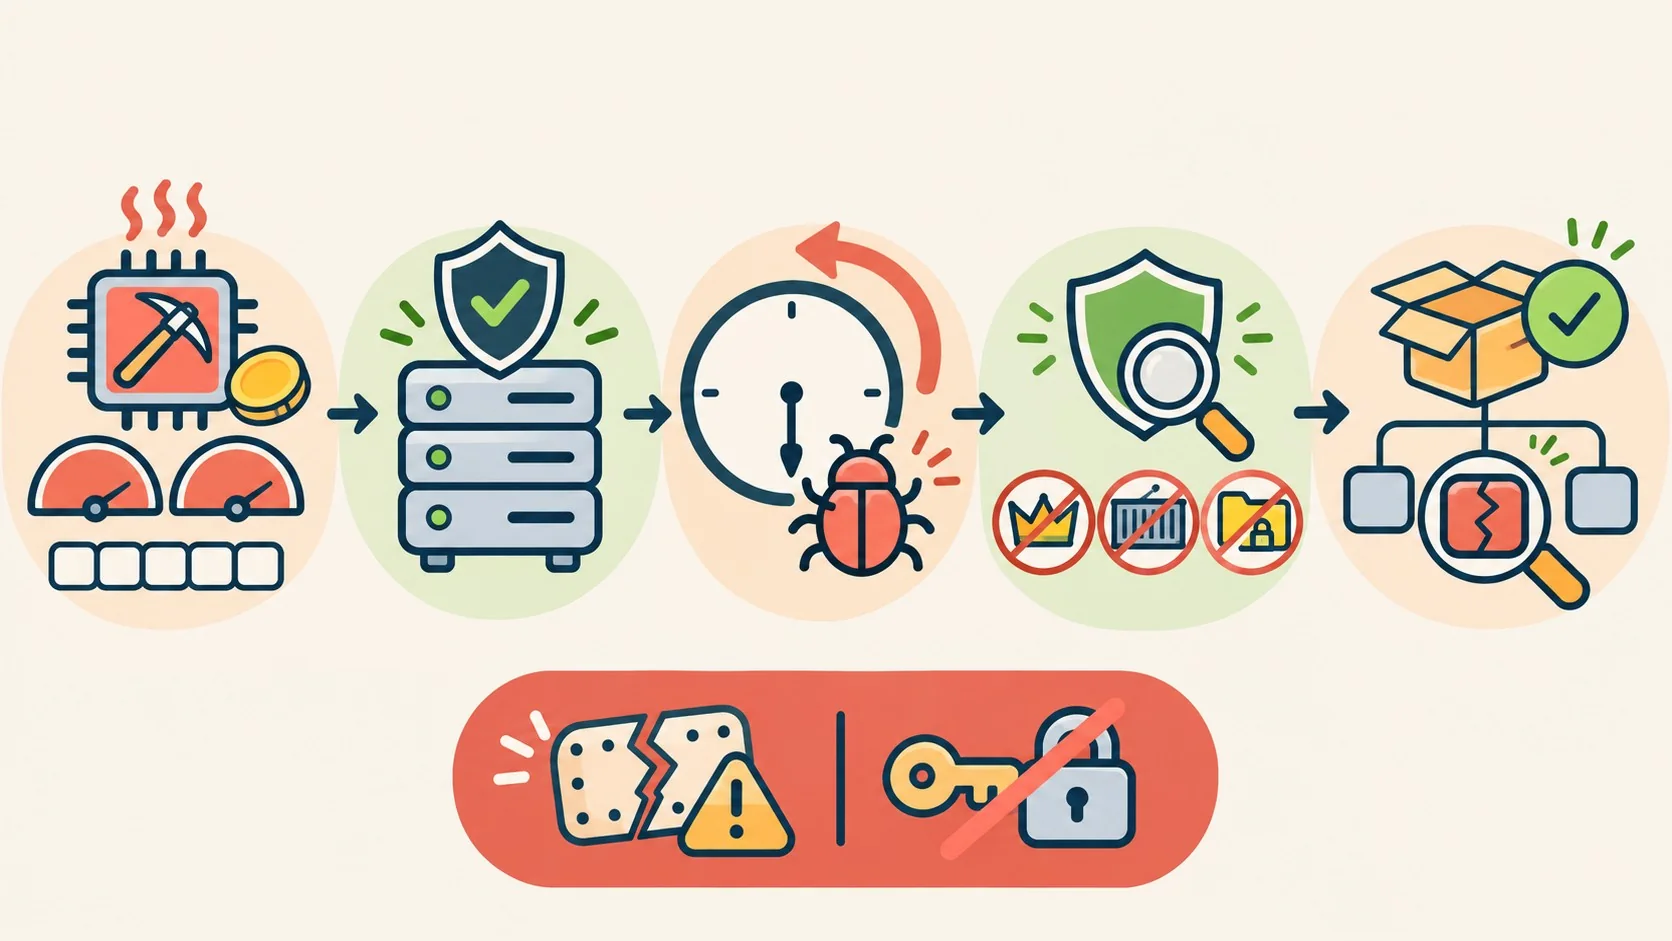
El hardening posterior al rebuild tuvo cuatro capas concretas, pensadas para que un segundo compromiso no escalara a root. Esa combinación fue justamente la que después terminó salvando la papeleta.
- Sin root en runtime: la app pasó del PM2 de root a un usuario sin privilegios llamado app, y se le sacó la regla de sudo sin contraseña.
- Nada se ejecuta desde temp:
/tmpy/var/tmpse montaron como tmpfs noexec, configurado a nivel hipervisor porque un contenedor sin privilegios no puede remontarlos solo. - Filtrado de salida: el tráfico saliente quedó en default-deny, con lista blanca de DNS, HTTP/S, NTP, mail y el endpoint de base de datos.
- Chequeos de integridad: un timer cada 15 minutos vigila usuarios UID-0 nuevos, crontabs extraños y binarios de Docker reapareciendo.
El sitio volvió y todos los chequeos pasaron. Pero eso no fue el final de la historia.
¿Por qué volvió a infectarse el servidor seis horas después?
El servidor se reinfectó porque el rebuild volvió a desplegar la misma versión vulnerable de Next.js, y los scanners automáticos que rastrean un RCE público encuentran sitios expuestos muy rápido. Dos días después del rebuild había un miner corriendo desde el home del usuario app, con un segundo miner preparado en /tmp. Ya lo cubrimos antes en nuestra guía completa de seguridad y vulnerabilidades.
¿El crontab de app tenía el mismo patrón de persistencia de la primera vez? Exacto: crear el usuario root oculto, levantar el contenedor escondido. Los logs mostraban que esa entrada de cron venía disparando cada 30 minutos desde unas seis horas después del rebuild.
El tema es que esta vez el ataque casi no logró nada.
| Síntoma observado | Explicación |
|---|---|
| No hay registros de login | Fue un exploit HTTP, no un inicio de sesión |
| Compromiso limitado al usuario app | Es exactamente el privilegio con el que corre el proceso Next.js |
| Reinfección ~6 horas después del rebuild | El rebuild redesplegó la misma versión vulnerable y los scanners de un RCE público son rápidos |
El usuario root oculto nunca se creó, porque app ya no tenía sudo. El contenedor escondido nunca arrancó, porque no había Docker en la máquina. El miner guardado en /tmp no pudo correr, porque /tmp era noexec. Ninguna sesión SSH apareció en los registros. El hardening hizo su trabajo: el atacante quedó atascado en el nivel de privilegio de la aplicación. Algo, sin embargo, seguía dejándolo entrar.
¿Cómo se confirmó la causa real con npm audit?
La causa real se confirmó corriendo npm audit sobre el frontend desplegado, que reveló una versión de Next.js dentro del rango vulnerable de GHSA-9qr9-h5gf-34mp. Antes de llegar ahí, se probaron dos teorías más vistosas que no llevaron a ningún lado.
La primera teoría apuntaba a credenciales robadas, porque en paralelo habían encontrado malware en una estación de trabajo administrativa. Esa hipótesis explicaba la ausencia de registros de login, ya que los comandos ejecutados desde el hipervisor no aparecen en el historial del contenedor. No se pudo probar ni descartar con los logs disponibles.
La segunda teoría era una dependencia npm envenenada. Nada había cambiado en los árboles de node_modules desde la instalación del rebuild, y el único script postinstall era uno benigno y conocido. Entonces llegó el comando que debería haberse corrido primero: npm audit, el que terminó explicando todo en segundos. Encima, el CMS Strapi tenía sus propios advisories críticos, incluida una inyección SQL, y recibió el mismo tratamiento de parcheo. Relacionado: la falla crítica del SonicWall SMA1000.
¿Qué aprendizajes deja este incidente para quienes usan Next.js o Strapi en producción?
El aprendizaje central es que un rebuild limpio de una aplicación vulnerable sigue siendo una aplicación vulnerable. Reconstruir el servidor resuelve la persistencia del malware, pero si el código que se vuelve a desplegar tiene el mismo agujero, ese agujero vuelve con él.
Antes de redesplegar después de un incidente, hay que auditar las versiones exactas que se van a subir, no solo el servidor que las corre. Conviene priorizar la explicación barata (un RCE público conocido) antes de teorías más complejas como credenciales robadas: npm audit tarda segundos y, en este caso, fue la respuesta correcta desde el primer momento. El defense in depth (usuario sin root, sin sudo, sin Docker, temp noexec, filtrado de egreso) compró tiempo y convirtió un segundo compromiso root en una molestia contenida a nivel aplicación, pero no sustituyó al parche.
Hay un detalle operativo que se repite en este tipo de incidentes: un hotfix en el servidor no es un fix en el repositorio. Si la actualización de versión no se commitea, el próximo deploy del pipeline reinstala la versión vulnerable sin que nadie lo note. Esa entrega a los desarrolladores importa tanto como el parche en sí. Mirá también cómo robaron cuentas admin en LogixFast Auth.
¿Qué está confirmado y qué no sobre esta vulnerabilidad crítica de Next.js?
Está confirmado, según GitHub Security Advisories y Unit 42, que GHSA-9qr9-h5gf-34mp es un RCE no autenticado con CVSS 10.0 en el protocolo Flight, que afecta Next.js 15.x y 16.x con App Router, y que ya existen versiones parcheadas disponibles. Ampliamos el tema en la vulnerabilidad crítica en el plugin Prime Mover.
Lo que no está confirmado de forma general es si el caso del servidor relatado en dev.to corresponde exactamente a la explotación masiva documentada por Unit 42, que incluyó criptominería, Cobalt Strike, los backdoors KSwapDoor y Auto-color, y actividad vinculada a los clústeres UNC5342 y CL-STA-1015. El propio autor del incidente no atribuye el ataque a un grupo específico, y eso hay que tomarlo con pinzas: la reinfección con un miner es coherente con la ola de explotación oportunista descripta por Unit 42, pero no hay una prueba forense pública que una ambos casos punto por punto. Esto se conecta con lo que analizamos en los parches recientes de Cisco IOS XR.
Errores comunes al responder a un servidor comprometido con Next.js
- Reconstruir sin auditar versiones: rehacer el servidor desde una imagen limpia no sirve de nada si el deploy vuelve a instalar el mismo Next.js vulnerable. El paso de npm audit tiene que ser parte del checklist de rebuild, no una ocurrencia tardía.
- Asumir que el ataque fue por credenciales: es tentador pensar en algo sofisticado cuando en realidad la explicación más probable es un RCE público conocido, con exploits circulando y confiabilidad cercana al 100% según las pruebas de Unit 42.
- Confundir hotfix con fix: aplicar el parche a mano en el servidor sin commitear el cambio en el repositorio deja la puerta abierta para que el próximo deploy automático reinstale la versión rota.
- Ignorar señales simples de CPU: el primer miner corrió cinco días al 200% de CPU sin que nadie lo notara. Una alerta básica de CPU sostenida lo hubiera detectado el día uno.
Preguntas Frecuentes
¿Por qué se reinfectó el servidor después de reconstruirlo desde cero?
Se reinfectó porque el rebuild reinstaló la misma versión vulnerable de Next.js, afectada por GHSA-9qr9-h5gf-34mp. Un servidor limpio con código vulnerable sigue siendo vulnerable, y los scanners automáticos para RCE públicos encuentran sitios expuestos en cuestión de horas.
¿Qué es la vulnerabilidad GHSA-9qr9-h5gf-34mp de Next.js?
Es una falla crítica (CVSS 10.0) de deserialización insegura en el protocolo Flight de React Server Components, registrada como CVE-2025-55182 en React. Permite ejecución remota de código sin autenticación en Next.js 15.x y 16.x con App Router, incluso en configuraciones por defecto.
¿Cómo detectar si mi aplicación Next.js tiene una vulnerabilidad crítica?
Corriendo npm audit contra lo que está desplegado en producción, no contra lo que figura en el repositorio. Si la versión instalada cae dentro del rango afectado por GHSA-9qr9-h5gf-34mp, hay que actualizar a 16.0.7, 15.5.7, 15.4.8, 15.3.6, 15.2.6, 15.1.9 o 15.0.5 según la rama que uses.
¿Qué hace npm audit y por qué es importante correrlo en producción?
npm audit revisa las dependencias instaladas contra bases de datos de vulnerabilidades conocidas y marca las versiones afectadas. En este caso fue el único comando que confirmó, en segundos, que el Next.js desplegado estaba dentro del rango vulnerable, después de haber descartado teorías más complejas sin resultado.
¿Cómo proteger un servidor Linux contra criptomineros y persistencia de malware?
Con capas combinadas: correr la app sin root ni sudo, montar /tmp y /var/tmp como noexec, filtrar el tráfico saliente en default-deny con lista blanca, y monitorear señales de persistencia como usuarios UID-0 nuevos o crontabs inesperados. Ninguna de estas capas reemplaza parchear la vulnerabilidad de origen, pero reduce el daño mientras se aplica el fix. Si administrás infraestructura propia para estos sitios, un proveedor con buen soporte en incidentes como donweb.com ayuda a reducir el tiempo de respuesta ante este tipo de episodios.
Conclusión
Lo que cambió con este caso es simple de nombrar y difícil de ejecutar bien: un incident response no termina en el rebuild. Mientras no se audite la versión exacta del código que se va a desplegar, una reconstrucción perfecta del servidor puede reinstalar el mismo problema en minutos.
Si administrás Next.js o Strapi expuestos a internet, el checklist mínimo después de hoy es correr npm audit contra lo que está corriendo en producción ahora mismo, confirmar que la versión no cae en el rango de GHSA-9qr9-h5gf-34mp, y recién después pensar en teorías más exóticas de compromiso. El hardening en capas (sin root, sin sudo, temp noexec, egress filtering) no es opcional tampoco: fue lo que contuvo el segundo ataque a nivel aplicación en vez de dejarlo escalar otra vez a root.