Arquitectura de aplicaciones escalables: Docker a Kafka
En pocas palabras: Una aplicación escalable moderna combina Docker para empaquetar, Kubernetes (estándar desde que Google lo liberó en 2014) u ECS para orquestar, PostgreSQL y Redis para datos y caché, Kafka para distribuir eventos entre servicios, y Prometheus para monitorear todo en producción.
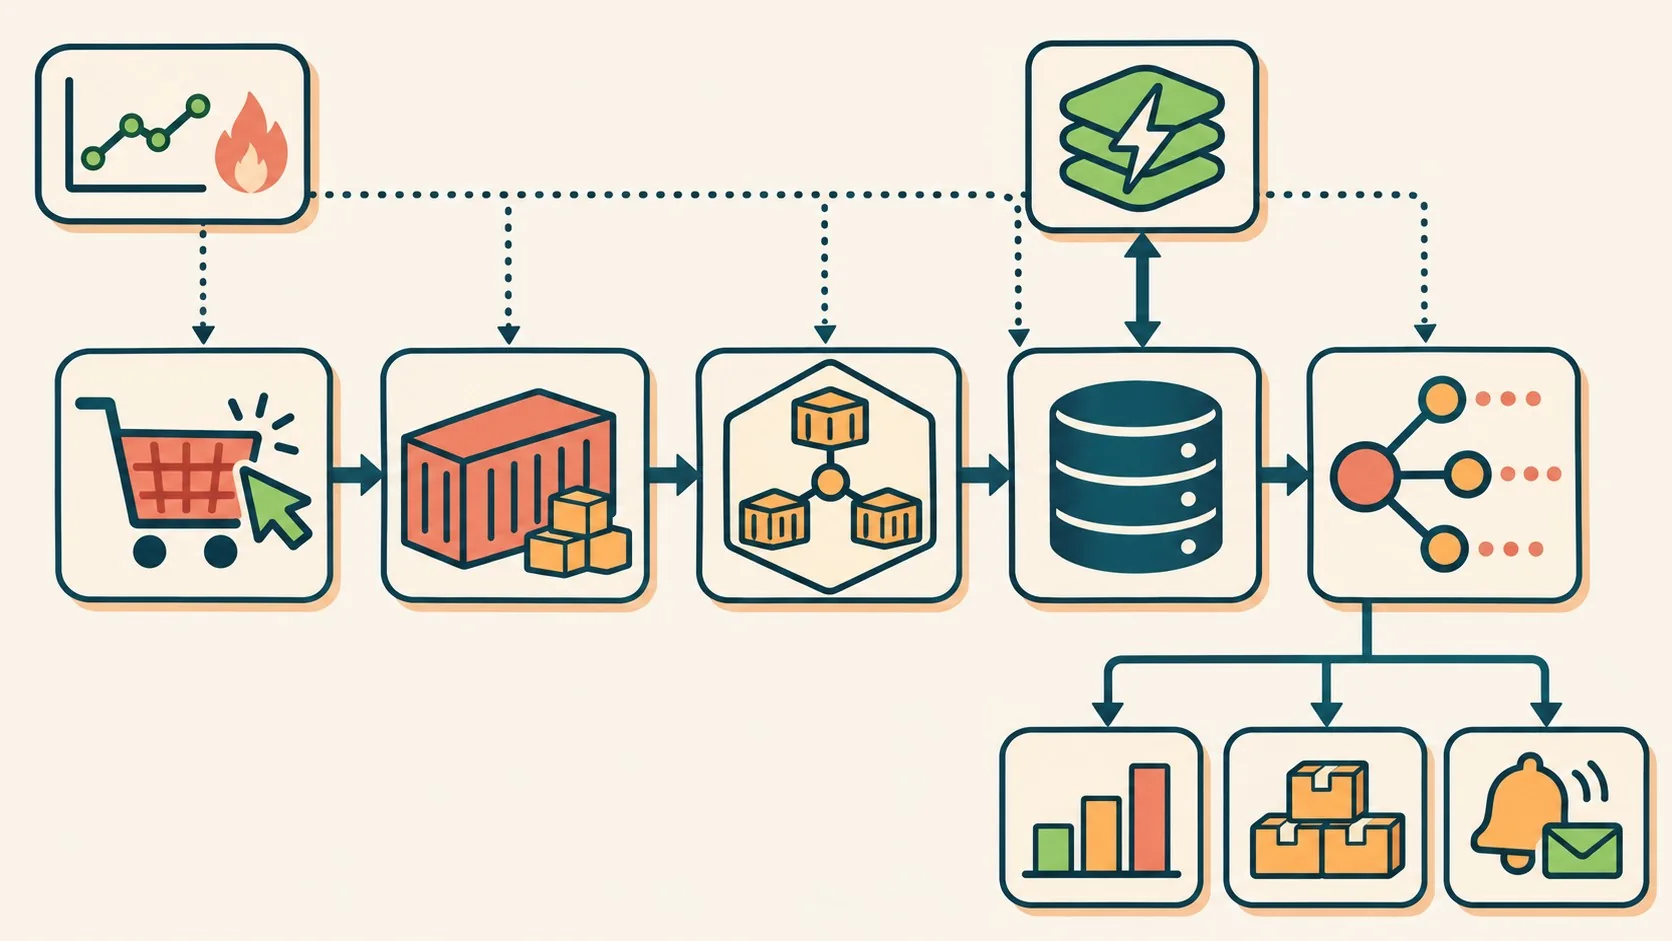
Un e-commerce que recibe un pedido activa al menos seis piezas distintas: Docker empaqueta la app, Kubernetes o ECS la orquestan, PostgreSQL guarda la orden, Redis cachea el producto, Kafka distribuye el evento a inventario y analytics, y Prometheus monitorea todo el circuito en producción.
La arquitectura de aplicaciones escalables es el conjunto de decisiones técnicas que permiten que un sistema soporte más usuarios, más datos y más carga sin reescribirse desde cero. No es un paquete único: combina empaquetado de contenedores, orquestación, bases de datos, caché, mensajería y observabilidad, elegidos según el problema real que tenga cada equipo, no según la moda del momento.
En este artículo:
- En 30 segundos
- ¿Por qué una app funciona en desarrollo y falla en producción?
- Docker vs Kubernetes: ¿qué hace cada uno?
- ¿ECS o Kubernetes? Cómo elegir el orquestador de contenedores
- ¿Para qué sirve Redis como caché y qué riesgos tiene?
- ¿Cuál es la diferencia entre una cola de mensajes y Kafka?
- ¿Qué mide Prometheus y por qué es clave para la observabilidad?
- ¿Cómo se conectan todos estos componentes en una compra real?
- Errores comunes al armar esta arquitectura
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Docker empaqueta la app y sus dependencias en una imagen, pero no gestiona un ejército de contenedores en producción.
- Kubernetes nació en Google en 2014 y hoy es el estándar de orquestación, según detalla la guía de Atlassian.
- Redis reduce la carga sobre PostgreSQL con el patrón cache-aside, pero mete el problema de invalidación de caché.
- Kafka procesa más de un millón de mensajes por segundo y puede manejar trillones de mensajes por día, según Confluent.
- ECS es más simple si ya estás 100% en AWS; Kubernetes gana cuando necesitás portabilidad multi-cloud.
¿Por qué una app funciona en desarrollo y falla en producción?
Falla porque el entorno de producción no es idéntico al de tu laptop: distinta versión de runtime, una librería que falta, una dependencia con otra versión. Docker resuelve esto empaquetando la app junto con todo lo que necesita para correr dentro de una imagen, según explica el análisis técnico de Naimul Karim.
Dos términos para no confundir: la imagen es el template empaquetado, y el contenedor es la instancia corriendo de esa imagen. La misma imagen puede usarse en desarrollo, testing, staging y producción, lo que ayuda a que esos entornos se comporten parecido.
Ojo con esto: una imagen de contenedor no uniformiza todo. Si construiste la imagen para una arquitectura de CPU y la corrés en otra, no va a andar nativamente. Para eso existen los builds multi-plataforma, que generan la misma imagen compilada para distintas arquitecturas. Esto se conecta con lo que analizamos en cómo evolucionaron los precios de Google Cloud.
Docker resuelve el empaquetado. No gestiona una flota de contenedores por sí solo, y ahí entra la orquestación.
Docker vs Kubernetes: ¿qué hace cada uno?
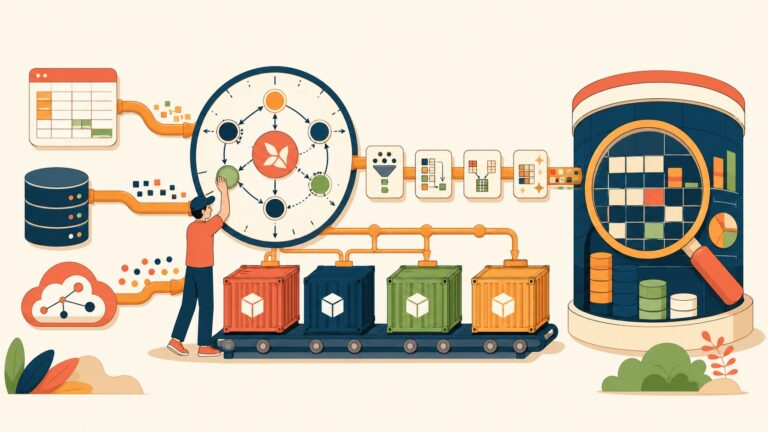
Docker empaqueta y ejecuta contenedores individuales; Kubernetes orquesta flotas enteras de contenedores distribuidos en múltiples servidores. No compiten entre sí: son capas distintas del mismo problema, y de hecho Kubernetes puede correr contenedores de Docker como una de sus opciones de runtime.
Cuando una app crece y empieza a correr en varios servidores, aparecen preguntas que Docker solo no responde. ¿Cómo coordinás varios contenedores entre sí? ¿Cómo escalás instancias cuando sube el tráfico? ¿Qué pasa si un contenedor se cae a las 3 de la mañana? Para eso existe la orquestación.
Kubernetes agrupa contenedores en pods, la unidad básica de gestión, y automatiza el descubrimiento de servicios, el balanceo de carga dentro del clúster y el reinicio de contenedores que fallan, según detalla Atlassian. Lo describen como “el Linux de la nube”, y la comparación no es gratuita: así como Linux abstrae el hardware, Kubernetes abstrae la infraestructura de cómputo, red y almacenamiento para que el equipo de desarrollo se concentre en escribir código de aplicación.
¿ECS o Kubernetes? Cómo elegir el orquestador de contenedores
Ni ECS ni Kubernetes son “mejores” en abstracto: la elección depende de cuánta complejidad operativa tu equipo está dispuesto a manejar, no de cuál es más popular. Amazon ECS es un servicio gestionado por AWS, así que buena parte de la infraestructura de orquestación la maneja Amazon. Kubernetes es open source y corre en cualquier cloud o en on-premise, pero esa flexibilidad viene con responsabilidad: alguien tiene que gestionar nodos worker, networking, add-ons y configuración del clúster. En una demo práctica de microservicios en Kubernetes profundizamos sobre esto.
Subís la app, la probás en local, funciona bárbaro, la mandás a producción con ECS porque ya estaba todo en AWS y dos años después necesitás portar parte de la carga a otro proveedor y ahí te das cuenta de que migrar fuera de ECS no es trivial, mientras que con Kubernetes esa portabilidad venía incluida desde el día uno (al costo de una curva de aprendizaje más empinada).
| Criterio | Amazon ECS | Kubernetes |
|---|---|---|
| Modelo operativo | Gestionado por AWS | Requiere gestionar nodos, red y add-ons |
| Portabilidad | Atado al ecosistema AWS | Multi-cloud y on-premise |
| Curva de aprendizaje | Más simple de arrancar | Más difícil al principio |
| Ideal para | Equipos chicos 100% en AWS | Equipos con múltiples clouds o necesidad de control fino |
| Servicios gestionados | ECS nativo | Amazon EKS, Google Kubernetes Engine |
Una organización que ya opera principalmente en AWS puede preferir ECS por su modelo operativo más simple, según plantea el artículo de dev.to. Un equipo que necesita portabilidad, el ecosistema de Kubernetes o más control sobre la orquestación, probablemente elija Kubernetes aunque implique más trabajo operativo.
¿Para qué sirve Redis como caché y qué riesgos tiene?
Redis sirve para evitar que PostgreSQL repita el mismo trabajo miles de veces por minuto. Es un almacén de datos en memoria que funciona como caché: cuando muchos clientes piden la misma página de producto, en vez de que cada request golpee la base relacional, la app primero chequea Redis.
El patrón se llama cache-aside y funciona así:
- Lectura con hit: la app busca el dato en Redis; si está, lo devuelve directo, sin tocar PostgreSQL.
- Lectura con miss: si no está en caché, la app lee de PostgreSQL y guarda una copia en Redis para la próxima.
- PostgreSQL sigue siendo la fuente de verdad: Redis guarda copias temporales o reutilizables, no reemplaza a la base relacional.
¿Y qué pasa si el precio de un producto cambia en PostgreSQL mientras Redis todavía tiene el valor viejo? Exacto: la app devuelve información obsoleta. Este es el problema de invalidación de caché, y no tiene una solución única: según el caso, se puede borrar la entrada cacheada, actualizarla apenas cambia la base, o dejarla expirar después de un tiempo definido. El caching mejora performance, pero introduce un problema de consistencia que hay que diseñar a propósito, no improvisar.
¿Cuál es la diferencia entre una cola de mensajes y Kafka?
Una cola de mensajes (como Amazon SQS o RabbitMQ) sirve para delegar tareas en background a un worker; Kafka sirve para distribuir un mismo evento a múltiples consumidores independientes que lo procesan cada uno a su manera. No son intercambiables: resuelven problemas de mensajería distintos. Te puede servir nuestra cobertura de integrar modelos de IA en tus aplicaciones.
Ponele que guardás un pedido. Mandar el email de confirmación, generar la factura, avisar al depósito y registrar el evento de analytics no tienen por qué bloquear la respuesta al cliente. Ahí aparece la cola: el backend publica la tarea y responde sin esperar que termine cada proceso de fondo.
El tema es que un worker puede acknowledgear un mensaje después de procesarlo, y si se cae antes de confirmarlo, la cola puede volver a entregar ese mismo mensaje. Esto significa que un mensaje puede llegar más de una vez, así que los workers tienen que ser idempotentes: procesar la misma operación dos veces no debería generar un efecto duplicado no deseado (un worker de emails, por ejemplo, puede chequear si ya mandó la confirmación de ese pedido antes de reenviarla).
Kafka entra cuando el mismo evento necesita llegar a varios sistemas independientes a la vez: analytics registra la compra, inventario actualiza stock, notificaciones manda el mensaje, y un pipeline de reporting procesa todo en paralelo. Apache Kafka es una plataforma de streaming de eventos distribuida, de código abierto, que puede procesar más de un millón de mensajes por segundo con latencias tan bajas como 2 milisegundos, según Confluent, la empresa fundada por los creadores originales de Kafka.
Kafka se originó en LinkedIn en 2010, se abrió como open source en 2011 y pasó a la Apache Software Foundation en 2012, según el timeline que publica Confluent. Hoy lo usan bancos como JPMorgan Chase y retailers como Walmart para fraude en tiempo real y seguimiento de pedidos, de acuerdo con los casos reales que detalla IBM.
¿Qué mide Prometheus y por qué es clave para la observabilidad?
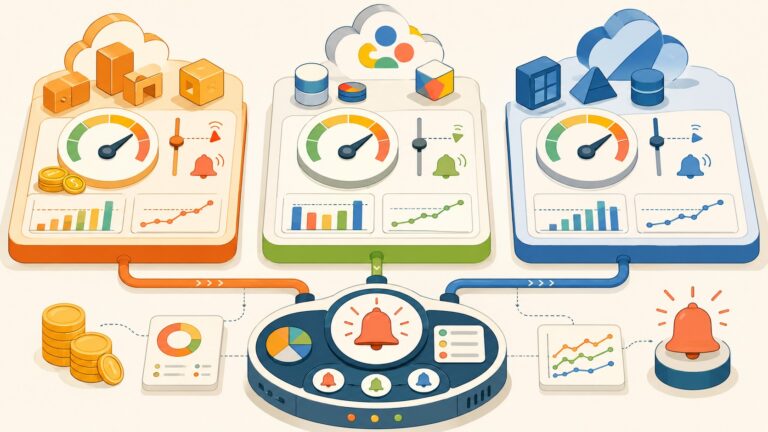
Prometheus mide métricas operativas de un sistema en producción: latencia, uso de recursos, salud de contenedores y servicios. Cuando una arquitectura tiene seis o siete componentes distintos corriendo en paralelo (Docker, Kubernetes, PostgreSQL, Redis, Kafka), alguien necesita saber si algo se está rompiendo antes de que el cliente lo note.
¿Alguien lo verificó de forma manual revisando logs uno por uno? No, eso no escala. La observabilidad se vuelve necesaria apenas la arquitectura crece en piezas móviles, porque cada componente nuevo es un punto más donde algo puede fallar sin que nadie se entere hasta que explota en producción. Tema relacionado: armar una arquitectura de producción en AWS.
¿Cómo se conectan todos estos componentes en una compra real?
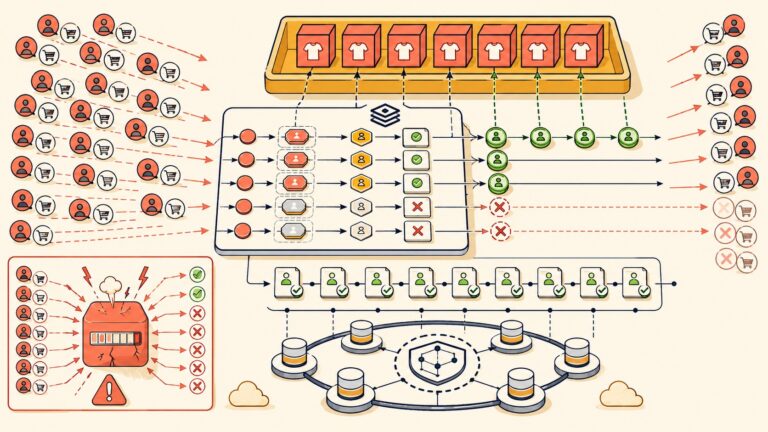
Un cliente hace clic en “Place Order” y ese click dispara una cadena completa: la request llega a un contenedor Docker corriendo en un pod de Kubernetes, el backend valida el pedido y lo guarda en PostgreSQL como fuente de verdad, consulta Redis para traer los datos del producto sin golpear la base de nuevo, y publica un evento en un tópico de Kafka que simultáneamente notifica a inventario, analytics y al servicio de notificaciones.
Ningún cliente ve nada de esto. Solo ve una confirmación en pantalla.
Lo interesante es que no toda app necesita las seis piezas desde el día uno. La arquitectura de aplicaciones escalables real empieza chica: Docker y una base relacional alcanzan para la mayoría de los proyectos nuevos. Redis se suma cuando el tráfico empieza a repetir las mismas consultas, Kafka cuando aparecen múltiples consumidores de un mismo evento, y Kubernetes cuando gestionar contenedores a mano se vuelve inviable. Si además necesitás infraestructura confiable para hostear todo esto, una base sólida con buen soporte técnico en Argentina, como la que ofrece donweb.com, te ahorra bastante dolor de cabeza en los primeros meses.
Errores comunes al armar esta arquitectura
- Meter Kubernetes antes de necesitarlo: si tu equipo tiene tres personas y la app corre en un solo servidor sin problemas de escala, Kubernetes agrega complejidad operativa que nadie va a mantener bien.
- No diseñar invalidación de caché desde el inicio: cachear sin pensar cuándo se borra o actualiza ese dato genera inconsistencias silenciosas que el cliente nota antes que vos.
- Confundir cola de mensajes con Kafka: usar Kafka para una tarea simple de background que resolvería SQS en cinco minutos es sobreingeniería pura.
- Ignorar la idempotencia en los workers: asumir que cada mensaje se procesa una sola vez rompe en el primer reintento de la cola, cuando el cliente recibe dos emails de confirmación del mismo pedido.
Preguntas Frecuentes
¿Qué es Docker y para qué sirve?
Docker es una plataforma de contenedorización que empaqueta una aplicación junto con sus dependencias de runtime en una imagen, para que corra igual en desarrollo, testing y producción. Resuelve el clásico problema de “funciona en mi máquina pero no en el servidor”, aunque no uniformiza arquitecturas de CPU distintas.
Esto se conecta con arquitectura con Docker y Kubernetes, donde cubrimos el tema en detalle.
¿Cuál es la diferencia entre Kubernetes y Amazon ECS?
Kubernetes es open source, corre en cualquier cloud y da más control pero requiere gestionar nodos y networking. Amazon ECS es un servicio gestionado por AWS, más simple de operar, pero atado al ecosistema de Amazon.
¿Por qué usar Redis si ya tengo PostgreSQL?
Redis reduce la carga sobre PostgreSQL cacheando datos que se consultan con frecuencia, como la info de un producto popular. PostgreSQL sigue siendo la fuente de verdad; Redis solo guarda copias temporales para responder más rápido.
¿Cuándo conviene usar Kafka en lugar de una cola de mensajes?
Kafka conviene cuando un mismo evento necesita llegar a múltiples consumidores independientes al mismo tiempo, como analytics, inventario y notificaciones procesando la misma compra. Una cola tradicional como SQS alcanza cuando solo necesitás delegar una tarea puntual a un worker en background.
¿Qué mide Prometheus en un sistema en producción?
Prometheus mide métricas operativas como latencia, uso de recursos y salud de contenedores en sistemas distribuidos. Se vuelve necesario apenas una arquitectura suma varios componentes corriendo en paralelo, porque revisar logs manualmente deja de ser viable.
Conclusión
La arquitectura de aplicaciones escalables no es una lista de tecnologías de moda que hay que sumar todas juntas. Es ir resolviendo problemas concretos a medida que aparecen: Docker cuando necesitás consistencia entre entornos, Kubernetes o ECS cuando gestionar contenedores a mano se vuelve inviable, Redis cuando las consultas repetidas empiezan a pesar, Kafka cuando un evento necesita múltiples consumidores, y Prometheus cuando ya tenés suficientes piezas móviles como para necesitar visibilidad real de qué está pasando.
Si estás arrancando un proyecto nuevo, no arranques por Kubernetes ni por Kafka. Arrancá por lo que resuelve el problema que tenés hoy, y sumá complejidad solo cuando el tráfico o el equipo te lo exijan de verdad.