Bring Your Own Database Webhooks en PostgreSQL (2026)
En pocas palabras: Un esquema BYO guarda el payload crudo como bytea en el PostgreSQL del cliente y expone solo metadata (job_id, status, timings) al relay. Con FOR UPDATE SKIP LOCKED (PostgreSQL 9.5+) y roles de columna específicos, se logra entrega at-least-once sin broker externo, reduciendo el alcance de HIPAA, GDPR y PCI DSS.
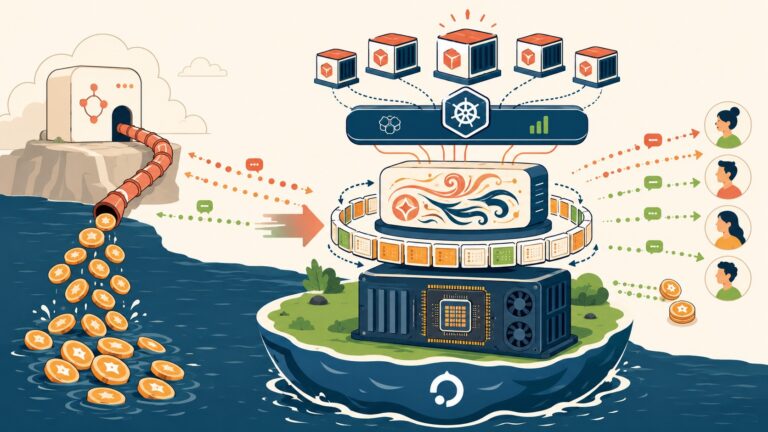
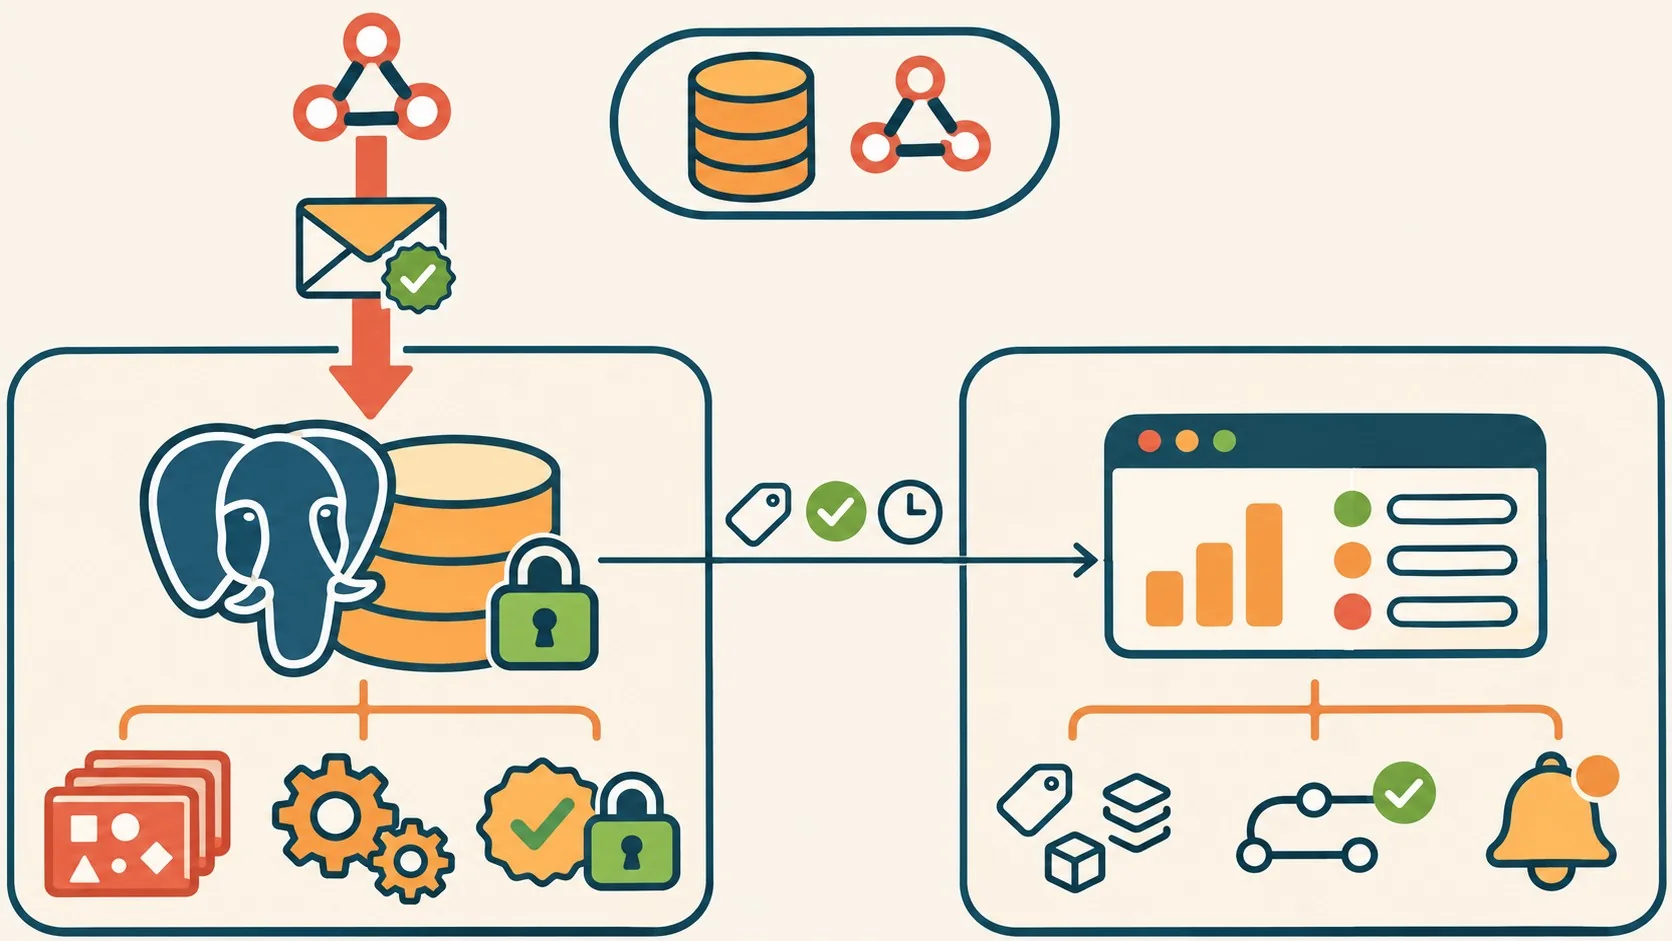
El patrón bring your own database webhooks separa el almacenamiento del payload crudo de la orquestación operativa: el cuerpo firmado vive en un PostgreSQL que controla el cliente, mientras el relay solo ve metadata (job_id, status, timings). Así se reduce el alcance de compliance bajo HIPAA, GDPR y PCI DSS.
En este artículo:
- En 30 segundos
- ¿Qué problema de cumplimiento resuelve separar el almacenamiento de la orquestación de webhooks?
- ¿Qué es el patrón bring your own database para webhooks y en qué se diferencia de un router hosted?
- ¿Cómo se diseña el esquema de PostgreSQL para eventos y trabajos de webhooks?
- ¿Por qué el cuerpo raw del webhook se guarda como bytea y no como JSONB?
- ¿Cómo funciona FOR UPDATE SKIP LOCKED para encolar trabajos sin Redis?
- ¿Qué roles y permisos mínimos necesita este patrón en PostgreSQL?
- ¿Qué metadata puede ver la capa de orquestación y qué nunca debe recibir?
- ¿Cuáles son los límites reales del patrón bring your own database?
- BYO database vs router hosted: tabla comparativa
- Errores comunes al implementar bring your own database para webhooks
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El payload crudo (los bytes exactos firmados por el proveedor) se guarda solo en el PostgreSQL del cliente, nunca en el datastore multi-tenant de la capa de orquestación.
- La verificación de firma de Stripe usa el header
Stripe-Signaturejunto con un timestamp para confirmar que el request vino de Stripe, según la documentación oficial de Stripe. FOR UPDATE SKIP LOCKED, disponible desde PostgreSQL 9.5, permite armar una cola de trabajos sin Redis ni broker externo.- Los roles
webhook_ingress_writerywebhook_workerreciben permisos de columna específicos: el worker solo puede tocarstatus,lease_holder_idy los campos de reintento. - El esquema da entrega at-least-once, no exactly-once: los handlers tienen que ser idempotentes porque un worker lento puede seguir procesando cuando su lease ya venció.
Bring Your Own Database (BYODB) es un patrón de arquitectura para la ingesta de webhooks en el que el payload crudo (headers, firma, cuerpo en bytes) se persiste únicamente en una base PostgreSQL que controla el cliente, nunca en el datastore multi-tenant del proveedor de orquestación. La capa de control (routing, reintentos, alertas) opera solo con metadata operativa, según describe la guía técnica publicada en dev.to el 5 de noviembre de 2026.
¿Qué problema de cumplimiento resuelve separar el almacenamiento de la orquestación de webhooks?
Resuelve algo concreto: cuando un proveedor externo guarda o procesa datos regulados en tu nombre, ese proveedor entra en tu alcance de cumplimiento, aunque vos nunca dejes de ser responsable. Bajo HIPAA eso implica un business associate agreement con el vendor. Bajo GDPR, un data processing agreement. Y PCI DSS aplica a cualquier sistema que almacene, procese o transmita datos de tarjetas, sin importar si es “solo de paso”.
El enfoque tradicional es un router hosted: recibe los requests, guarda los cuerpos en un datastore multi-tenant compartido y corre el procesamiento ahí mismo (práctico, hasta que el equipo de seguridad pregunta quién tiene acceso a esos payloads). Muchos equipos de seguridad se resisten a mandar bodies crudos a un sistema multi-tenant, y todavía más a compartir credenciales de base de datos con un tercero.
Separando payload de orquestación, la base de datos del cliente nunca sale de su infraestructura. El relay o control plane trabaja con job IDs, códigos de status y clases de error, no con contenido. Eso no elimina tus obligaciones regulatorias (seguís siendo responsable del dato), pero sí reduce cuántos terceros tocan información sensible.
¿Qué es el patrón bring your own database para webhooks y en qué se diferencia de un router hosted?
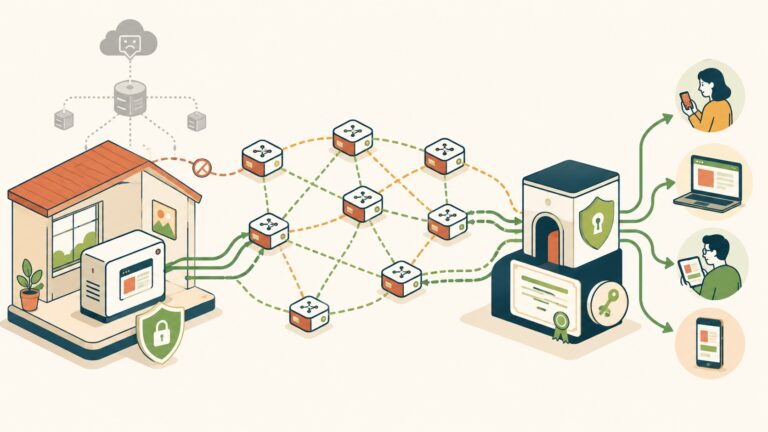
El patrón bring your own database para webhooks divide la arquitectura en dos planos: un plano de datos (infraestructura del cliente, con PostgreSQL y workers) y un plano de orquestación (routing, retry policy, alertas, dashboards) que solo ve metadata. Un router hosted tradicional, en cambio, concentra ambas cosas en el mismo sistema multi-tenant. Relacionado: convertir issues de GitHub a markdown.
Hay un detalle que condiciona todo el diseño: los proveedores firman los bytes exactos del cuerpo del request. Eso obliga a verificar la firma donde esos bytes todavía existen intactos. Hay dos formas de honrar “el orquestador nunca guarda el payload”:
- Ingress del cliente: el webhook del proveedor apunta directo a un endpoint que vos hospedás. Verifica la firma, escribe el evento en tu base y reporta metadata al control plane.
- Relay pass-through: un relay recibe el request, lo verifica y lo reenvía a tu ingress sin persistir el body. Ojo con esto: el relay sigue viendo los bytes en memoria durante el tránsito, así que es una garantía más débil que “nunca posee el payload”. Hay que describirla así, sin inflarla.
¿Y qué pasa con la soberanía de datos versus el cumplimiento normativo? Son cosas distintas. La soberanía de datos es dónde vive físicamente y quién controla el acceso al dato. El cumplimiento normativo es si cumplís HIPAA, GDPR o PCI DSS. Podés tener soberanía total (el dato nunca salió de tu PostgreSQL) y seguir siendo responsable de cumplir la norma igual. BYODB reduce el alcance, no reemplaza el programa de compliance.
¿Cómo se diseña el esquema de PostgreSQL para eventos y trabajos de webhooks?
El esquema propuesto usa dos tablas en un schema dedicado (webhook_ingress): events para guardar el payload crudo, y jobs para la cola de procesamiento con leasing. Usa gen_random_uuid(), que viene incluida en el core de PostgreSQL desde la versión 13, así que la extensión uuid-ossp ya no hace falta solo para generar UUIDs aleatorios.
En events, lo relevante es:
- raw_body BYTEA: guarda los bytes exactos firmados, no una versión parseada.
- uk_provider_external_id: constraint único sobre
(provider, external_event_id)que evita duplicar el mismo evento si el proveedor lo reenvía. - signature_verified: booleano que deja rastro de si esa fila pasó la verificación antes de insertarse.
En jobs, el diseño gira alrededor del leasing: status con check constraint (pending, leased, completed, failed, dead_letter), lease_expires_at, next_attempt_at para el backoff y max_attempts para cortar reintentos infinitos. Un índice parcial (idx_jobs_claimable) filtra solo las filas con status pending o leased, así el conjunto que se escanea en cada polling se mantiene chico aunque se acumulen miles de jobs completados.
¿Por qué el cuerpo raw del webhook se guarda como bytea y no como JSONB?
Porque la verificación de firma necesita los bytes originales, y JSONB no preserva espacios en blanco, orden de claves ni claves duplicadas. Si guardás el body parseado y después intentás reverificar la firma contra esa versión “limpia”, no va a coincidir. Más contexto en auditar registros DNS antes de migrar.
Stripe firma el payload exacto y manda la firma en el header Stripe-Signature junto con un timestamp. Según la guía de firmas de Stripe, la verificación requiere pasar el body crudo, el valor de ese header y el endpoint secret a la función de la librería correspondiente. Si tu framework reordena claves, agrega o quita whitespace, o convierte el body antes de que tu código lo vea (algo típico en Express si express.json() corre antes de la ruta del webhook), la verificación falla con un error de firma que no tiene nada que ver con que el secret esté mal.
Por eso el patrón guarda el raw_body como BYTEA para auditoría y replay, y deja una columna JSONB aparte, opcional, solo para cuando necesitás consultar campos puntuales sin tocar el original.
¿Cómo funciona FOR UPDATE SKIP LOCKED para encolar trabajos sin Redis?
Sí, se puede usar PostgreSQL como cola de trabajos sin Redis. SKIP LOCKED está en la documentación de PostgreSQL desde la versión 9.5: las filas que no se pueden bloquear de inmediato se saltean en vez de esperar, así cada worker termina procesando un subconjunto distinto de filas disponibles.
La query de claim selecciona hasta un puñado de jobs pendientes y vencidos (o leaseados con lease expirado), los bloquea con FOR UPDATE SKIP LOCKED dentro de un CTE, y en la misma statement los marca como leased con un nuevo lease_holder_id y lease_expires_at. Correrlo como una sola statement importa: si el lock se toma en una transacción y el update pasa en otra, el lock se libera en el primer commit y otro worker puede agarrar la misma fila.
Cuando un job falla, el backoff se calcula con interval '30 seconds' * power(2, attempt_count), exponencial, y si attempt_count llega a max_attempts, la fila pasa a dead_letter. Hay un caso borde que conviene cubrir con un reaper periódico: si un worker se cae justo en su último intento, su fila queda leased para siempre porque la query de claim saltea los jobs que ya agotaron intentos. Un job con reintentos periódico que busque leases vencidos con attempt_count >= max_attempts y los pase a dead_letter cierra ese agujero.
¿Qué roles y permisos mínimos necesita este patrón en PostgreSQL?
Necesita roles separados para ingress y workers, con grants de columna, no de tabla completa. El rol webhook_ingress_writer solo tiene INSERT sobre events y jobs: nada de lectura, update ni delete. El rol webhook_worker tiene SELECT sobre ambas tablas, pero el UPDATE sobre jobs está limitado a columnas puntuales (status, lease_holder_id, lease_expires_at, next_attempt_at, attempt_count, last_error, updated_at).
Hay un detalle fácil de pasar por alto: si usás INSERT ... ON CONFLICT DO NOTHING para evitar duplicados por el constraint único, PostgreSQL exige SELECT sobre las columnas del conflict target. Así que el rol de ingress necesita, además del INSERT, un GRANT SELECT (provider, external_event_id) puntual, aunque en teoría “solo inserta”. Cubrimos ese tema en detalle en parsers de webhooks sin allocation con SIMD.
TRUNCATE, DELETE, DROP y el DDL son privilegios separados que ninguno de estos grants incluye, y un rol que no es owner de la tabla no puede alterar el schema.
¿Qué metadata puede ver la capa de orquestación y qué nunca debe recibir?
Puede ver job ID, status, cantidad de intentos, duración, una clase de error gruesa y timestamps. Nunca debe recibir payload bodies, headers completos, identificadores de clientes metidos en mensajes de error, ni stack traces que puedan filtrar campos del payload por accidente.
Hay un matiz que se suele subestimar: campos como provider y event_type parecen inofensivos, pero pueden revelar actividad de negocio (que un cliente usa Stripe para cobros, por ejemplo). Bajo GDPR, un identificador que se puede linkear a una persona cuenta como dato personal, aunque sea “solo metadata”. Si eso le importa al cliente, la solución es usar job IDs opacos y dejarlo optar por no reportar el tipo de evento.
¿Cuáles son los límites reales del patrón bring your own database?
El límite más importante es que el relay pass-through no es una garantía de “nunca posee el payload”: sigue viendo los bytes en memoria durante el tránsito. Es una garantía más débil que el ingress hospedado por el cliente, y hay que comunicarla así, sin maquillarla como algo que no es.
El segundo límite es el modelo de entrega. SKIP LOCKED da menos espera por locks y recuperación ante caídas (si un worker muere, su lease vence y otro lo retoma), pero entrega at-least-once, no exactly-once. Un worker lento pero vivo puede seguir procesando cuando su lease ya venció, así que los handlers tienen que ser idempotentes, y conviene poner el lease más largo que el peor caso de procesamiento o extenderlo con un heartbeat. Te puede servir nuestra cobertura de hacer deploys sin downtime en Kubernetes.
El tercer límite es de volumen. Una cola basada en Postgres funciona bien para equipos que ya corren Postgres y manejan volumen moderado. Para volúmenes muy altos, probablemente haga falta particionar la tabla de jobs, vacuuming agresivo, o directamente un broker dedicado. Eso hay que benchmarquearlo con la carga real, no con el número de un blog.
BYO database vs router hosted: tabla comparativa
| Aspecto | Router hosted multi-tenant | Patrón BYO database |
|---|---|---|
| Dónde vive el payload crudo | Datastore del proveedor, compartido entre clientes | PostgreSQL propio del cliente |
| Quién verifica la firma | El proveedor, en su infraestructura | El cliente, en su ingress o en el relay (con la salvedad del pass-through) |
| Alcance de compliance | Incluye al vendor como procesador de datos (BAA/DPA según norma) | Se reduce al relay, que solo ve metadata |
| Cola de trabajos | Gestionada centralmente por el proveedor | PostgreSQL con FOR UPDATE SKIP LOCKED, sin broker externo |
| Riesgo de confianza para seguridad | Alto: hay que compartir bodies o credenciales con un tercero | Bajo: el dato nunca sale del perímetro del cliente |
Errores comunes al implementar bring your own database para webhooks
- Guardar el payload como JSONB en vez de bytea: parece más prolijo para consultar, pero si necesitás reverificar una firma más adelante (auditoría, disputa de pago) ya perdiste los bytes exactos. La corrección es guardar siempre el raw body como bytea y, si querés, agregar una columna JSONB aparte solo para queries.
- Correr el claim y el update en transacciones separadas: esto rompe la garantía de
SKIP LOCKEDporque el lock se libera en el primer commit. La corrección es que el claim sea una sola statement o viva dentro de una única transacción. - Dar permisos de tabla completa en vez de columna: otorgar
UPDATEsin especificar columnas le permite a un worker comprometido tocar cualquier campo, incluidoraw_body. La corrección es el grant de columna puntual que muestra el esquema original. - Olvidarse del reaper para leases vencidos en el último intento: sin ese job periódico, filas que agotaron reintentos quedan
leasedpara siempre y nunca llegan adead_letter. La corrección es correr esa query de limpieza con un cron.
Preguntas Frecuentes
¿Qué es el patrón Bring Your Own Database (BYOD) para webhooks?
Es un esquema de arquitectura donde el payload crudo del webhook se guarda únicamente en una base de datos que controla el cliente (típicamente PostgreSQL), mientras una capa de orquestación externa solo recibe metadata operativa como job ID, status y timings. El objetivo es reducir el alcance de compliance frente a normas como HIPAA, GDPR y PCI DSS.
¿Cómo se verifica la firma de un webhook de Stripe?
Se verifica pasando el body crudo del request, el header Stripe-Signature y el endpoint secret a la función de la librería de Stripe correspondiente (por ejemplo Stripe::Webhook.construct_event en Ruby). El error más común es usar el endpoint secret equivocado o dejar que el framework modifique el body antes de la verificación.
¿Se puede usar PostgreSQL como cola de trabajos sin Redis?
Sí, usando FOR UPDATE SKIP LOCKED, disponible desde PostgreSQL 9.5, que permite que distintos workers reclamen filas distintas de una tabla sin bloquearse entre sí. Funciona bien para volumen moderado; para volúmenes muy altos puede hacer falta particionar la tabla o sumar un broker dedicado.
¿Qué datos no debería ver la capa de orquestación de webhooks?
No debería ver payload bodies, headers completos, identificadores de clientes embebidos en mensajes de error ni stack traces que puedan filtrar campos del payload original. Solo debería recibir job ID, status, cantidad de intentos, duración y una clase de error gruesa.
¿Qué diferencia hay entre soberanía de datos y cumplimiento normativo (GDPR, HIPAA, PCI DSS)?
La soberanía de datos se refiere a dónde vive físicamente el dato y quién controla el acceso, mientras que el cumplimiento normativo se refiere a si cumplís las obligaciones legales de HIPAA, GDPR o PCI DSS sobre ese dato. Tener soberanía total (el dato nunca sale de tu infraestructura) reduce el alcance de terceros involucrados, pero no te exime de cumplir la norma igual.
Conclusión
Lo que cambia con este patrón no es la tecnología de PostgreSQL (SKIP LOCKED existe desde la versión 9.5), sino cómo se reparte la responsabilidad entre quién guarda el dato y quién orquesta el flujo. Para un equipo que maneja datos de salud, financieros o PII, ese reparto importa más que cualquier benchmark de throughput.
Antes de adoptarlo, valdría la pena verificar un criterio concreto: pedile al proveedor de orquestación que te muestre, en texto plano, el payload exacto de lo que le llega a su sistema cuando procesás un evento de prueba. Si ahí aparece algo que no sea job_id, status, timings o error_class, el “nunca ve el payload” es solo marketing.
El patrón no elimina tu programa de compliance ni te saca de encima la responsabilidad legal. Reduce cuántos terceros tocan el dato crudo, que ya es una ganancia real cuando el auditor pregunta quién tuvo acceso a qué.