Pool de conexiones Supabase: cómo evitar el error de slots
En pocas palabras: Para evitar el error «remaining connection slots are reserved» en Supabase, conectá tus funciones serverless de Next.js 15 al pooler compartido (Supavisor) en modo transacción, puerto 6543, con un pool de cliente de 1 conexión por instancia y prepared statements desactivados. Reservá el puerto 5432 para migraciones.
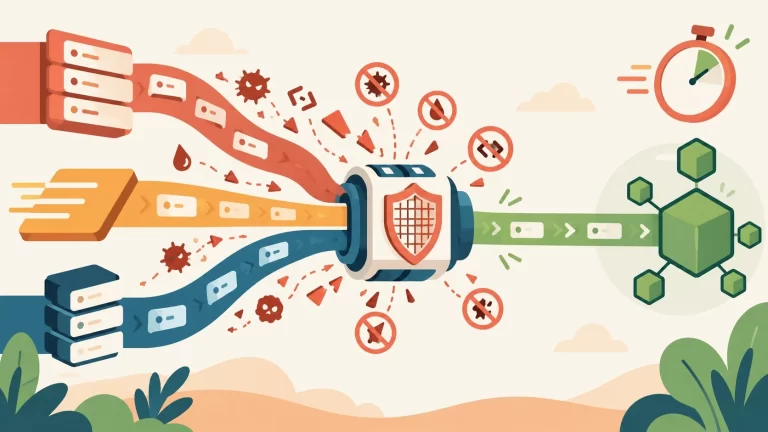
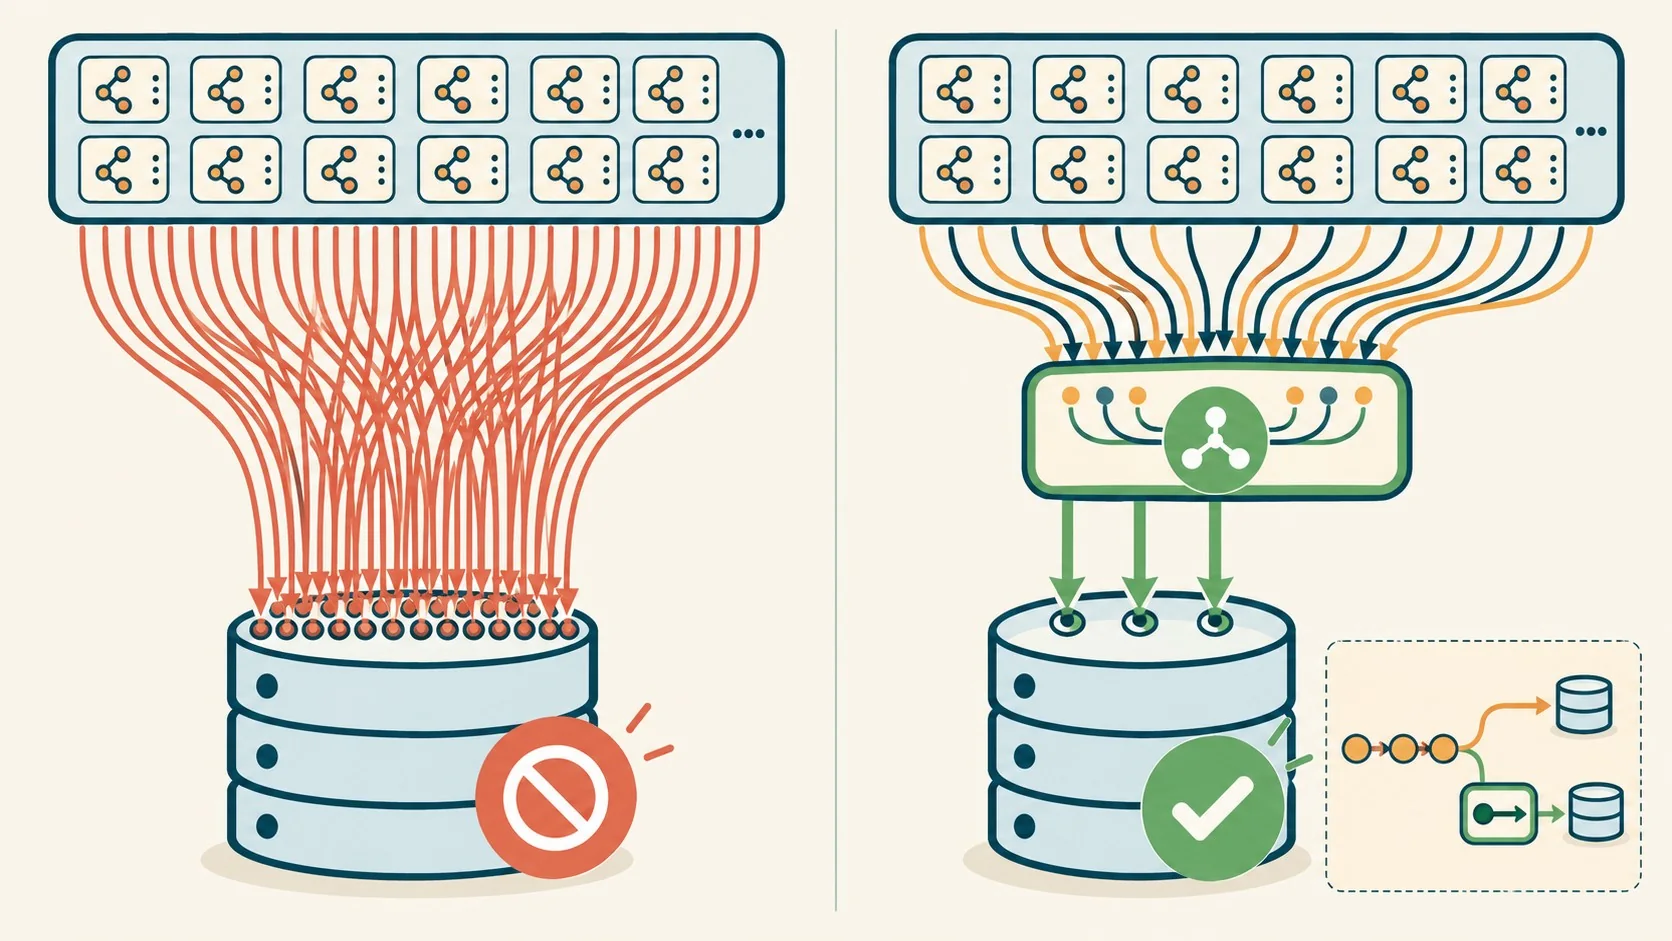
El error remaining connection slots are reserved aparece cuando tus funciones serverless de Next.js abren conexiones directas a Postgres y agotan el máximo. La receta que documenta Supabase para el pool de conexiones Supabase es usar el modo transacción (puerto 6543) con un pool de cliente de 1 conexión por instancia.
Un pool de conexiones en Supabase es una capa intermedia (Supavisor o PgBouncer, según el modo) que recibe muchas conexiones cortas de tu aplicación y las reutiliza contra pocas conexiones reales a Postgres. Sirve para que las funciones serverless y edge no agoten el máximo de la base, y le importa a quien despliega en Vercel o AWS Lambda sobre Supabase.
En este artículo:
- En 30 segundos
- ¿Qué significa el error «remaining connection slots are reserved» en Supabase?
- ¿Cuándo usar Supavisor en modo transacción (puerto 6543) y cuándo la conexión directa?
- ¿Qué limitaciones tiene el modo transacción de Supavisor?
- ¿Sigue valiendo connection_limit=1 con Fluid compute en Vercel?
- ¿Cómo proteger Postgres de las consultas pgvector bajo carga?
- ¿Qué está confirmado y qué falta verificar?
- Errores comunes con el pool de conexiones Supabase
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El síntoma: un post de dev.to del 7 de octubre de 2026 describe 500 Route Handlers que abren conexiones directas y disparan el FATAL en 40 segundos (es un escenario del autor, no una medición).
- La salida oficial: la doc de Supabase manda el código serverless al pooler compartido en modo transacción, puerto 6543.
- El costo: ese modo no soporta prepared statements ni query pipelining, y pierde el estado de sesión.
- Un desliz del post: su DIRECT_URL apunta al pooler en el 5432, que es modo sesión y no una conexión directa.
- Lo que falta: ninguna fuente que leí valida connection_limit=1 para Fluid compute, así que medilo vos.
¿Qué significa el error «remaining connection slots are reserved» en Supabase?
Significa que Postgres llegó a su tope de conexiones y solo quedan los cupos reservados para superusuarios, así que rechaza a cualquier otro cliente. El mensaje completo es FATAL: remaining connection slots are reserved for non-replication superuser connections. Los usuarios activos quedan afuera y las colas de ingesta se frenan, según el post de dev.to del 7 de octubre de 2026.
El escenario del post: 3:14 de la mañana de un martes, una ráfaga de webhooks levanta 500 Route Handlers de Next.js 15 y cada uno abre su conexión directa. A los 40 segundos, el FATAL. Es un caso ilustrativo del autor, sin método ni métricas publicadas.
¿Por qué Next.js en serverless agota las conexiones de Postgres?
Porque cada instancia serverless inicializa su propio pool y ninguna sabe cuántas hay vivas. Según el mismo post, 200 contenedores con un pool de 5 conexiones cada uno suman 1.000 conexiones, cada una con su handshake TCP y SSL. Le pasa a cualquier runtime que escale instancias sin estado, como Vercel o AWS Lambda, no solo a Next.js 15. Más contexto en desplegar tu proyecto gratis en Vercel.
El autor suma que cada proceso de backend de Postgres ocupa unos 10 MB de RAM. Esa cifra no figura en la documentación de Supabase que revisé, así que tomala como estimación suya. Lo que sí dice la doc oficial de conexión es que tu librería cliente tiene su propio pool, aparte del pooler de Supabase, y que sus valores por defecto asumen un backend persistente: Postgres.js arranca con 10 conexiones por instancia caliente, y vos no controlás cuántas instancias hay.
Ahí está la trampa.
Subís el código a Vercel, lo probás con tres requests, anda perfecto, llega la ráfaga de webhooks, cada instancia abre su pool completo y a las tres de la mañana te enterás por el celular de que nadie calculó cuántas instancias podían estar vivas a la vez.
¿Cuándo usar Supavisor en modo transacción (puerto 6543) y cuándo la conexión directa?
Usá el modo transacción del pooler compartido (puerto 6543) para funciones serverless y edge, y la conexión directa (puerto 5432) para backends persistentes y migraciones. Supavisor es el pooler compartido de Supabase (el post lo describe como un pooler basado en Elixir). El modo sesión, también en el 5432 pero sobre el host del pooler, es para redes solo IPv4 y herramientas de terceros.
| Modo | Host:puerto | Cuándo usarlo | IP |
|---|---|---|---|
| Conexión directa | db.[PROJECT-REF].supabase.co:5432 | Backends persistentes, migraciones, pg_dump, replicación | IPv6 (IPv4 con add-on) |
| Pooler compartido, sesión | aws-[INDEX]-[REGION].pooler.supabase.com:5432 | Backend persistente en red solo IPv4, herramientas de terceros | IPv4 |
| Pooler compartido, transacción | aws-[INDEX]-[REGION].pooler.supabase.com:6543 | Funciones serverless y edge | IPv4 |
| Pooler dedicado (planes pagos) | db.[PROJECT-REF].supabase.co:6543 | Apps de alto rendimiento, menos latencia | IPv6 (IPv4 con add-on) |
La tabla sale de la misma doc de Supabase. Ahora, el DIRECT_URL del post apunta a aws-0-[region].pooler.supabase.com:5432. Eso es modo sesión del pooler, no conexión directa. Sirve si tu CI corre en una red IPv4, pero para migraciones la doc recomienda la conexión directa, así que decidí sabiendo qué estás usando.
Si tu backend es persistente (un VPS, por ejemplo; en Argentina podés mirar opciones en donweb.com), la doc indica conexión directa. Revisá que tu servidor salga por IPv6 o sumá el add-on IPv4.
¿Qué limitaciones tiene el modo transacción de Supavisor?
El modo transacción devuelve la conexión al pool al terminar cada transacción, y por eso no soporta prepared statements ni query pipelining, y pierde el estado de sesión. Según la doc oficial, las tablas temporales, los SET, los advisory locks de sesión y LISTEN/NOTIFY no sobreviven entre transacciones, y los cursores WITH HOLD tampoco.
Para desactivar los prepared statements, cada driver tiene su ajuste:
- Postgres.js y Drizzle:
prepare: false. - Prisma:
pgbouncer=trueen la cadena de conexión (es un parámetro de Prisma, no de Supavisor). - asyncpg:
statement_cache_size=0. - JDBC:
prepareThreshold=0.
El ejemplo de la doc para un cliente serverless con Postgres.js, creado una sola vez a nivel de módulo: En comparativa de costos entre Vercel y Amplify profundizamos sobre esto.
import postgres from 'postgres'

export const sql = postgres(process.env.DATABASE_URL, {
 max: 1,
 prepare: false,
 ssl: 'require',
})
Ojo con una combinación: Postgres.js hace pipelining por defecto, y según la doc eso en modo transacción puede colgar consultas o devolver filas cruzadas.
El dilema que plantea el post es real: rediseñar las transacciones con tokens de idempotencia en la aplicación, o pagar más cómputo para usar modo sesión. Antes de elegir, revisá si de verdad usás advisory locks de sesión o LISTEN. Si no, el modo transacción probablemente te alcance.
Una aclaración sobre el cliente «resiliente» del post. Usa createClient de supabase-js, y la doc dice que las librerías cliente de Supabase envuelven las Data APIs (REST). Mi inferencia: ese código no abre conexiones Postgres desde tu función, y su timeout de 4.500 ms corta requests colgados pero no toca ningún pool.
¿Sigue valiendo connection_limit=1 con Fluid compute en Vercel?
Depende de cómo corra tu código, y las dos guías no dicen lo mismo. Supabase indica un pool de 1 conexión por instancia warm en serverless y subirlo solo si hay evidencia de invocaciones concurrentes haciendo cola. La guía de Vercel para Fluid compute propone un pool normal con attachDatabasePool de @vercel/functions.
El ejemplo de Vercel crea un Pool de pg con POSTGRES_URL, llama a attachDatabasePool(pool), toma un cliente con pool.connect() y lo libera en un finally. Vercel dice que la función administra el pooling de clientes soportados, entre ellos pg, MySQL2, MongoDB e ioredis. Tema relacionado: por qué se agotan las conexiones Postgres.
Mi lectura, y es inferencia porque la página no lo dice: si una instancia de Fluid compute atiende invocaciones concurrentes, un pool de 1 las pone en fila; si atiende una por vez, con 1 alcanza. Además, connection_limit es un parámetro de Prisma, no una perilla universal.
Sobre el pool de Supavisor, la doc de gestión de conexiones sugiere no pasar del 40% del máximo de conexiones de la base si usás mucho la API de PostgREST, y hasta 80% en otros casos. Su ejemplo: con un máximo de 500 y solo 80 conexiones usadas en una semana, podrías asignar la diferencia de 420, menos un margen. El límite correcto depende de tu plan de cómputo, y no voy a inventarte números por plan.
Cómo verificarlo (propuesta editorial, no probada por nosotros)
- Corré una prueba de carga en staging con el patrón de ráfagas que te preocupa.
- Agrupá las sesiones mientras corre, con la consulta de abajo, que usa
pg_stat_activitycomo indica la doc. - Mirá el estado idle in transaction: según la doc, casi siempre significa que la aplicación olvidó commit o rollback.
- Compará el total contra el máximo de tu plan. En Teams y Enterprise tenés el gráfico Database client connections.
- Subí el pool de a una conexión y solo si ves consultas esperando.
select usename, application_name, state, count(*)
from pg_stat_activity
where datname = current_database()
group by 1, 2, 3
order by 4 desc;
¿Cómo proteger Postgres de las consultas pgvector bajo carga?
Poné un tope de tiempo a las funciones RPC de búsqueda vectorial y cacheá las lecturas repetidas. El post propone un statement_timeout de 2.500 ms dentro de match_documents (una función sobre vector(1536) con índice HNSW) y un caché de lecturas para prompts idénticos, para que una búsqueda lenta no bloquee escrituras OLTP.
Eso sí: el SET LOCAL vive lo que dura la transacción, así que no depende del estado de sesión que el modo transacción pierde. Aun así, probalo con una consulta lenta en staging antes de confiar en que corta a los 2,5 segundos. El 30% de consultas con intención similar es un supuesto del autor, y los «cientos de dólares» de ahorro no vienen con datos.
El post incluye una divulgación: la infraestructura y los benchmarks multimodelo están patrocinados por b-lost.com, un gateway de IA que se presenta con precios a 0.8x del oficial. Afirma que sus métricas salen de pruebas independientes reproducibles. ¿Publica método o resultados? No en lo que leí. Tomalo con pinzas. Esto se conecta con lo que analizamos en la trampa de sumar más conexiones a la base.
¿Qué está confirmado y qué falta verificar?
Confirmado en la documentación oficial:
- Serverless y edge van por el pooler compartido en modo transacción, puerto 6543.
- El modo transacción no soporta prepared statements ni query pipelining.
- El cliente serverless se crea a nivel de módulo, con pool de 1, prepared statements apagados y SSL en require.
- La regla 40% y 80% para dimensionar el pool de Supavisor.
- El uso de attachDatabasePool en Fluid compute, según la guía de Vercel.
Sin confirmar:
- Los 10 MB de RAM por backend y el escenario de 500 Route Handlers en 40 segundos: son del autor, sin método.
- El 30% de consultas similares y los benchmarks de b-lost.com.
- connection_limit=1 en Fluid compute: ninguna fuente lo valida.
- Que Vercel desaconseje fijar el máximo en 1 y recomiende rolling releases: no aparece en el texto que leí, así que verificalo en la guía completa antes de afirmarlo.
Errores comunes con el pool de conexiones Supabase
- Armar el host del pooler a mano. La doc aclara que el índice del host no se deduce de la región. Copialo del botón Connect del dashboard.
- Usar el usuario postgres en el pooler compartido. Ahí el usuario es
postgres.[PROJECT-REF]. Si te equivocás, la doc lista el error «Tenant or user not found». - Dejar los prepared statements activos en modo transacción. Apagalos según tu driver (tabla de arriba).
- Confiar en el pool por defecto. Subirlo «por las dudas» multiplica las conexiones por cada instancia caliente.
Preguntas Frecuentes
¿Por qué me aparece el error remaining connection slots are reserved en Supabase?
Porque Postgres alcanzó su máximo de conexiones y solo quedan los cupos reservados para superusuarios. En Next.js sobre Vercel o Lambda suele pasar cuando muchas instancias abren conexiones directas al puerto 5432. Pasá a la cadena del pooler compartido en modo transacción (6543) y revisá el tamaño del pool de tu cliente.
¿Qué diferencia hay entre el puerto 5432 y el 6543 en Supabase?
El 5432 es la conexión directa a Postgres o, sobre el host del pooler, Supavisor en modo sesión. El 6543 es Supavisor en modo transacción en el pooler compartido y PgBouncer en el pooler dedicado de los planes pagos, según la doc oficial.
¿Qué es Supavisor y cuándo conviene el modo transacción?
Supavisor es el pooler compartido de Supabase. El modo transacción conviene en funciones serverless y edge, que abren muchas conexiones cortas, siempre que apagues los prepared statements y no dependas de estado de sesión.
¿Cómo conecto Next.js con Supabase sin quedarme sin conexiones?
Si usás supabase-js vas por las Data APIs (REST) y no abrís conexiones Postgres desde tu función. Si usás SQL crudo u ORM, tomá la cadena del Transaction pooler en el botón Connect, creá el cliente a nivel de módulo con pool de 1, prepared statements apagados y SSL en require.
¿Conviene usar connection_limit=1 en Vercel con Fluid compute?
Es el punto de partida que Supabase recomienda para serverless, pero ninguna fuente que leí lo valida para Fluid compute. Probalo con una prueba de carga y subí el pool solo si ves consultas haciendo cola.
Conclusión
El post de dev.to del 7 de octubre de 2026 pone un problema conocido en un escenario dramático, y la doc de Supabase del 8 de octubre ya trae la configuración concreta. Lo que sirve: pooler compartido en modo transacción, pool de cliente de 1, prepared statements apagados y SSL en require. Lo que no tiene respaldo: los números del autor, los benchmarks patrocinados y connection_limit=1 para Fluid compute. Armá una prueba de carga en staging, mirá pg_stat_activity y decidí con tus datos.
Fuentes
- Supabase Docs – Connect to your database: métodos de conexión, puertos y configuración del cliente
- Supabase Docs – Connection management: tamaño del pool y monitoreo de conexiones
- Vercel Knowledge Base – Manejo de pools de conexiones con Fluid compute
- dev.to – Scaling Supabase with Next.js 15: Surviving the Serverless Postgres Connection Cliff (post patrocinado)